
Schema结构化数据标记指南:怎么让搜索引擎一眼看懂你的网页
很多做站的朋友经常问我:明明文章写得很扎实,网站打开速度也优化到了极致,为什么搜索结果里的展示还是干瘪瘪的?甚至排名也一直卡在第二页上不去?其实很多时候不是你的内容不行,而是现在的搜索引擎爬虫每天要处理海量数据,它们没耐心去“猜”你的文章讲了什么。今天我就以一线运维和SEO实战的角度,给大家梳理一份接地气、拿来就能用的Schema结构化数据标记指南,帮你打通从代码部署到流量爆发的这一关。
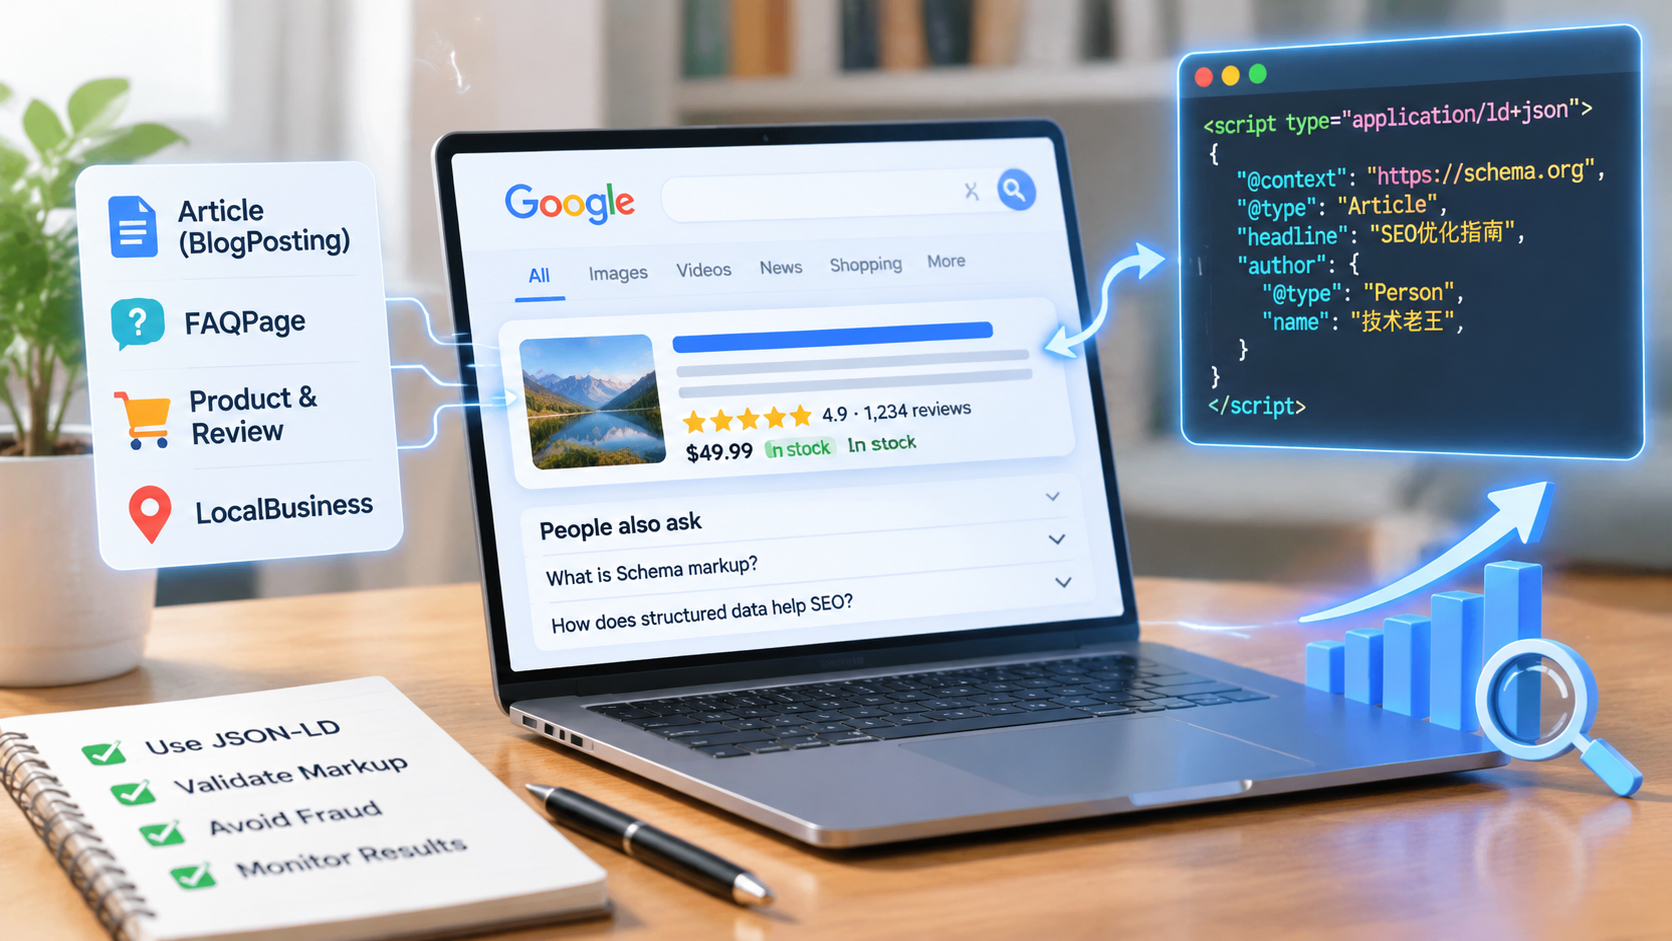
一、 扒掉外壳:Schema 到底是个什么玩意?
如果你把网页比作一份给人类看的“精装菜单”,有图片、有花哨的排版,那么 Schema 结构化数据就是你塞给后厨(搜索引擎爬虫)的一张“纯文本配料表”。
搜索引擎虽然越来越聪明,甚至已经接入了大语言模型,但它们抓取网页时本质上还是在解析 HTML。一段普通的文字:
“张三在2023年写了《Python入门》,售价50元,好评率98%。”
人类一眼看懂,但爬虫需要通过复杂的自然语言处理(NLP)去猜:谁是作者?50是人民币还是美元?98%是点赞还是好评?
而 Schema.org 规范就是全球几大搜索引擎(Google、Bing、Yahoo 等)共同制定的一套通用语法字典。你用这套字典把数据标明:
author: 张三price: 50currency: CNYratingValue: 4.9
爬虫抓到这些标记时,完全不需要“猜”,瞬间就能把核心事实提取出来存入知识图谱。最直观的收益就是,你的搜索结果很可能会变成包含星级评分、常见问答(FAQ)、价格标签、作者头像的“富文本摘要”(Rich Snippets),在搜索结果页里极其抓人眼球,点击率(CTR)往往能提升 20% 到 40% 不等。
二、 别瞎忙活:哪些类型的 Schema 最值得做?
Schema.org 里的词汇库有成百上千种,中小网站没必要全做,不仅费时费力,做错了还可能被算法判定作弊。根据我的实战经验,优先把以下几种跑通,性价比最高:
1. 基础门面:Article / BlogPosting(文章类型)
只要你做内容站,这是必选项。它能告诉搜索引擎文章的标题、主图、发布时间、修改时间以及最重要的——作者是谁。在如今 Google 极其看重 E-E-A-T(经验、专业、权威、可信)的算法环境下,把作者信息用 Schema 和作者的个人主页、社交媒体绑定,是建立网站权威度的核心手段。
2. 霸占屏幕:FAQPage(常见问答)
这是我做 SEO 屡试不爽的提权神器。如果你的文章包含“问答”板块,打上 FAQPage 标记,搜索结果下方就有概率直接展开 2-3 个折叠问答。这不仅大幅挤压了竞争对手在手机屏幕上的展示空间,还能直接解答用户疑问,信任感直接拉满。
3. 电商与转化利器:Product & Review(产品与评价)
做独立站或者评测博客的标配。把价格、库存状态(InStock)、用户打分标记出来,搜索结果直接显示五星好评和价格区间,进来的流量基本都是高意向的精准转化人群。
4. 本地权重:LocalBusiness(本地企业)
如果你有实体店或者做特定区域的外贸服务,这个标记必须配上你的地址、电话、营业时间,它直接决定了你在本地搜索和地图包(Map Pack)里的曝光权重。
三、 实战上手:别再用淘汰的写法了
目前主流的 Schema 标记方式有三种:Microdata、RDFa 和 JSON-LD。
请记住:无脑选 JSON-LD 即可。这是 Google 官方推荐的做法。以前那种把代码七零八落插在 HTML 标签里的写法(Microdata)极难维护,页面改个版很容易把代码弄丢。而 JSON-LD 是一段独立的 JavaScript 脚本,通常塞在 <head> 或 <body> 的最底部,干净利索,完全不影响前端渲染。
这里贴一段最标准的文章类(Article)结合作者信息的 JSON-LD 模板,你可以直接根据网站情况替换内容:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "TechArticle",
  "headline": "运维老手带你搞定网站结构化数据标记",
  "image": [
    "https://example.com/images/16x9/cover.jpg"
  ],
  "datePublished": "2023-10-25T08:00:00+08:00",
  "dateModified": "2023-10-26T09:20:00+08:00",
  "author": [{
      "@type": "Person",
      "name": "技术老王",
      "url": "https://example.com/about-me"
    }],
  "publisher": {
    "@type": "Organization",
    "name": "极客运维笔记",
    "logo": {
      "@type": "ImageObject",
      "url": "https://example.com/logo.png"
    }
  },
  "description": "本文详解如何使用Schema结构化数据优化网站SEO表现,包含实战代码与避坑指南。"
}
</script>
四、 技术与AI流工作流:如何高效自动化部署?
手写一段代码容易,但站内成百上千篇文章,难道每篇都手工敲吗?作为懂点技术的站长,我们需要让流程自动化。
1. CMS 动态模板注入
如果你用 WordPress,市面上的 Rank Math 或 Yoast SEO 插件已经能自动生成基础的 Article Schema。但如果你用的是自研系统或者静态博客(如 Hugo、Hexo、Astro),你可以在文章的详情页模板中,利用模板变量动态提取 title、published_at、featured_image 等字段,拼接成上面的 JSON-LD 结构,全站一键生效。
2. 利用 AI 批量生成复杂模块(如 FAQ)
对于 FAQ 这种内容高度自定义的模块,插件往往照顾不到。我目前的日常工作流是: 在写完一篇文章后,把文案直接丢给 AI,输入提示词:
“请阅读以上文章,提炼出 3 个用户最关心的常见问题并作简短回答。直接输出符合 Schema.org 规范的 FAQPage 格式 JSON-LD 代码,不要输出任何多余废话。”
AI 输出后,运维人员只需要把这串代码粘贴到文章底部的自定义 HTML 块中,整个过程不超过两分钟。
五、 避坑与验证:做了标记为什么不生效?
很多人以为加了代码就万事大吉,过两天发现搜索结果毫无变化,甚至收到站长工具的警告邮件。这里有几个关键雷区一定要注意:
-
别玩“阴阳合同”(数据欺诈)
这是死罪。页面上明明没写价格,你在 Schema 里标了个“1元包邮”;页面上没有评价,你代码里硬塞“5星好评”。搜索引擎一旦核对发现代码内容与页面可见内容不一致,轻则富文本摘要被剥夺,重则整站面临人工惩罚。Schema 里的内容,必须在页面上能被肉眼看见。 -
时间格式要标准(ISO 8601)
别写“2023年10月”,爬虫跨时区解析很容易崩溃。规范的写法必须带时区,例如2023-10-25T08:00:00+08:00。 -
上线前必须用工具验证
代码部署完后,不要直接等收录。善用官方工具排查语法错误:- Google 富媒体搜索结果测试(Rich Results Test):直接输入 URL 或粘贴代码片段,它会告诉你页面支持哪些富媒体展示,缺少哪些必填项(Required fields)或建议项(Recommended fields)。
- Schema Markup Validator:检查底层语法结构是否合规。
总结
在生成式 AI 搜索(如 Google SGE、Perplexity)大行其道的今天,结构化数据的重要性不仅没有降低,反而在成倍上升。AI 爬虫在重组答案时,更倾向于抓取结构清晰、实体关系明确的信息源。
给网页部署 Schema 就像是给你的优质内容递上一张官方认证的名片。它不需要复杂的算法逆向,全靠踏踏实实的技术细节落地。如果你还没给网站打上标记,不妨挑出流量最高的十篇核心文章,按今天的方法实操一遍,接下来,就静等搜索控制台里的展示和点击曲线给你正向反馈吧。
相关文章
- 独立站内容营销SOP与原创度把控:独立站内容营销SOP:原创流量的底层逻辑
- 谷歌图片搜索SEO流量获取实战:别盯着文字卷了,图搜流量才是独立站的隐形金矿
- 独立站SEO效果监控与数据看板搭建:别被虚荣指标骗了:手把手教你搭独立站SEO实战看板
- Google核心网页指标Core Web Vitals实操优化:老站长带你死磕CWV性能优化
- 外贸独立站Hreflang多语言标签防踩坑配置:独立站Hreflang避坑实操指南
- WordPress搭配Nginx极致优化TTFB实操:压榨Nginx:WP秒开TTFB实战
- Google Search Console索引报错深度排查与修复:GSC索引报错深度排查实操指南
- 海外Guest Post外链开发与辨别黑心资源:老站长谈GP外链避坑与实操
- Ahrefs挖掘低竞争高转化商业意图长尾词:老站长用Ahrefs捡漏商业词实录
- 谷歌算法更新后流量断崖式下跌恢复指南:谷歌核心算法暴跌自救指南