
办公类AI大模型幻觉现象应对策略:AI写材料总瞎编?这几招管用
不知道你在平时的办公里有没有被大模型“坑”过?上周我们技术群里还有个做运营的朋友吐槽:让AI帮忙汇总一份竞品专利清单,结果它信誓旦旦地编了三个压根不存在的专利号,差点被领导当成工作造假。在大模型圈子里,我们管这种“一本正经胡说八道”叫模型幻觉。如果你正打算在团队内部推广AI工具,或者正在搭建内部知识库,那么摸索出一套切实有效的办公类AI大模型幻觉现象应对策略,就是保证企业降本增效而不翻车的生死线。
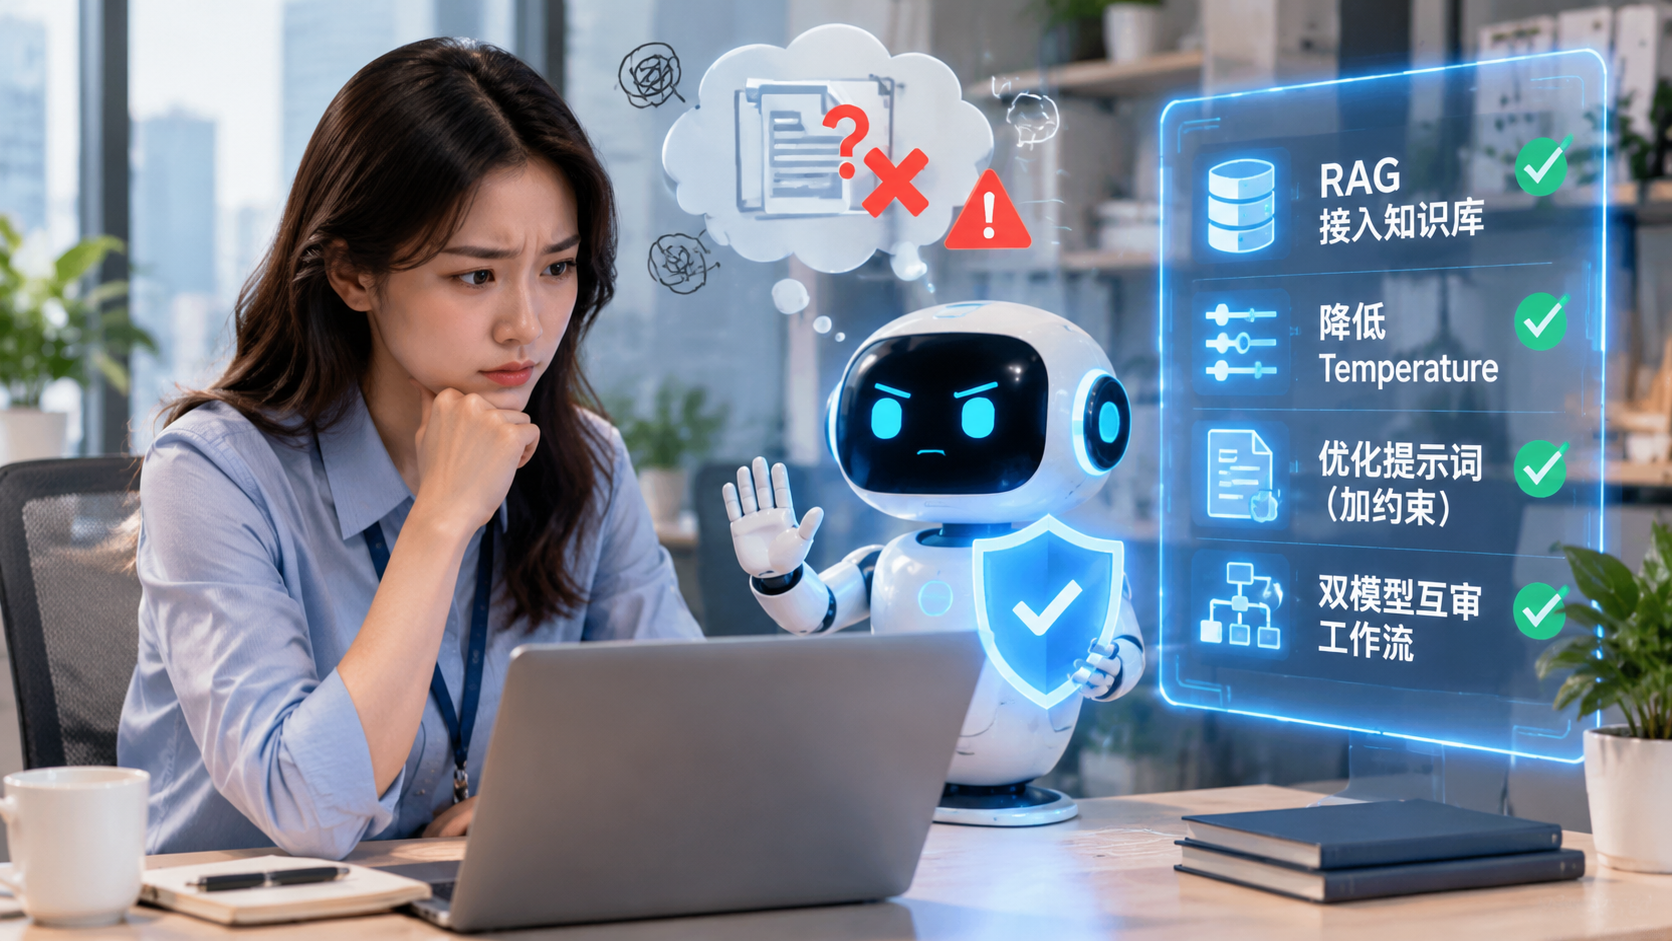
这篇文章我不跟你扯那些前沿的学术公式,结合我平时给企业做系统架构、SEO内容生产和AI运维落地的经验,直接把几套经过实战检验的“防胡说”打法掰开揉碎讲清楚。
一、 办公场景下的“胡说八道”到底是怎么来的?
先说句大实话:大模型的底层原理是概率生成,它本质上是个“根据上文猜下一个字”的语言接龙机器。它根本没有“事实”的概念,它在乎的是语言逻辑顺不顺畅。
在办公场景下,幻觉通常会在以下三个坑里爆发:
- 信息黑洞硬要填:你问它一个公司内部才有的报销流程,公网训练数据里根本没有,但出于“乐于助人”的底层设定,它会生搬硬套网上别人的流程糊弄你。
- 长篇大论顾头不顾尾:写几千字的长报告或者分析复杂Excel,Token长度一拉长,前面的约束条件它转头就忘。
- 数字和事实弱智症:让它润色文章它是大师,让它算财报比例、核对合同日期,它分分钟算错。
二、 实战篇:彻底压制AI幻觉的四套组合拳
想要彻底解决这个问题,光靠对AI说“请务必保证真实”是没用的,必须从技术运维和日常使用两个层面去“上夹板”。
1. 别让AI裸奔:上RAG(外挂本地知识库)
这是目前企业办公场景下,压制幻觉最彻底、也是技术性价比最高的方法。说白了,就是“开卷考试”。
以前是你问一句它凭记忆答一句,现在是我们先在公司内部文档(制度、产品手册、过往案例)里用向量算法把相关内容“捞”出来,然后拼进提示词里:“请严格根据以下参考资料回答,如果资料里没写,就直接说不知道。”
运维老手的避坑提醒: 做RAG不是把几十篇PDF直接丢进数据库就完事了。文档切片(Chunking)千万别切得太碎,太碎容易丢上下文;也别切太大,否则大模型抓不住重点。通常建议把切片大小控制在500-800字符,并保留10%的重叠度(Overlap)。
2. 动动参数:把那个叫“Temperature”的旋钮拧低点
很多非技术人员不知道,在调用API或者在一些高级后台里,有个叫“Temperature(温度/随机性)”的参数,默认通常是0.7到1.0左右。
- 写文案、头脑风暴:温度可以调到0.8,让它放飞自我,更有创意。
- 办公、查法条、算数据、写制度:直接把温度拉低到0.1甚至0!
把它拉到最低,AI就会选择概率最高、最保守的字词,虽然显得有点“死板”,但真实度会直线上升,杜绝放飞自我的胡编乱造。
3. 提示词改造:戴上“紧箍咒”
日常同事用大模型,最爱打字:“帮我写一份XX方案”。这种开放式指令简直就是给幻觉发邀请函。
试着把办公提示词改成下面这种结构化的写法:
【角色】:你是一名严谨的企业法务助理。
【任务】:审核附件中的合作协议风险。
【输入依据】:仅依据我提供的附件内容进行审查。
【负面约束】:
1. 绝对不要引用你记忆中的法律条款,只标注协议本身逻辑矛盾处。
2. 凡是文档中没有明确写出的时间、金额,在报告中一律标注为“缺失项”,严禁自行推测补全。
【输出格式】:采用表格输出:问题位置 | 风险描述 | 修改建议。加了负面约束(告诉它什么不能做)和零样本限制(没写就说不知道),幻觉发生的概率能当场砍掉大半。
4. 工作流分流:让AI给AI当“监工”
如果业务要求非常高(比如要做面向客户的方案),就不能指望单次交互解决问题,建议用工作流(比如Dify或Coze平台)搭一个双模型互审机制:
| 步骤 | 角色/节点 | 负责工作 | 防幻觉核心手段 |
|---|---|---|---|
| 第一步 | 生成模型(如GPT-4o/Claude) | 根据事实素材快速成稿 | 限制只输出初稿,不做定论 |
| 第二步 | 事实校验模型(配搜索工具) | 逐段核对初稿中的专有名词、数据 | 强制对比源文件,标出矛盾点 |
| 第三步 | 规则过滤器(Python脚本) | 正则匹配敏感词、虚假URL或格式错误 | 硬性拦截,不符合规范直接打回 |
三、 常见问题排查(FAQ)
Q:为什么用了外挂知识库(RAG),AI偶尔还是会编造事实? A: 检查两点:第一是检索召回率低,你存了文档,但用户的提问方式和文档里的关键词对不上,系统没捞出正确资料;第二是模型的“拒答阈值”设得太宽,必须在Prompt里严禁它“利用公网常识做推断”。
Q:有没有完全不产生幻觉的大模型? A: 目前全行业的技术水平,不存在零幻觉的大模型。所有声称自己“100%无幻觉”的都是宣传话术。解决幻觉的本质不是消灭幻觉,而是通过业务流程把它“锁在笼子里”,不让错误信息直接流向决策层或客户。
总结
其实说到底,大模型的幻觉不是什么见不得人的技术缺陷,它跟大模型的“创造力”是一体两面的东西。在办公室里用AI,技术部门不能光把工具甩给业务部门就撒手不管。配置好知识库、调低随机参数、规范Prompt模板,最后再加一层审核流程——只要这几道关卡立起来,AI胡说八道的问题基本就能被摁在萌芽状态,让它老老实实成为你手下靠谱的“数字打工人”。
相关文章
- AI自动生成PPT工具实测:站长实测:AI做PPT别再踩坑了
- Coze接入飞书搭建业务Bot:Coze接飞书搭业务Bot实操
- AI批量提取扫描件PDF数据:AI提取扫描件PDF数据实操
- AI批量清洗去重客户名单:名单去重与站长文案实操指南
- Cursor辅助编写日常运维脚本:Cursor写运维脚本实操指南
- 开源AI录音转文字私有化部署:搞定本地语音转文字与站长写作
- AI一键生成业务流程思维导图:老站长教你用AI秒画业务流程图
- AI自动审查合同关键条款风险:老站长聊AI审合同的避坑实操
- Claude长文本快速提炼行业报告:老站长用Claude啃透行业报告
- AI办公数据泄露风险与防范:别乱用AI办公了,数据正在被看光