
真假百度蜘蛛识别方法:一招彻底搞定真假百度蜘蛛识别
掌握真假百度蜘蛛识别方法的核心只有一条:绝对不能只看 User-Agent,必须通过双向 DNS 反向解析(nslookup / host 命令)校验 IP 真实性。 伪造浏览器请求头里的 User-Agent(UA)没有任何技术门槛,一行 Python 代码或者 Curl 参数就能伪装成百度蜘蛛。那些在你的网站日志里疯狂抓取却从不收录、甚至专门扫描 .env 或 wp-login.php 的“百度蜘蛛”,99% 都是披着羊皮的流氓爬虫和漏洞扫描器。
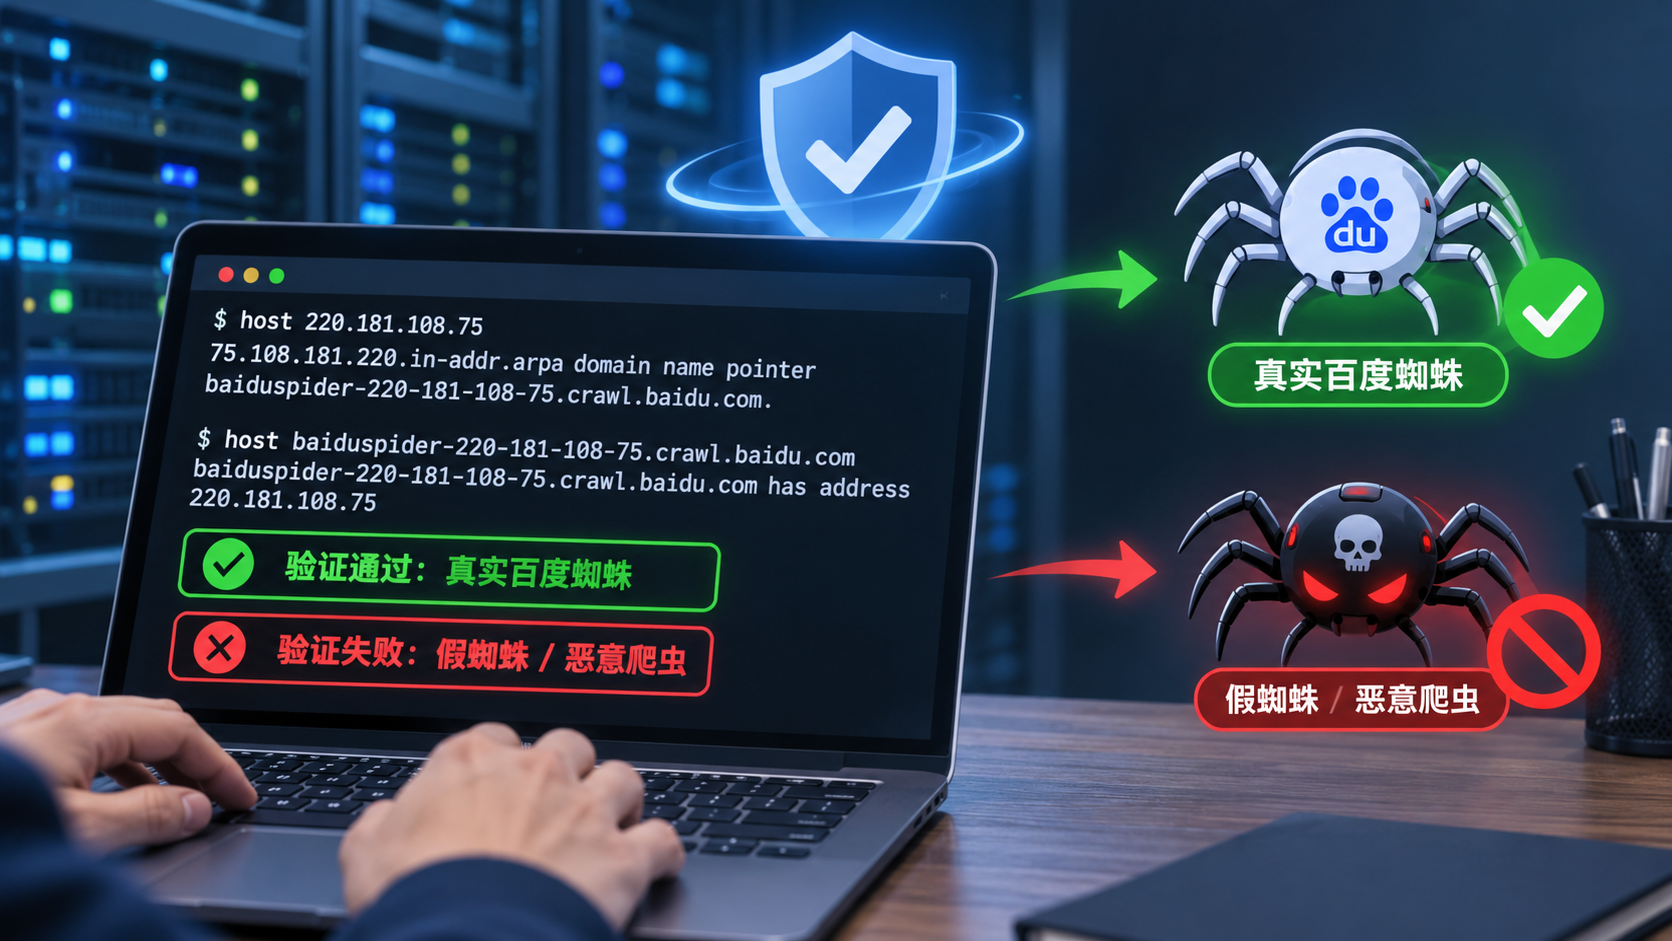
核心方案速览
识别真假百度蜘蛛不需要任何复杂的工具,直接记住“一看 IP,二做 PTR 反查,三做 A 记录正查”的三步验证法:
- 提取 IP:从 Web 服务器(Nginx/Apache)日志中拿到声明自己是
Baiduspider的客户端 IP。 - PTR 反向解析:对该 IP 执行
host <IP>或nslookup <IP>,查看返回的域名是否以.baidu.com或.baidu.jp结尾。 - A 记录正向解析:拿着反查出的域名再跑一次
nslookup <域名>,确认解析出的 IP 是否与原始 IP 完全一致(防止恶意节点伪造 PTR 记录)。
实操细节深度拆解
1. 命令行手动排查(适合临时抽查单个 IP)
当你发现服务器 CPU 飙升,日志里某个 IP 在狂刷页面时,不要急着封锁,先在终端里验证。
操作步骤:
在 Linux 服务器或本地终端执行以下命令:
# 第一步:反向解析 IP(以 220.181.108.75 为例)
host 220.181.108.75
真蜘蛛返回示例:
75.108.181.220.in-addr.arpa domain name pointer baiduspider-220-181-108-75.crawl.baidu.com.解析结果的主域名必须是 baidu.com 或 baidu.jp,任何 baidu-spider.com、baiduspider.cn 这种带连字符或乱七八糟后缀的都是假货!
# 第二步:正向校验域名(确认域名真的指向这个 IP)
host baiduspider-220-181-108-75.crawl.baidu.com
校验成功返回示例:
baiduspider-220-181-108-75.crawl.baidu.com has address 220.181.108.75如果正反向解析的 IP 能对齐,这就是真百度蜘蛛;如果解析失败或者域名不对,立刻封禁。
2. Nginx 日志自动化提取与批量验证
如果你的日志文件几万行,不可能手动去查。我们可以用 Shell 脚本自动化清洗日志并检测。
第一步:提取日志中所有自称“百度蜘蛛”的 IP 及请求次数
# 假设 Nginx 日志路径为 /var/log/nginx/access.log
grep -i "Baiduspider" /var/log/nginx/access.log | awk '{print $1}' | sort | uniq -c | sort -nr | head -n 20
输出效果:
  12543 42.156.138.11    <-- 需要重点排查的大流量 IP
   3421 220.181.108.75
    890 157.55.39.56
第二步:自动化识别与自动拦截脚本
编写一个 Shell 脚本 check_baidu_spider.sh,批量校验这些 IP。如果是假的,直接调用 iptables 或写入 Nginx 封禁配置文件中。
#!/bin/bash

# 提取最近日志中访问量前 50 的假蜘蛛 IP
LOG_FILE="/var/log/nginx/access.log"
BLOCK_CONF="/etc/nginx/conf.d/block_fake_spiders.conf"

# 获取标记为 Baiduspider 的独立 IP 列表
grep -i "Baiduspider" "$LOG_FILE" | awk '{print $1}' | sort -u | while read -r ip; do
    # 执行 PTR 反查
    ptr_name=$(host "$ip" | awk '{print $NF}' | sed 's/\.$//')

    # 验证域名后缀是否符合百度官方域名
    if [[ "$ptr_name" =~ \.baidu\.com$ ]] || [[ "$ptr_name" =~ \.baidu\.jp$ ]]; then
        # 验证正向解析
        forward_ip=$(host "$ptr_name" | awk '{print $NF}')
        if [ "$forward_ip" == "$ip" ]; then
            echo "[REAL] 真实百度蜘蛛: IP=$ip, Domain=$ptr_name"
            continue
        fi
    fi

    # 如果验证失败,判定为假蜘蛛
    echo "[FAKE] 假蜘蛛/恶意爬虫: IP=$ip"

    # 自动写入 Nginx 封禁名单(防止重复写入)
    if ! grep -q "$ip" "$BLOCK_CONF" 2>/dev/null; then
        echo "deny $ip;" >> "$BLOCK_CONF"
        echo "已封禁假蜘蛛 IP: $ip"
    fi
done

# 重载 Nginx 生效
nginx -s reload
避坑提示:
不要在 Nginx 内部直接配置 resolver 去做实时 DNS 反向解析!这样会导致 Nginx 每次处理请求都要同步等待 DNS 查询结果,极易把服务器的 worker 进程挂起发卡死亡。正确的做法是异步日志分析 + 静态列表封禁。
3. CDN/高防场景下的日志配置陷阱
很多站长用了阿里云 CDN、腾讯云 CDN 或 Cloudflare 后,发现上面脚本抓出来的 IP 全是 CDN 的节点 IP,导致把 CDN 给拉黑了。
避坑解决方案:
必须修改 Nginx 的日志输出格式(log_format),提取真实客户端 IP(X-Forwarded-For 或 X-Real-IP)。
在 /etc/nginx/nginx.conf 的 http 段修改:
# 定义包含真实 IP 的日志格式
log_format main_cdn '$http_x_forwarded_for - $remote_user [$time_local] "$request" '
                    '$status $body_bytes_sent "$http_referer" '
                    '"$http_user_agent"';

# 在 server 段调用该日志格式
access_log /var/log/nginx/access.log main_cdn;
如果 $http_x_forwarded_for 返回了多个 IP(格式如:1.2.3.4, 114.114.114.114),提取最左侧的 IP 才是真正的访问者 IP:
awk -F',' '{print $1}'高频关联问题拓展
问题 1:百度官方公布的 IP 段靠谱吗?可以直接拿 IP 段做白名单吗?
答:极不靠谱,绝对不要硬编码百度 IP 段!
百度官方多次明确说明:百度爬虫的 IP 池是动态扩容和调整的,没有固定的 IP 范围段。网上很多博客贴出的“百度蜘蛛 IP 大全”(比如 220.181.108.*、123.125.71.*)早已陈旧。
如果你把这些 IP 设置为白名单放行,假蜘蛛只要租用同 C 段的服务器就能肆无忌惮地刷你;如果你只允许这些 IP 访问,真正的百度新 IP 就会被你拒之门外,直接导致站点不收录。DNS 反向解析是百度官方认可的唯一标准手段。
问题 2:识别出真正的百度蜘蛛,但抓取频度太高把我服务器撑爆了,能封吗?
答:不能直接封 IP,要用“软阻断”或者去平台控频。
如果真是官方蜘蛛,直接封 IP 会导致网站权重暴跌、索引清除。面对高压抓取,建议按以下顺序处理:
- HTTP 503 状态码机制:
当服务器 CPU 超过 80% 时,针对百度蜘蛛返回
503 Service Unavailable,并在 Header 中带上Retry-After: 3600。百度蜘蛛遇到 503 会自动降低抓取频率,且不会立刻清空收录。 - 百度搜索资源平台调节: 登录“百度搜索资源平台” -> 抓取频度 -> 申请频度调节,手动拉低每日抓取上限。
- Robots.txt 规范(有限支持):
虽然百度对
Crawl-delay参数支持度一般,但可以通过Disallow限制高耗能的动态路径(如搜索页、标签筛选页):User-agent: Baiduspider Disallow: /*?* Disallow: /search/
问题 3:常见的伪造百度蜘蛛 UA 有哪些套路?
流氓爬虫为了避开反爬机制,通常会在 UA 里混淆以下特征:
| 伪造 UA 特征示例 | 实际目的 | 排查特征 |
|---|---|---|
Mozilla/5.0 ... Baiduspider/2.0 |
欺骗简单正则,伪装成普通百度移动蜘蛛 | IP 反查结果为阿里云、腾讯云、IDC 机房 IP |
Baiduspider-render/2.0 |
伪装成渲染蜘蛛,专门抓取渲染后的 JS 页面 | 频繁触发 POST 请求或敏感目录扫描 |
带有 +http://www.baidu.com/search/spider.html |
完整复制官方 UA 字符串 | PTR 解析域名为 xxx.com 或直接空 PTR |
踩坑经验:
有些黑客利用假蜘蛛扫描 wp-config.php.bak、.git/config 等敏感文件。只要在日志里看到 User-Agent 包含 Baiduspider,但访问路径是 .env、phpmyadmin 等敏感接口的,100% 是假蜘蛛,不需要做 DNS 验证,直接在 WAF 上封锁此 IP + UA 组合。
总结
识别真假百度蜘蛛的底层逻辑非常纯粹:请求头(UA)是可任意篡改的外表,DNS 反向解析(PTR 记录)才是无法伪造的身份证。
在日常运维中,建立“日志过滤提取 -> DNS 校验 -> 自动更新防火墙”的闭环机制,既能防住 99% 消耗资源的伪造爬虫与漏洞扫描器,又能确保真蜘蛛通行无阻,保障网站的正常收录与权重。