
canonical标签百度规范:百度Canonical规范实操避坑
关于canonical标签百度规范,先给结论:百度对该标签是“参考”而非“强制执行”,它必须放在<head>头部、必须用绝对路径、必须指向状态码200的内容高度一致页面,一旦出现相对路径、多标签冲突或指向重定向页面,百度爬虫会直接当作空气处理。
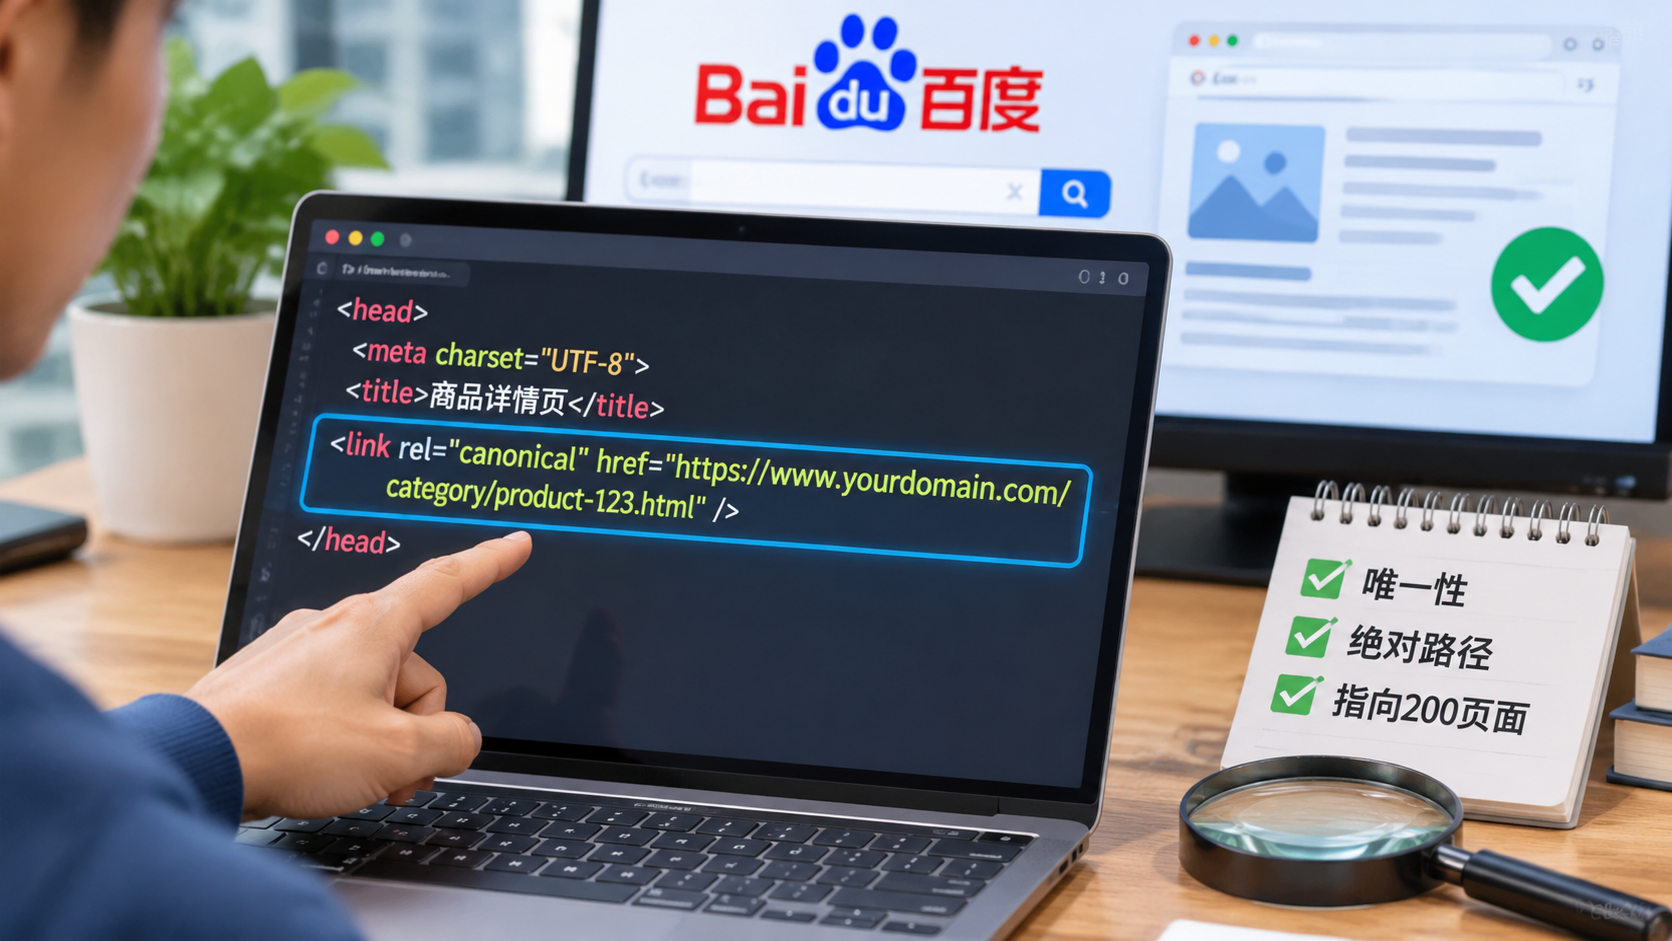
如果你发现站点因为筛选参数、推广追踪码导致收录大量重复内容,指望套个标签就万事大吉,那大概率会翻车。要把权重稳稳聚集在核心URL上,必须按照百度的脾气严格落地。
一、 核心方案速览
百度处理 rel="canonical" 的底层逻辑是:解决多URL指向同一内容时的权重分散与重复抓取。
- 标准代码格式(直接复制到
<head>内,不要放<body>):<link rel="canonical" href="https://www.yourdomain.com/category/product-123.html" /> - 三条硬性及格线:
- 唯一性:一个页面只允许存在一个
canonical标签。 - 绝对化:必须带
https://(或http://)和完整域名,严禁写相对路径。 - 同源/高相似:规范页与被规范页的内容重合度必须在80%以上,且规范页必须返回
200 OK状态码。
- 唯一性:一个页面只允许存在一个
二、 实操细节深度拆解
1. 标准部署与模板代码套用
很多新人和前端图省事,用当前页面的URL自动获取函数来拼标签,结果把原本带参数的动态URL又原封不动地写进 canonical 里,导致“自引用错误”,自己规范了自己。
常见CMS/动态环境的标准生成逻辑(以PHP为例):
在后端渲染模版时,必须剔除所有临时参数(如 utm_*、sort、page 等非核心参数),仅保留纯净的核心路由:
<?php
// 伪代码:过滤多余参数,锁定规范URL
$clean_path = parse_url($_SERVER['REQUEST_URI'], PHP_URL_PATH);
// 强制拼接协议和已确定的权威域名(避免www与不带www混用)
$canonical_url = "https://www.yourdomain.com" . $clean_path;
?>
<head>
    <meta charset="UTF-8">
    <title>商品详情页</title>
    <!-- 百度规范的 Canonical 部署 -->
    <link rel="canonical" href="<?php echo htmlspecialchars($canonical_url, ENT_QUOTES, 'UTF-8'); ?>" />
</head>
2. 百度爬虫极度反感的四大致命坑
在日常排查各类站点降权或收录混乱时,90%的 canonical 问题集中在下面四处:
- 坑一:用了相对路径
- 错误:
<link rel="canonical" href="/product/123.html" /> - 后果:百度蜘蛛在解析层级复杂的动态目录时,相对路径极易被多层拼接导致死循环解析,百度会直接忽略该配置。
- 错误:
- 坑二:页面代码里存在多个 Canonical
- 常见场景:SEO插件自动生成了一个,主题模板又硬编码了一个;或者JS动态渲染时又注入了一个。
- 后果:百度抓取直接判定为冲突错误,两边都不认,继续按自己算出的权重随机收录。
- 坑三:规范页返回非200状态码
- 错误:Canonical 指向的 URL 是个
301、302跳转地址,甚至是404页面。 - 后果:百度直接把该信号拉黑,甚至降低整站的抓取信任度。Canonical 指向的目标页必须是最终展示给用户的、不需要任何跳转的最终死链接。
- 错误:Canonical 指向的 URL 是个
- 坑四:跨协议与跨子域乱飞
- 全站已经做了 HTTPS,结果 canonical 依然残留
http://。百度会认为你的全站规范极度混乱,导致索引库里协议混杂。
- 全站已经做了 HTTPS,结果 canonical 依然残留
3. 电商筛选与动态参数页去重配置
电商和分类信息网是重复内容的重灾区。例如一个列表页有价格排序、颜色筛选:
- 原始核心页:
https://www.yourdomain.com/shoes/ - 用户筛选页:
https://www.yourdomain.com/shoes/?color=black&sort=price_asc - 推广引流页:
https://www.yourdomain.com/shoes/?from=baidu_feed&id=123
实操处理逻辑:
在所有带筛选参数的子页面中,将 canonical 统一指回该品类的核心入口。
<!-- 在 https://www.yourdomain.com/shoes/?color=black 中输出 -->
<link rel="canonical" href="https://www.yourdomain.com/shoes/" />避坑提醒: 如果筛选后的页面内容已经发生颠覆性变化(比如原本是全品类,筛选完只剩1件完全不同的冷门商品),百度可能判定两页内容差异过大,此时 canonical 会直接失效。百度只对“内容主题基本一致,仅展示顺序或细微属性微调”的页面买单。
4. PC站与移动站的适配混乱陷阱
这是被很多人搞混的地方。百度有它自己的一套移动适配协议,千万不要在PC和移动端之间乱插 canonical!
- 错误操作:在移动端
m.domain.com/a.html加canonical指向 PC 端www.domain.com/a.html,同时又在PC端做 302 跳转到移动端。这会导致百度抓取系统内部“死锁”。 - 百度官方正解:
- 代码适配/自适应(同一URL):单URL自适应终端,只在页面写自引用的 canonical,即指向页面本身即可。
- 独立二级域名移动站(PC与M站分离):
- PC端代码放:
<link rel="applicable-device" content="pc">配合对应移动页的alternate标签。 - 移动端代码放:
<link rel="applicable-device" content="mobile">,并在移动端可以使用 canonical 指向对应的 PC 页面。 - 更稳妥的方案:直接在百度搜索资源平台提交“移动适配”规则对应表,不要仅依赖页面上的 HTML 标签。
- PC端代码放:
三、 高频关联问题拓展
Q1:既然加了 Canonical,为什么百度收录库里还是有很多带参数的垃圾链接?
- 生效周期滞后:百度的索引库清洗非常慢,不像重定向那样立竿见影。即使代码写对,百度重新抓取、分析页面相似度、并在搜索结果中完成聚合合并,通常需要数周甚至数月。
- 内容差异过大:百度算法自检发现参数页和目标页差别较大,自动否决了你的建议。
- 应对方案:对于完全没必要让百度抓取的带参路径(如仅统计用的
utm_*、纯内部测试参数),直接在robots.txt中将其屏蔽(如Disallow: /*?*utm_),从抓取源头切断,不要试图用 canonical 擦屁股。
Q2:Canonical 标签和 301 重定向该怎么选?
很多站长为了聚合权重陷入两难。区别非常直观:
| 维度 | Canonical 标签 | 301 重定向 |
|---|---|---|
| 用户体验 | 用户可以正常访问不同参数页面,不受影响 | 用户被强制转移到新页面,无法访问旧URL |
| 搜索引擎态度 | 弱/中建议,百度看心情决定是否采纳 | 强指令,百度100%转移权重并更新索引 |
| 适用场景 | 电商筛选、带跟踪参的推广落地页、打印版页面 | 网站改版、换域名、全站HTTP跳HTTPS、废弃内容合并 |
实操结论:只要能让用户直接跳的,全部走 301;只有必须保留参数页面展示给用户(如特定排序、追踪),但想让搜索引擎把权重归给主页的,才用 canonical。
Q3:Nginx 层能否直接输出 Canonical?
可以,而且更干净,特别适用于 PDF 等非 HTML 资源。可以在 Nginx 响应头中注入 Link:
# 针对特定路径或带参请求直接在 Header 中规范
location ~* \.pdf$ {
    add_header Link "<https://www.yourdomain.com/docs/clean-manual.pdf>; rel=\"canonical\"";
}
四、 总结
严格执行canonical标签百度规范,关键在于克制与规范。
不要把该标签当成处理死链、垃圾目录的“万金油”。在实操中,确保每个页面的 canonical 仅存在一个、全拼绝对路径、指向状态200的无参数真实页面,并与内容保持极高相关性。如果遇到百度迟迟不聚合的情况,结合 robots.txt 封禁抓取以及百度搜索资源平台的“URL参数”工具进行双重压制,才是彻底根治重复收录的稳定方案。