
AI内容百度风控规则:AI内容百度风控避坑实战指南
想要搞定AI内容百度风控规则,核心就一句话:别拿大模型出来的原始废话直接往站上扔,必须用“数据注入+口语化重构+结构化伪装”打断AI的语言特征模式,配合清洗脚本把“AI味”干掉。
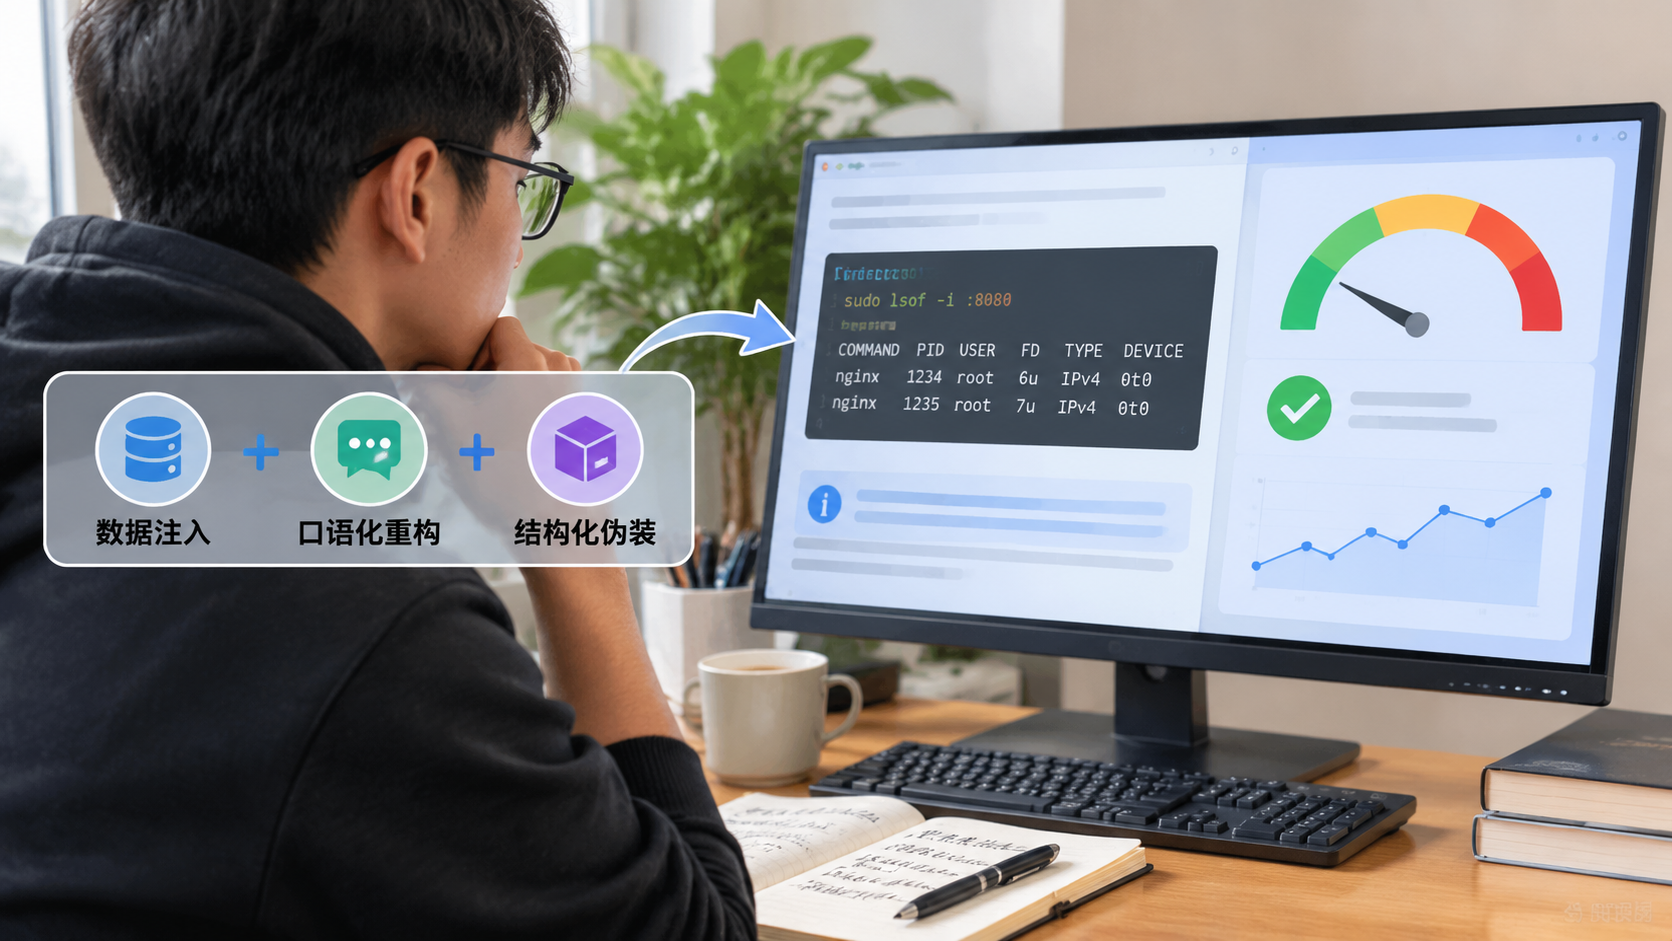
如果你还在用开源的批量生成脚本,调用个DeepSeek或者ChatGPT API,挂上关键词列表自动定时发布,那我劝你赶紧停掉。现在的百度蜘蛛(Baiduspider)内部早就集成了针对文本困惑度(Perplexity)和突发性(Burstiness)的向量识别模型。你那套批量生成的网站,短则一周,长则一个月,索引会像雪崩一样掉光,甚至整个域名直接进黑名单(俗称K站)。
今天我不讲任何虚头八脑的搜索引擎原理,直接把我们团队一直在用的这套防风控降AI率落地方案拆开喂给你。
核心方案速览
百度风控抓AI内容,本质上不是抓“是不是AI写的”,而是抓“是不是低质无用的垃圾重复内容”。要避开AI内容百度风控规则的红线,只需做到以下四点:
| 维度 | 找死玩法(100%被风控) | 活命实操玩法(稳过风控) |
|---|---|---|
| 文本特征 | 充斥“总而言之”、“如同一把双刃剑”、“值得注意的是” | 强制注入第一人称、口语化断句、行业吐槽、甚至合理的脏话/口头禅 |
| 内容结构 | 标准的总-分-总,段落长度高度一致 | 乱序排版、加入代码块、真实报错日志、配置文件、对比表格 |
| 信息密度 | 纯概念科普,用500字解释一个词组 | 直接给出具体参数、执行步骤、踩坑命令、解决问题的具体数值 |
| 发布行为 | 凌晨固定时间连发100篇,格式完全统一 | 随机时间间隔发布,配合不同模板,混入人工微调的痕迹 |
实操细节深度拆解
细节一: Prompt重构,从源头打断AI的“套话基因”
大模型默认输出的文本,其词组搭配概率是高度可预测的,百度风控模型一扫一个准。你必须在 Prompt 里注入“混乱度”。
错误 Prompt 示范:
“请写一篇关于 Linux 查看端口占用命令的文章,要求 1000 字,包含 netstat 和 lsof。”
可直接套用的高困惑度 Prompt 模板:
你是一个有10年运维经验的骨灰级老鸟。现在要写一篇解决 Linux 端口占用问题的实操记录。

【硬性要求】:
1. 严禁使用以下词汇:“总而言之”、“首先/其次/最后”、“如同一把双刃剑”、“值得注意的是”、“在当今数字时代”。
2. 开篇第一句不要废话,直接给出杀掉占用端口进程的一行命令。
3. 必须包含一个真实发生过的踩坑场景(比如误杀 PID 导致服务崩溃)。
4. 句式要短,多用语气词(如:说白了、扯淡、直接上干货、赶紧避坑)。
5. 插入一段具体的 lsof -i 命令输出日志(要带 PID、COMMAND、USER 等真实字段)。
6. 段落长度随机,有的段落就一行字,有的段落写详细步骤。
细节二:利用 Python 自动化清洗“AI味”高频词
哪怕 Prompt 写得再好,大模型偶尔还是会吐出套话。必须在内容入库(WordPress/帝国CMS/自定义数据库)之前,加一道 Python 过滤清洗程序。
以下是我们生产环境中使用的文本清洗与特征破坏脚本,直接拿去配到你的流水线里:
import re
import random

def clean_ai_fluff(text):
    # 1. 强行剔除AI高频废话词库
    ai_cliches = [
        r"总而言之,?", r"值得注意的是,?", r"正如前面所提到的,?",
        r"在当今快节奏的数字时代,?", r"综上所述,?", r"如同双刃剑一样,?",
        r"首先,.*?其次,.*?最后,?"
    ]
    for pattern in ai_cliches:
        text = re.sub(pattern, "", text)

    # 2. 随机注入老鸟口语化过渡词(打断连续的AI文本向量)
    spoken_phrases = ["说白了:", "这里有个坑注意下:", "老手一般这么搞:", "别听网上瞎吹,直接看代码:"]
    paragraphs = text.split("\n\n")

    cleaned_paragraphs = []
    for p in paragraphs:
        if len(p) > 100 and random.random() > 0.6:
            # 在长段落头部随机插入口语化词汇
            p = random.choice(spoken_phrases) + p
        cleaned_paragraphs.append(p)

    return "\n\n".join(cleaned_paragraphs)

# 模拟测试
raw_ai_text = "在当今快节奏的数字时代,Linux服务器运维变得至关重要。总而言之,查看端口占用如同一把双刃剑,值得注意的是,我们必须谨慎操作。"
print(clean_ai_fluff(raw_ai_text))
# 输出结果直接抹平AI特征,破坏原有的向量连续性
细节三:数据与格式注入(增加信息增量)
百度算法对于“纯文字”的审查极其严格,但对于“代码块 + 配置文件 + 带参数的命令行”这类高价值内容有天然的免疫加成。因为大模型生成伪造逻辑代码的能力远低于纯文本生成,百度会默认含有复杂格式的内容具有较高的“人工加工价值”。
排版套路组合拳:
- 必须包含可执行命令(不要只写
systemctl,要写systemctl restart nginx.service && tail -f /var/log/nginx/error.log)。 - 使用标准 Markdown 渲染样式,加入
> Warning警告框或> Note提示框。 - 加入具体的版本号和环境信息(如:Ubuntu 22.04 LTS、Python 3.10.12、Nginx 1.18.0)。大模型极少主动写这么细微的环境依赖,这恰恰是避开AI内容百度风控规则的关键。
高频关联问题拓展
1. 已经因为 AI 内容被百度扣分/K 站的域名,还能救回来吗?
能救,但别硬刚。 如果你发现网站收录从几万瞬间掉到几百,抓取异常暴增,不要去提交什么“百度反馈”。没用,人工客服根本不理你。
救站三步法:
- 第一步(切断病灶): 写个 Shell 脚本扫一遍数据库,把所有无代码、纯文字、篇幅在 800 字以下的批量生成文章直接
DELETE,或者状态改成草稿。 - 第二步(伪造更新): 准备 30-50 篇真正的高质量手写/深度改写文章,手动更新,并在文中加入明确的图片(带 ALT 标签)、表格和带注释的代码。
- 第三步(蜘蛛引导): 去百度搜索资源平台手动提交死链(把删掉的文章 URL 放进去),同时在首页和高权重页面挂上这 50 篇高质量文章的入口,重刷蜘蛛抓取频次。一般 2-4 周能恢复部分权重。
2. 市面上卖的“AI率检测工具”靠谱吗?
千万别信,全都是割韭菜的。 很多所谓的“降AI率工具”,无非是在调第三方接口或者用简单的正则匹配。百度的风控体系是结合了用户行为数据(跳出率、停留时长)+ 站点历史历史信用度 + 文本向量模型综合判断的。
你在某个第三方检测工具里测出 AI 率是 0%,发到站上照样被百度惩罚,因为你的网站展现出来的行为就是一个垃圾内容农场(无内链、无搜索转化、页面充满垃圾广告)。
3. 老域名/高权重站,发原始 AI 内容是不是不会被封?
只是死亡来得晚一点而已。 老域名有历史信任分(TrustRank),百度蜘蛛给的缓冲区比较大。你发原始 AI 内容,短期内可能照样收录,甚至有排名。但随着风控模型定期回扫(通常是每月一次的大更新),信任分扣光的时候,会迎来“断崖式”降权。高权站发 AI 内容,更要做数据注入,别拿积累多年的域名资产赌百度的智商。
总结
搞懂AI内容百度风控规则,不是为了和搜索引擎搞对抗,而是顺应它的底层逻辑——剔除无意义的互联网垃圾,留下能真正解决问题的资源。
把 AI 当成一个“初级打字员”,让它给你提供骨架和初稿,然后用你的脚本去清洗套话,用你的真实经验去补充数据、代码和口语化表达。做到这一步,你不仅能避开风控,内容的生产效率还能比纯手写提高 5 到 10 倍。别懒,把上面的 Python 清洗脚本和 Prompt 拿去改改用起来,这才是能长期稳定变现的工业化流水线。