
Robots协议高级配置与抓取陷阱排查:网站总被乱爬?教你几招搞定
在日常的网站运维与搜索引擎优化中,很多人以为在根目录下扔一个简单的 robots.txt 就万事大吉了,直到某天服务器被爬虫打崩,或者核心页面的抓取频次被垃圾页面稀释得一塌糊涂,才意识到事情的严重性。深入理解 Robots协议高级配置与抓取陷阱排查,是每一个技术型 SEO 和系统运维人员必须掌握的底层硬核能力。它不仅关乎有限的抓取预算(Crawl Budget)能否用在刀刃上,更直接决定了服务器的稳定性和全站的索引健康度。
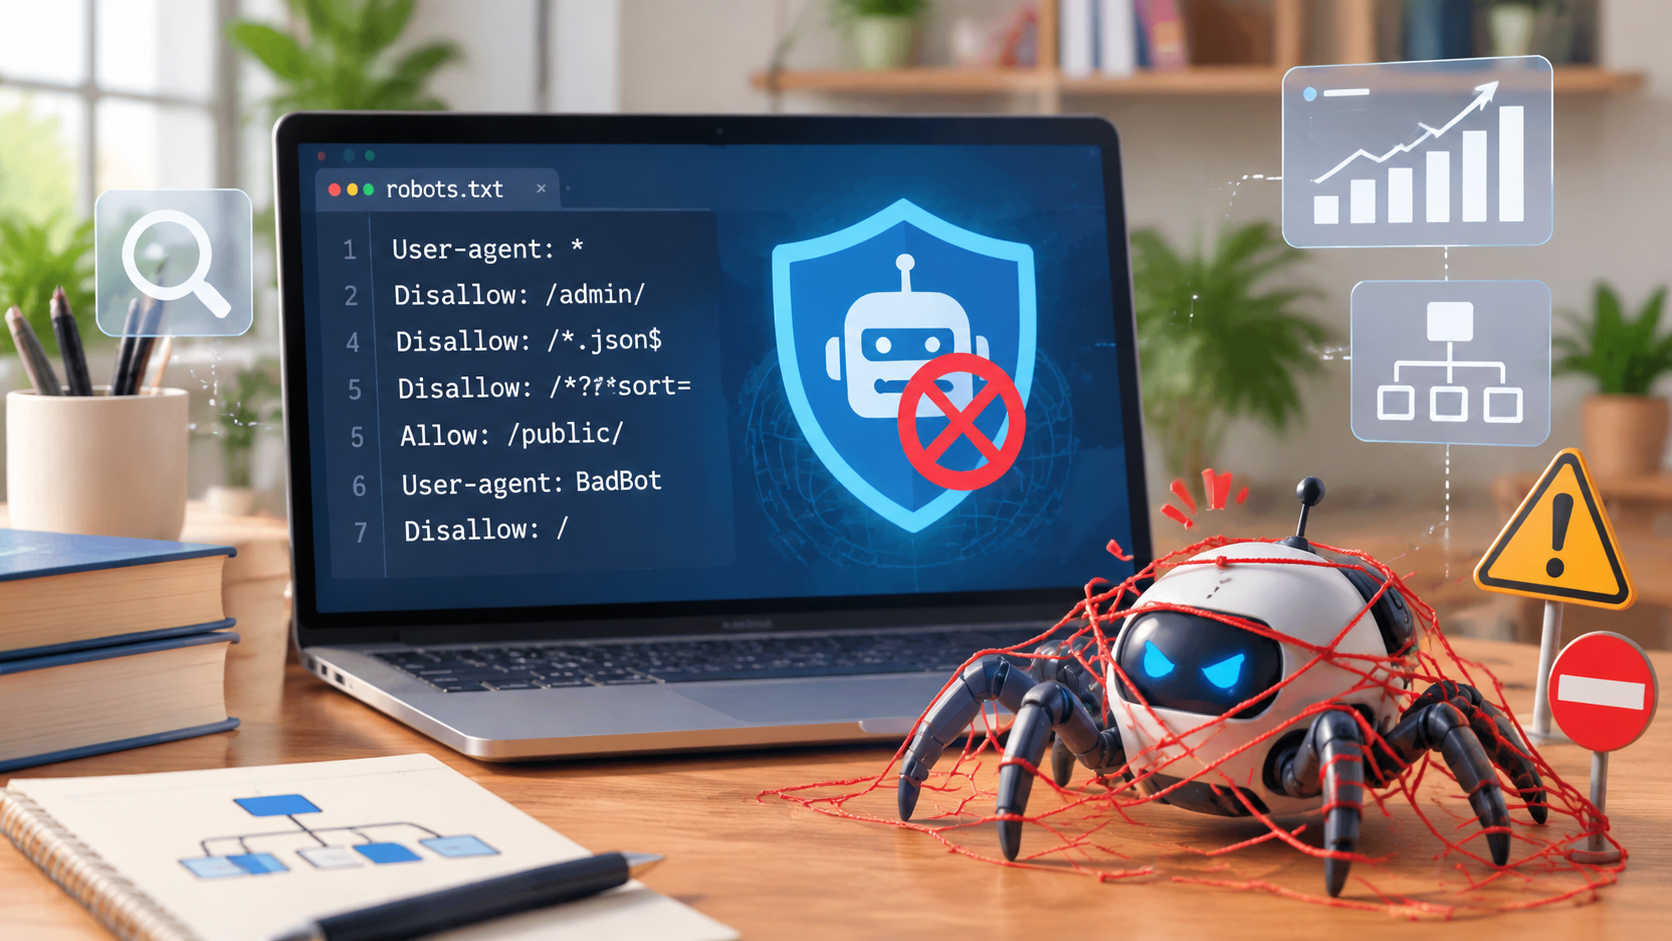
一、 别再只会写 Disallow:Robots 协议的高级配置实操
多数人对 Robots 协议的认知还停留在 User-agent: * 和简单的文件路径拦截上。但在复杂架构的现代网站中,你需要更精确的规则控制。
1. 通配符与结束符的精细组合
Robots 协议支持通过 *(通配符)和 $(行尾结束符)实现类似正则的匹配逻辑。合理利用它们可以极大简化规则并避免误伤:
- 拦截特定后缀资源:
Disallow: /*.json$或Disallow: /*.action$,能有效阻止动态接口暴露给蜘蛛,但又不会误杀名为json-parser.html的内容页。 - 隔离带参死循环:
Disallow: /*?*sort=,可以拦截所有带有排序参数的 URL,防止搜索引擎在商品筛选页中无限空转。
2. 多蜘蛛差异化对待与权限优先级
大厂搜索引擎对规则的处理逻辑存在差异。例如,Googlebot 严格遵守最长匹配前缀原则(Longest Match),即匹配路径更长的指令优先,而不是按书写顺序;而部分国内爬虫在面对 Allow 和 Disallow 冲突时可能存在解析偏差。
- 永远把具体的
Allow规则放在泛化的Disallow上方或保证其路径更具体。 - 对待恶意或高耗能的爬虫(如某些未经授权的 AI 训练爬虫),直接配置封禁:
User-agent: SpecificAggressiveBot
Disallow: /
3. X-Robots-Tag 的降维打击
robots.txt 只能阻止爬虫“抓取”,但不能阻止爬虫通过外部链接发现并“索引”该 URL(常表现为搜索结果中显示“由于该网站的 robots.txt 文件,未提供此结果的信息”)。
对于 PDF、图片、Office 文档等非 HTML 资源,或者想彻底从索引中抹除的内容,必须在 Nginx 或 Apache 层面配置 HTTP 响应头的 X-Robots-Tag: noindex, nofollow。这是 Robots 体系在服务器运维端的高级延伸。
二、 抓取陷阱的四种典型形态与成因
所谓“抓取陷阱(Spider Trap)”,是指网站架构或代码缺陷导致爬虫在其中无限循环抓取,耗尽抓取配额甚至造成服务器 DDOS 的现象。
- 多重筛选组合爆炸(Faceted Navigation)
电商和分类信息网站的重灾区。颜色、尺码、价格、品牌等条件随意叠加(如
/shoes?color=red&size=40&brand=nike&sort=price),会生成几万甚至几百万个内容高度重复但 URL 不同的页面。 - 日历与活动无限滚动
CMS 中自带的日历插件经常生成未来或过去年份的归档链接(
/events/2026/05、/events/2027/06……),爬虫会顺着链接一直点击下去,永远爬不到头。 - Session ID 与追踪参数污染 程序在生成内部链接时,错误地把用户的 Session Token 或营销用的 UTM 参数硬编码到了页面 a 标签中,导致同一篇文章衍生出无数个动态假 URL。
- 相对路径循环嵌套(目录死循环)
因前端开发疏忽,相对路径少写了开头的
/。例如当前在/about/,页面内的链接写成about/team,下一次点击就变成了/about/about/team,层层嵌套形成深渊。
三、 抓取陷阱排查与落地解决方案
解决抓取问题,不能靠“猜”,而要靠日志分析和规则兜底。
第一步:分析 Web 访问日志定位异常
不要仅依赖第三方的 SEO 工具,真实的答案全在 Nginx/Apache 访问日志里。
- 使用 Linux 命令行快速定位:
# 统计最近抓取频次最高的 URL 前缀(以 Googlebot 为例) grep "Googlebot" access.log | awk '{print $7}' | cut -d'/' -f2 | sort | uniq -c | sort -nr | head -n 20 - 如果发现某个目录(如
/calendar/或带某种参数的链接)请求量巨大,且返回状态码多为 200,说明爬虫已经掉进了陷阱。
第二步:三道防线综合治理
遇到抓取陷阱,必须采取“Robots 阻断 + Canonical 规范 + 运维截断”的组合拳:
- 第一道防线:Robots.txt 立即止血
一旦定位陷阱 URL 特征,立刻在 robots.txt 中加入规则切断爬虫入口。例如针对多重参数:
Disallow: /*?*filter= Disallow: /calendar/* - 第二道防线:规范标签与参数管理
在页面代码中部署
<link rel="canonical" href="https://example.com/base-url" />,明确告诉已误入陷阱的蜘蛛规范化地址;同时在 Google Search Console 的“网址审查”及各大站长后台提交参数过滤规则。 - 第三道防线:Nginx/网关层直接干预
对于严重的相对路径死循环(如路径中连续出现两次相同的目录名),无需等 robots 生效,直接在 Nginx 层面用正则重写或阻断:
# 拦截重复目录嵌套,直接返回 404 或 410
location ~* /([^/]+)/\1/ {
   return 404;
}
总结
Robots 协议不仅是一份写给搜索引擎看的声明文件,更是连接 SEO 抓取策略与服务器运维安全的控制阀。在网站开发与改版初期,就必须将 URL 规范化、参数处理策略与 Robots 配置一同纳入技术选型。定期巡检爬虫日志,及时发现并拔掉抓取陷阱这颗“暗雷”,才能保证网站的抓取效率与服务器性能始终处于健康状态。
相关文章
- 内链拓扑结构对百度蜘蛛抓取深度的影响:别让稀烂的内链,把百度蜘蛛挡在网站大门外
- 网站百度蜘蛛抓取量断崖式下跌原因剖析:百度蜘蛛不爬了?老站长教你排雷
- 智能DNS解析针对百度蜘蛛独立配置线路:别让延迟毁了收录,DNS分流实战
- 降低百度蜘蛛抓取耗时的服务器优化方案:百度蜘蛛抓取慢?老站长的服务器提速心法
- URL重写伪静态对百度蜘蛛抓取效率的影响:伪静态:别让URL毁了你的收录
- 黑帽蜘蛛池诱导抓取与正规SEO的区别:蜘蛛池诱导与正规SEO实战录
- 网站改版301重定向引导百度蜘蛛权重转移:网站改版301权重转移实战指南
- 百度小程序爬虫与普通网页蜘蛛抓取差异:小程序与网页蜘蛛抓取实战避坑
- 新站TDK标签规范设置:新站做SEO,TDK到底该怎么填
- 网站初期核心关键词挖掘与布局:新站选词难?手把手教你把词定准