
基于AI的个人知识库搭建指南:个人AI私有知识库搭建实战
在信息过载的时代,散落于本地笔记、书签和文档中的碎片化知识往往沦为“数字废纸”,难以被高效检索与复用。为此,本文为你提供一份系统、可落地的基于AI的个人知识库搭建指南,旨在帮助你利用前沿的检索增强生成(RAG, Retrieval-Augmented Generation)技术与本地大语言模型,将离散的个人数据转化为可对话、可深挖的“专属数字第二大脑”,同时在数据隐私、检索精度与部署成本之间取得最佳平衡。
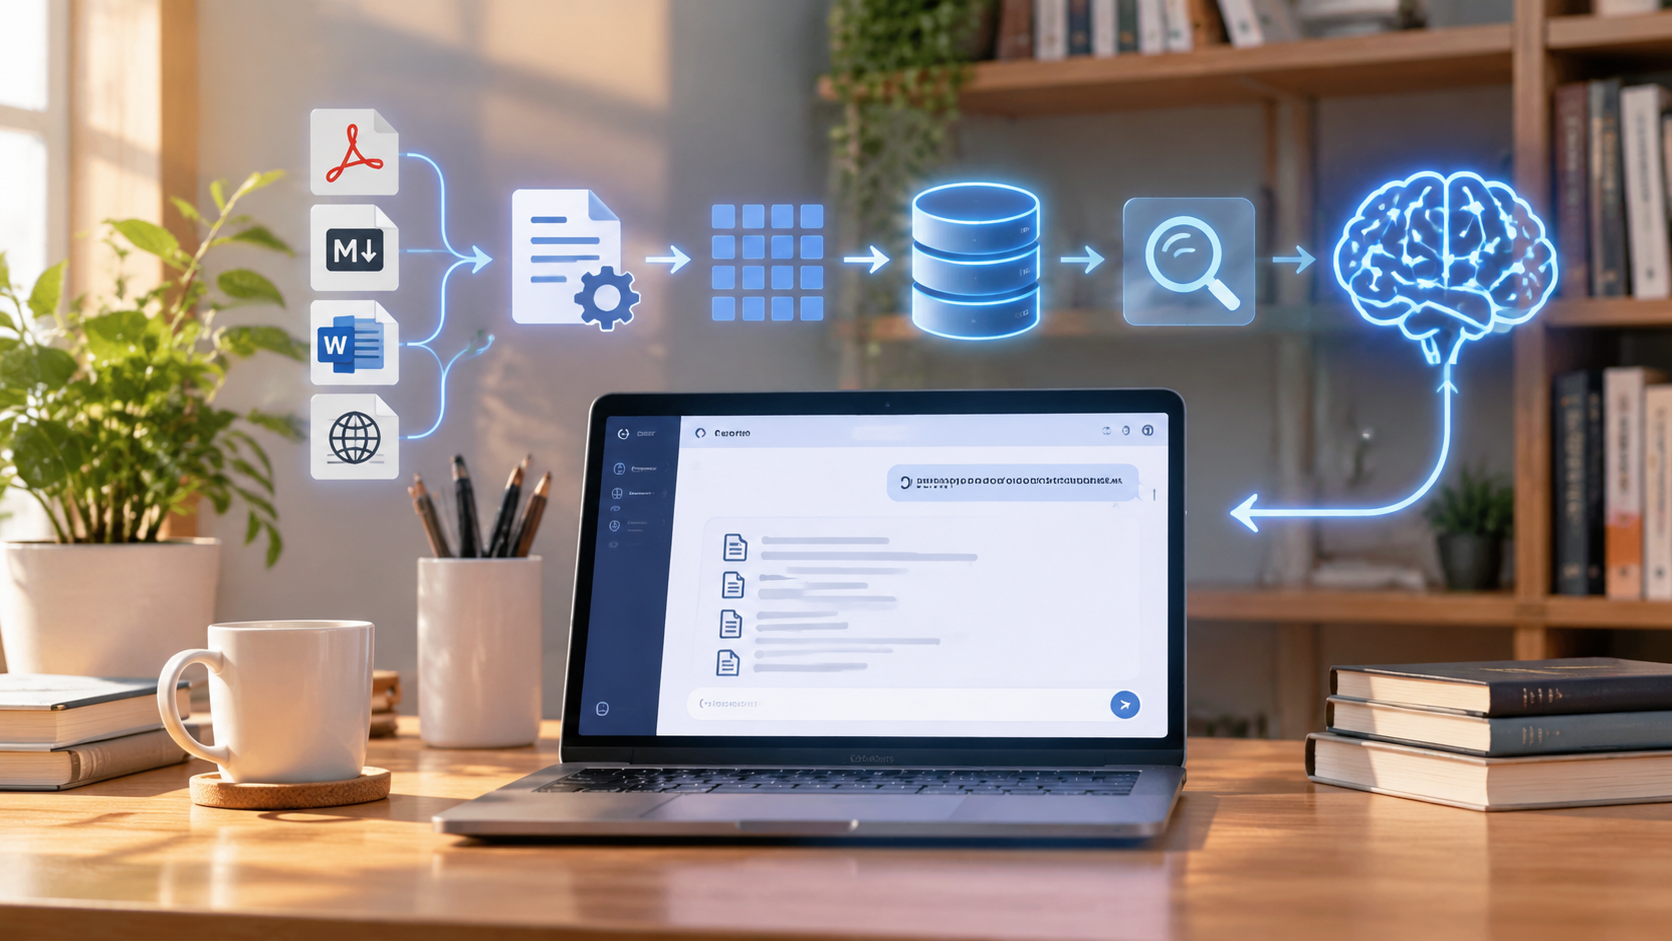
一、 AI知识库的核心底层架构:深入理解RAG
想要搭建高可用、高准确率的知识库,首先需要理解其技术底座——RAG(检索增强生成)架构。传统的本地全文搜索基于关键词匹配,无法理解语义;而纯粹依赖公网大模型又面临数据隐私泄露和模型“幻觉”的问题。基于AI的知识库正是通过以下闭环解决这些痛点:
- 文档解析与切分(Chunking):将PDF、Markdown、Word或网页等异构数据清洗后,按照语义切分为固定或滑动窗口的文本块(Chunks)。
- 文本向量化(Embedding):利用Embedding模型(如BGE、Text2vec),将每个文本块转化为包含语义信息的高维密集向量(Dense Vectors)。
- 向量存储与索引(Vector Store):将向量及其原始文本存入向量数据库(如Qdrant、Chroma、Milvus),构建基于HNSW等算法的高效近似最近邻(ANN)索引。
- 语义检索与重排(Retrieval & Rerank):用户提问时,问题同样被转化为向量,系统计算余弦相似度召回Top-K个最相关的文本块,并配合Rerank重排模型提高上下文相关性。
- Prompt组装与大模型推理(Generation):将用户问题与召回的上下文组装成结构化Prompt,输入给LLM(如Qwen、Llama),模型依据给定事实输出精准答案,并附带引用来源。
二、 知识库技术选型:如何平衡性能与隐私?
从运维和工程落地角度来看,技术栈的选择取决于你的硬件条件与对隐私的要求。目前主流方案可归纳为两类:
1. 全本地自托管方案(高隐私、高安全性、零调用成本)
适合拥有独立显卡(建议RTX 3060 12G显存以上)或苹果Apple Silicon(M系列芯片统一内存16G以上)的用户。
- LLM引擎:Ollama、vLLM、LocalAI
- 向量数据库:Qdrant(轻量高效,Rust编写)、Chroma(Python生态友好)
- 知识库调度中台:Dify、FastGPT、AnythingLLM
2. 混合部署方案(低硬件门槛、高回答质量)
本地仅负责文档存储与向量检索,生成任务调用云端API(如DeepSeek、OpenAI、Claude等)。
- 优势:本地无需强悍显卡,依赖商业模型的强大逻辑推理能力,成本低廉且响应迅速。
三、 实战演练:基于 Ollama + Dify 的本地知识库搭建
本节以目前兼具功能深度与操作体验的 Dify(应用中台)+ Ollama(本地模型推理引擎) 组合为例,带你完成生产级环境的搭建。
步骤1:部署本地大模型环境(Ollama)
访问 Ollama官网 下载对应操作系统的客户端。安装完成后,在终端拉取推理模型与Embedding模型:
# 拉取主推理模型(以阿里开源的 Qwen2.5 7B 为例,中文理解极强)
ollama run qwen2.5:7b

# 拉取高表现向量模型(BAAI开源的中文优选模型)
ollama pull bge-m3
完成拉取后,Ollama默认在本地 http://localhost:11434 提供API服务。
步骤2:通过 Docker Compose 部署 Dify 知识库中台
Dify 提供了成熟的知识库管理、检索评测与工作流编排能力。推荐使用 Docker 快速交付:
# 克隆 Dify 仓库源码
git clone https://github.com/langgenius/dify.git

# 进入 docker 目录
cd dify/docker

# 复制环境变量配置文件并启动容器集群
cp .env.example .env
docker compose up -d
等待容器全部拉起后,在浏览器访问 http://localhost/install,设置管理员账号并登录。
步骤3:配置模型提供商
- 进入 Dify 后台,点击右上角头像 -> 设置 -> 模型供应商。
- 找到 Ollama,点击添加模型:
- LLM配置:模型名称填写
qwen2.5:7b,URL填写http://host.docker.internal:11434(如果在Linux上使用Docker,请确保网络能连通宿主机的11434端口)。 - Embedding配置:模型类型选择
Text Embedding,模型名称填写bge-m3。
- LLM配置:模型名称填写
步骤4:创建知识库与优化文档切分策略
知识库检索准确率的80%取决于数据预处理。点击顶部导航栏的 知识库 -> 创建知识库:
- 上传源文件:推荐使用清洗过的 Markdown 或排版清晰的 PDF 文件。
- 切片分块策略(关键调优参数):
- 分块长度(Chunk Size):建议设置为
500 - 800Tokens。分块过小会丢失上下文,分块过大容易引入噪音。 - 重叠长度(Chunk Overlap):建议设置为
50 - 100Tokens,确保边界语义不被硬性截断。
- 分块长度(Chunk Size):建议设置为
- 检索模式选择:
- 选择 高质量模式,指定
bge-m3作为 Embedding 引擎。 - 勾选 混合检索(Hybrid Search):结合向量检索的语义理解能力与传统 BM25 的关键词匹配能力,避免专有名词或特定缩写检索失真。
- 选择 高质量模式,指定
四、 进阶调优与长期运维指南
知识库“搭建完成”仅是第一步,要让它长期好用,还需从运维和内容工程层面进行精细化管理:
1. 引入 Rerank 重排机制
单纯依靠向量相似度召回的上下文往往包含无关信息。在生产调优中,建议在 Dify 中配置重排模型(如 bge-reranker-large)。检索时先粗召回 Top-20 文本块,再由 Rerank 精排输出前 3~5 个最高分块输入 LLM,可显著降低模型幻觉。
2. 构建输入侧的“Markdown化规范”
非结构化数据是检索准确率的杀手。在向知识库注入内容前,建议:
- 尽量将无序网页、图表先用 OCR/LLM 转换为带有一级、二级标题的 Markdown 格式。
- 明确主谓宾结构,并在文档开头加上简明的元数据(Tags、类别、核心主题摘要),极大提升语义召回精度。
3. 数据备份与容灾策略(运维视角)
运行知识库时,务必对向量数据库和关系数据库进行周期性备份。对于 Docker 部署的 Dify,需定期固化并异地备份其挂载卷:
- 保护好
dify/docker/volumes/db(PostgreSQL 数据库元数据) - 保护好向量数据库(如 Qdrant 的存储卷),确保硬件故障时可一键灾备恢复。
结语
搭建基于 AI 的个人知识库,本质上是一场数字资产的重构与生产力跃迁。通过 Ollama 与 Dify 构建起的这套全私有化 RAG 系统,既保障了敏感知识的安全,又赋予了数据智能交互的能力。随着本地小参数模型推理效率的不断提升,精细化微调与智能知识召回将成为每位技术人与知识工作者的必备生产力工具。立即动手部署你的节点,体验与自身智慧“面对面对话”的全新交互方式吧。
相关文章
- AI自动生成PPT工具实测:站长实测:AI做PPT别再踩坑了
- Coze接入飞书搭建业务Bot:Coze接飞书搭业务Bot实操
- AI批量提取扫描件PDF数据:AI提取扫描件PDF数据实操
- AI批量清洗去重客户名单:名单去重与站长文案实操指南
- Cursor辅助编写日常运维脚本:Cursor写运维脚本实操指南
- 开源AI录音转文字私有化部署:搞定本地语音转文字与站长写作
- AI一键生成业务流程思维导图:老站长教你用AI秒画业务流程图
- AI自动审查合同关键条款风险:老站长聊AI审合同的避坑实操
- Claude长文本快速提炼行业报告:老站长用Claude啃透行业报告
- AI办公数据泄露风险与防范:别乱用AI办公了,数据正在被看光