
服务器IO瓶颈排查与优化:服务器总卡死?教你搞定磁盘问题
很多运维和站长朋友都遇到过这种糟心事:网站突然卡顿打不开,连上SSH敲命令也是一顿一顿的,打开top一看,CPU使用率明明还剩一大半,内存也没爆,但系统的load average(负载)却高得离谱。遇到这种情况,八成是磁盘读写被塞满了。今天我们就来深入聊聊服务器IO瓶颈排查与优化,抛开那些晦涩的纯理论,从实际干货出发,手把手带你找到是哪个进程在偷偷疯狂读写,并给出真正落地的解决办法。
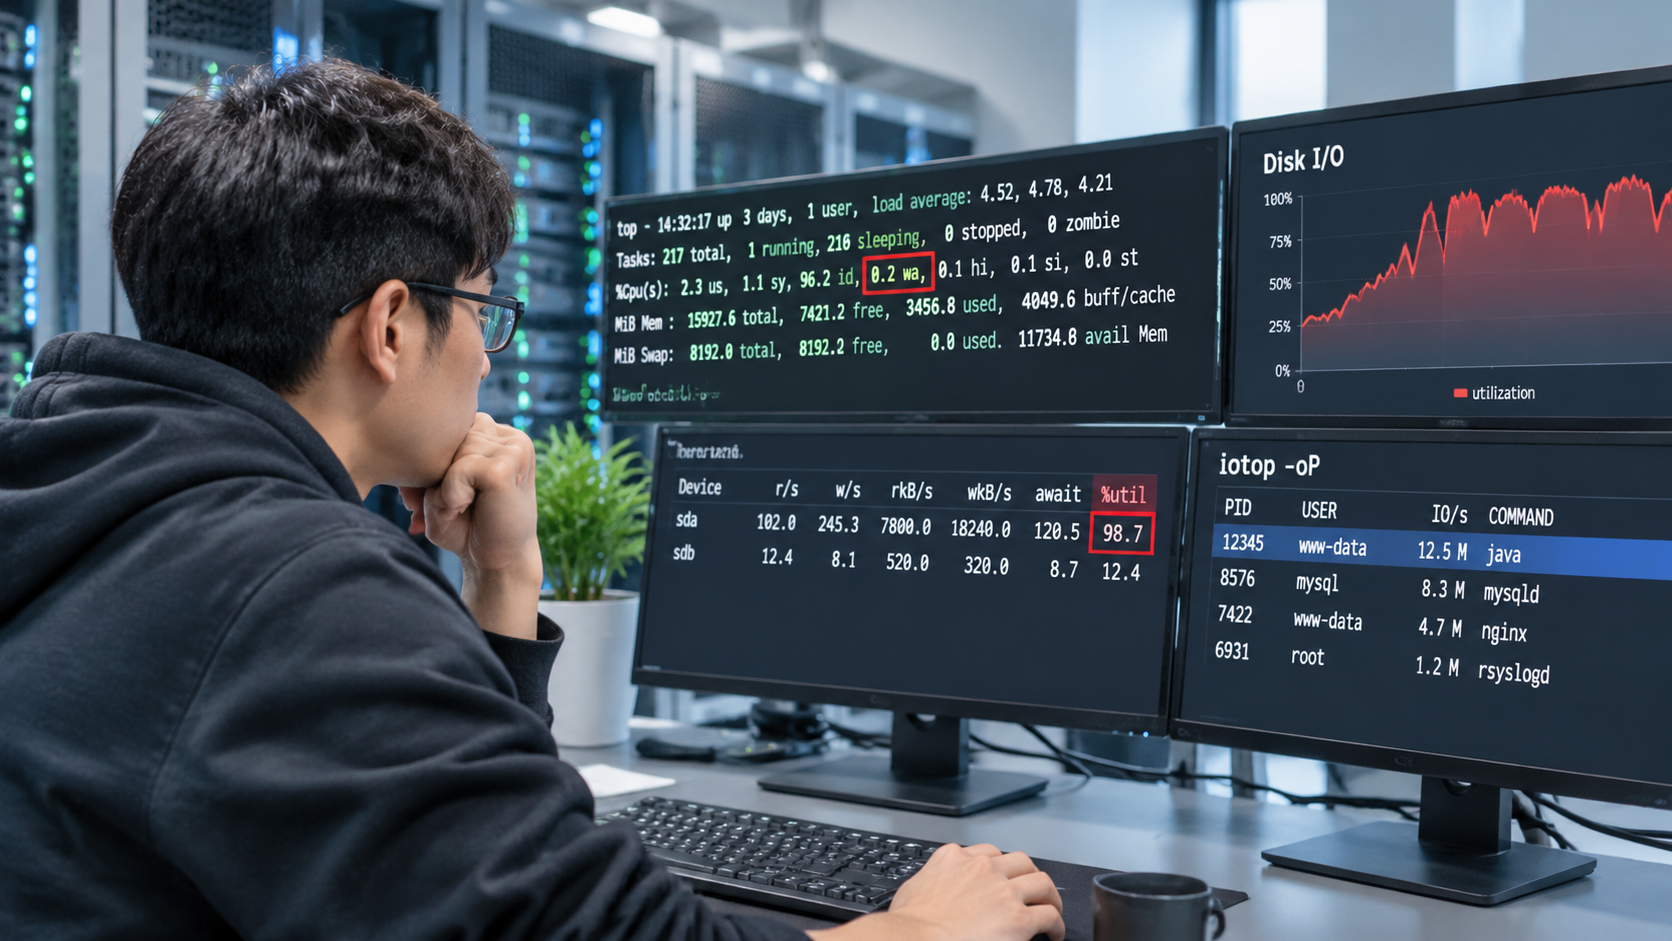
一、 怎么判断是不是IO拖了后腿?
很多人排查卡顿只看CPU和内存,其实磁盘读写(I/O)才是现代很多Web系统最容易撞上的天花板。要确认是不是磁盘的问题,几个经典的系统工具就足够了。
1. 看整体状态:top 里的 wa 值
连上服务器先敲一个 top,看第三行CPU信息里的 %wa(wait):
- 含义:CPU等待外部设备I/O操作完成的时间百分比。
- 标准:正常情况下这个数值应该在 1% 以下甚至接近 0。如果它长期处于 20% ~ 30% 以上,就说明CPU大部分时间都在眼巴巴地等磁盘把数据吐出来,这时候基本可以确定遭遇了IO瓶颈。
2. 看磁盘细节:iostat -x 1
要更精准地抓出是哪块磁盘撑不住了,需要用 sysstat 工具包里的 iostat:
iostat -x 1 3重点盯紧这几个参数:
- %util:磁盘繁忙度。如果这个值长期在 85% ~ 100%,说明这块磁盘几乎一刻不停地在读写,已经跑满了。
- await:平均每次IO请求的处理时间(毫秒)。一般SSD应该在5ms以内,机械盘在10-20ms左右。如果经常飙到上百甚至几千毫秒,说明排队排炸了。
- r/s 和 w/s:每秒读/写次数;rkB/s 和 wkB/s:每秒读/写的数据量。通过它们能看出到底是“读”太猛还是“写”太凶。
二、 揪出“罪魁祸首”:到底是谁在疯狂读写?
知道磁盘满了还不够,我们必须抓出具体是哪个服务、哪个进程在搞鬼。
1. 实时排查:iotop
iotop 就像是针对磁盘读写的任务管理器:
iotop -oP-o参数表示只显示真正有读写动作的进程。-P按照进程展示,方便直接看PID。 执行后,谁占用的读写带宽最多,谁就会排在最前面。常见的“凶手”一般是:没有加索引导致全表扫描的数据库(MySQL)、被攻击刷接口导致正在疯狂记录的访问日志(Nginx/Apache)、或者某个死循环写入的后台定时任务。
2. 进程细化追踪:pidstat -d 1
如果你没装 iotop,系统自带的 pidstat 也非常好用:
pidstat -d 1它能清晰列出每个进程每秒的读写速率(kB_rd/s, kB_wr/s),一眼就能锁定元凶。
3. 找出具体写了哪个文件:lsof
假设你发现进程 PID 是 12345(比如是Java程序),想知道它到底在写什么文件导致IO暴增,直接敲:
lsof -p 12345 | grep -E "REG|DIR"或者利用 /proc 目录:
ls -l /proc/12345/fd顺藤摸瓜,你就能看到那个正在疯狂膨胀的临时文件或者错误日志。
三、 治标又治本:切实可行的优化策略
排查出问题之后,不能每次都靠重启服务解决。想要彻底摆脱卡顿,需要从系统、应用架构和硬件三个层面做优化。
1. 系统与内核调优
-
修改磁盘调度算法 不同的磁盘介质适合不同的调度策略:
- 机械硬盘(HDD):推荐
deadline或mq-deadline,能有效防止某些读取请求饿死。 - 固态硬盘(SSD / NVMe):推荐
none(或noop)。因为SSD没有机械寻道时间,操作系统直接把请求丢给磁盘自身的控制器处理性能最好。 - 查看当前调度器:
cat /sys/block/sda/queue/scheduler - 临时修改:
echo none > /sys/block/sda/queue/scheduler
- 机械硬盘(HDD):推荐
-
调整系统刷脏页(Dirty Pages)策略 Linux默认会把写操作先缓存在内存里,等达到一定比例再批量刷到磁盘上。如果配置不当,系统会在积攒了大量数据后突然来一次“大扫除”,直接把IO打死几秒钟。 编辑
/etc/sysctl.conf,微调以下参数让刷盘更平滑:# 当脏页占用内存达到 5% 时,后台异步线程就开始往磁盘写,避免积攒过多 vm.dirty_background_ratio = 5 # 当脏页达到 15% 时,强行阻塞前台写操作并全力刷盘(根据内存大小灵活设置) vm.dirty_ratio = 15执行
sysctl -p生效。
2. 应用层与架构优化(最有效的方式)
- 日志写入改为异步或限流
很多网站卡死不是业务量大,而是错误日志被刷爆了。
- 关闭 Nginx 的静态资源(图片、css、js)访问日志:
access_log off;。 - 开启日志缓冲:
access_log /path/to/log.log combined buffer=32k flush=5s;,让日志攒够32KB或每隔5秒统一写一次,大幅降低磁盘写入频次。
- 关闭 Nginx 的静态资源(图片、css、js)访问日志:
- 为数据库减轻负担
- 加缓存:把高频读取但变动不大的数据丢进 Redis 或 Memcached,不让请求直接穿透到磁盘。
- 查慢查询:开启 MySQL 的慢查询日志(
slow_query_log),把没有命中索引、触发全表磁盘扫描的SQL统统重写优化掉。
- 利用内存盘(tmpfs)
如果程序频繁生成大量的临时图片验证码、小会话文件,可以直接挂载一个内存目录把文件放进去,速度提升成百上千倍:
mount -t tmpfs -o size=512m tmpfs /tmp/ramdisk
3. 硬件与基础设施升级
- 换盘是最暴力的解决方案 如果你的服务器还在用云厂商最便宜的普通云盘或者老旧的机械硬盘,随随便便几十个突发并发就可能让IO队列排成长龙。换成 Enterprise NVMe SSD,IOPS(每秒读写次数)能从几百直接飙升到几万甚至几十万,90%的排查和折腾在绝对的硬件性能面前都可以直接省去。
- 读写分离与动静分离 把静态资源(图片、视频、下载包)全部剥离到对象存储(如OSS/COS)并套上CDN,让核心服务器的磁盘只专心处理业务数据。
四、 运维视角的补充提醒
对于做网站和SEO的朋友来说,磁盘IO瓶颈还有一个致命隐患——它会悄悄拉垮你网站的TTFB(第一字节到达时间)。搜索引擎爬虫在抓取网页时,如果遇到磁盘读写拥堵,等待后端响应超过一两秒,抓取频次会断崖式下跌,排名也会连带受挫。
养成习惯,给服务器配置一个基础监控(如 Prometheus + Grafana 或云厂商自带的告警),把 iowait > 20% 和 disk_util > 80% 设为告警阈值。在用户察觉到卡顿之前提前介入排查,才是最稳妥的运维之道。
相关文章
- 怎么关闭Windows不必要的后台服务:按场景精简清单与避坑指南
- 系统垃圾怎么清理最干净?不装流氓软件的原生命令与脚本实操
- 电脑运行卡顿怎么排查原因?一线运维教你四步定位硬件与进程瓶颈
- Windows更新后变卡了怎么办:排查后台索引与回退补丁实操
- 怎么禁用开机启动项提升速度?Windows与Linux全场景排查实操
- 固态硬盘怎么优化才能发挥性能:Windows与Linux实操调优方案
- 电脑CPU占用过高怎么解决?直接上手的排雷步骤与命令行方案
- 系统响应慢是什么原因?一线运维的四步排查与解决实操
- Windows defender怎么关闭不影响系统?运维老兵的4套稳妥实操方案
- 怎么优化电脑游戏性能?系统设置与硬件调优的落地排查方案