
分布式系统负载均衡调优:流量一大就崩?教你把它分匀了
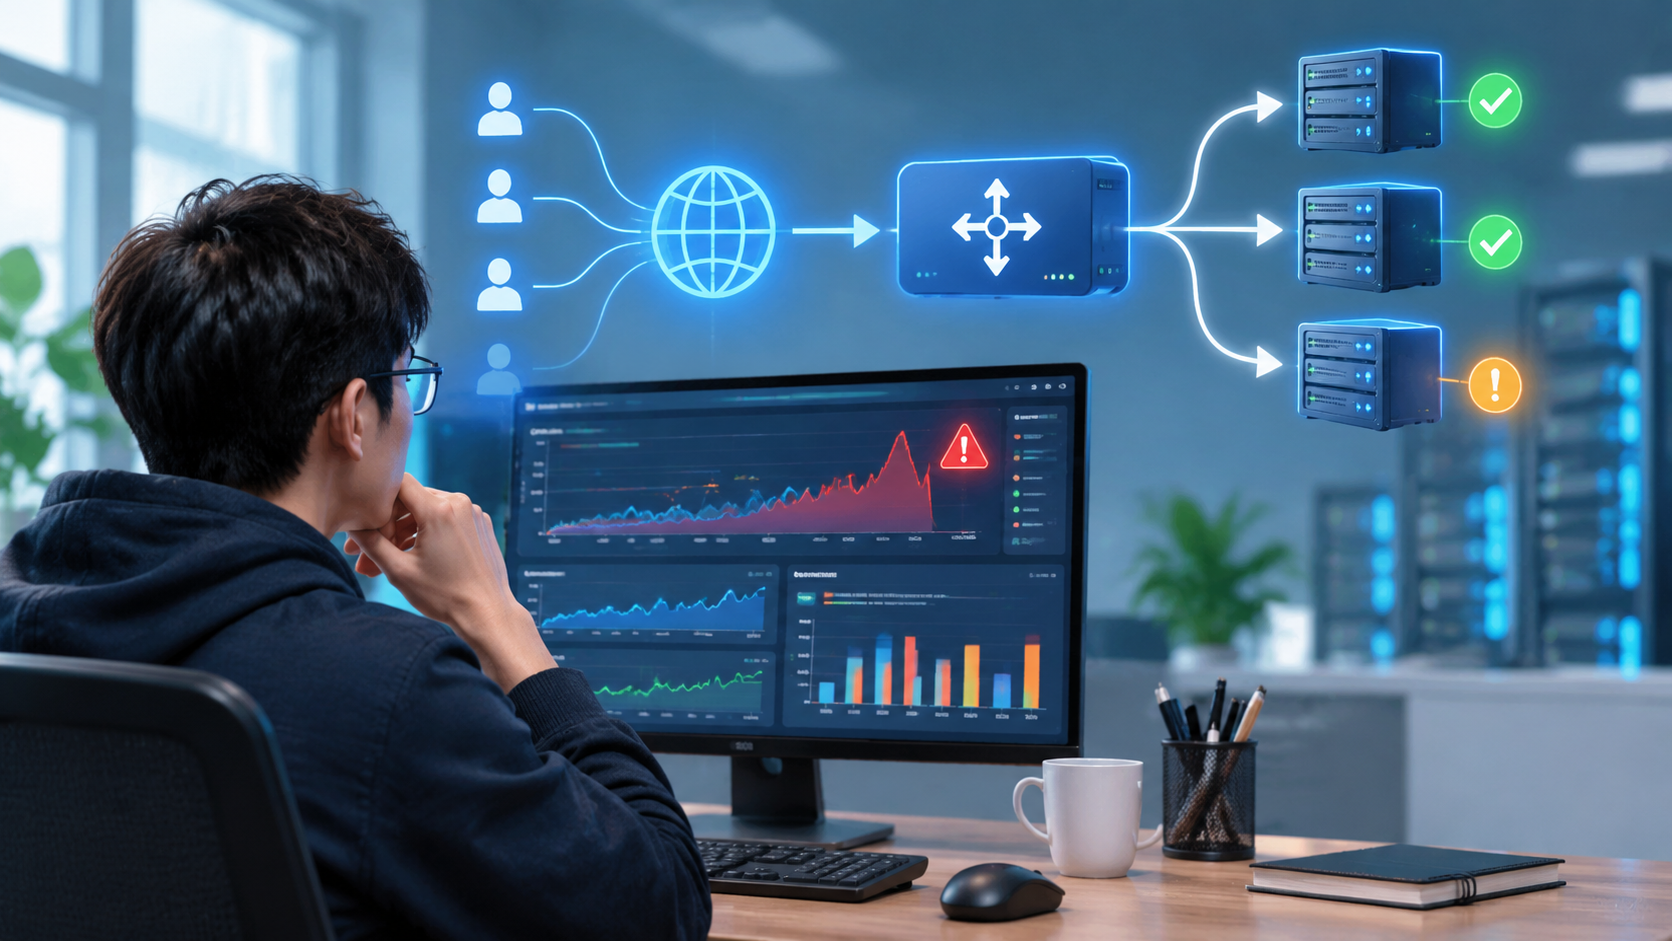
在很多后端和运维同学的日常排错中,最让人头疼的场景莫过于:监控报警器狂响,一台机器 CPU 飙到了 100% 频繁死机,而旁边几台同配置的节点却闲得打瞌睡。出现这种“旱的旱死、涝的涝死”的情况,核心根源往往在于缺乏合理的分布式系统负载均衡调优。很多人以为把 Nginx 装上、配置一个默认的轮询策略就完事了,但当真正面对高并发大流量、长短连接混用或者微服务复杂拓扑时,系统往往会瞬间被打回原形。要让多台机器平稳发挥出最大的吞吐能力,必须从网络层、代理层到业务层进行体系化的性能调优。
一、 策略选型:别再无脑用默认轮询了
负载均衡的第一步,也是最容易翻车的地方,就是调度算法与实际业务场景脱节。许多系统之所以流量倾斜,是因为算法根本不知道后端机器的实际负载。
- 短连接 HTTP 接口:善用“加权最小连接数”(Weighted Least Connections)
默认的轮询(Round Robin)完全假设每个请求的处理时间是一样的。但现实中,有的请求查一下缓存 2 毫秒返回,有的请求做复杂聚合查询要 2 秒。一旦几台机器倒霉分到了多个长耗时请求,队列立刻堆满。换用最小连接数策略,负载均衡器会动态检测哪个后端节点的活跃连接少,就把新请求丢过去,能立竿见影地平抑 CPU 差异。 - 需要用户状态的场景:从 Source IP Hash 迁移到“一致性哈希”
根据客户端 IP 取模做负载会导致两个大坑:一是大量办公网走同一出口 IP 时,请求全砸在同一台机器;二是后端机器一旦扩缩容,全量哈希重新计算,缓存瞬间大面积雪崩。引入一致性哈希(Consistent Hashing)并配合足够的虚拟节点(Virtual Nodes),既能保证同一用户请求路由的稳定性,又能在节点增减时把流量波动控制在极小范围内。
二、 核心传输调优:四层与七层的参数打磨
很多时候负载均衡器本身成为了性能瓶颈,不是机器不行,而是系统内核和软件配置限制了吞吐量。
- 四层(LVS/IPVS/HAProxy)调优
四层主要负责在 TCP/UDP 层分发,吞吐极大,优化关键在于网络连接跟踪表与端口复用。- 调大 conntrack 表:高并发下如果
nf_conntrack: table full, dropping packet,客户端会疯狂超时重试,引发滚雪球崩溃。需要根据内存大小调大net.netfilter.nf_conntrack_max。 - 释放 TIME_WAIT 端口:开启
net.ipv4.tcp_tw_reuse,防止端口耗尽导致无法与后端节点建立新连接。
- 调大 conntrack 表:高并发下如果
- 七层(Nginx/Envoy)长连接复用(Keepalive)
七层负责根据域名、URL、Header 分流,需要解析应用层协议。这里最常见的运维灾难是:前端开了 Keepalive,后端却用了短连接。
如果 Nginx 每次把请求转给 upstream 都要经历三次握手和四次挥手,系统的 CPU 会被大量的软中断吃满,并发直接腰斩。务必在 upstream 配置块中显式指定keepalive连接池大小,并在 location 块中设置proxy_http_version 1.1;与proxy_set_header Connection "";,保持长连接复用。
三、 避免雪崩:健康检查与“权重慢启动”
调优不仅仅是加速,更重要的是容灾时的流量平稳过渡。
- 健康检查的平滑容错
不要把健康检查的阈值设得太激进。如果一台机器因为短暂的 GC 停顿了 1 秒,负载均衡器立刻把它踢掉,原本属于它的流量就会瞬间拍到其余机器上,导致下一台也被压垮,形成“多米诺骨牌式”连环雪崩。推荐配置“失败 3 次才剔除,成功 2 次才上线”的缓冲机制,并且探针超时时间要略大于 P99 的业务耗时。 - 上线节点的“慢启动”(Slow Start)
当一台全新节点冷启动上线(或者老节点刚故障恢复),它的 JVM 还没 JIT 预热、本地缓存还是空的、连接池也没拉起。如果瞬间被分到 20% 的大流量,极大概率会被直接打死。像 Nginx Plus、Envoy 等现代负载均衡器都支持slow_start配置,让节点的权重在几分钟内从 0 线性增加到 100%,给新节点留出充足的预热时间。
四、 架构层解耦:摘除负载均衡的“紧箍咒”
有时候负载均衡调不动,根本原因在应用架构上。最典型的就是“Session 粘滞(Sticky Session)”。
为了识别登录状态,早期做法是让负载均衡通过 Cookie 把特定用户永远固定在特定服务器上。这种方案直接让所有精细化调优的调度算法形同虚设。
- 解法:推进系统的彻底无状态化。把 Session 剥离出来下沉到高可用 Redis 集群中,或者直接改用无状态的 JWT(JSON Web Token)。当后端每个服务节点都变成“随时可丢弃、随时可替换”的计算单元时,负载均衡器才能毫无顾忌地根据各节点的真实算力进行最极致的流量调度。
五、 迈向智能化:引入自适应指标
如果传统的静态权重已经无法满足业务波动,下一步调优应当走向自适应负载均衡(Adaptive Load Balancing)。
传统的健康检查只能知道节点“活没活着”,不知道节点“累不累”。像 gRPC、Dubbo、Envoy 等微服务组件现在都支持基于 EWMA(指数加权移动平均算法)的峰值延迟调度。负载均衡客户端会实时统计每个后端的 P99 响应耗时与处理中的排队请求数(In-flight Requests)。当某个后端节点由于磁盘 IO 阻塞或者数据库慢查询导致响应延迟变大,调度器就会自动下调该节点的请求比例,直到其耗时恢复正常。
总结
真正的负载均衡调优绝非一条单独的配置指令,而是一套贯穿流量全链路的工程实践:用精准的算法适配业务特征,用内核参数和长连接榨干代理层性能,用慢启动与健康检查构筑稳定性护城河,最终通过无状态化与自适应指标释放集群的整体弹性。只有把这些细节逐一压实,系统面对突发流量波峰时才能真正做到波澜不惊。
相关文章
- 电脑越用越卡怎么优化?老运维教你用原生命令定位卡顿元凶
- Windows11系统怎么优化最流畅?干掉后台臃肿与卡顿的实操方案
- C盘满了怎么清理不删系统文件:靠自带工具与软链接安全腾空间
- 电脑开机慢怎么解决?排查启动项、系统服务与硬盘瓶颈的实操方法
- 系统内存占用过高怎么办:从进程定位到缓存释放的排查方案
- Windows10怎么优化提升性能?老运维总结的纯原生提速实操
- 虚拟内存怎么设置最好?Windows与Linux实操方案及避坑
- 怎么关闭Windows不必要的后台服务:按场景精简清单与避坑指南
- 系统垃圾怎么清理最干净?不装流氓软件的原生命令与脚本实操
- 电脑运行卡顿怎么排查原因?一线运维教你四步定位硬件与进程瓶颈