
动态渲染Dynamic Rendering技术实现:搞定JS页面收录:动态渲染实战
在如今以 Vue、React、Angular 等前端框架主导的单页应用(SPA)时代,很多做技术和运营的团队都会踩到一个大坑:网站做得又快又炫酷,但搜索引擎收录却惨不忍睹。国内的百度、神马等爬虫对客户端 JavaScript 的解析能力始终不稳定,即使强如 Googlebot,在执行昂贵的 JS 渲染队列时也会消耗巨大的抓取预算。为了在不推翻现有前端架构、不花大代价重组成服务端渲染(SSR)的前提下彻底解决收录痛点,动态渲染Dynamic Rendering技术实现便成了当下最具性价比、落地最快的高阶技术方案。
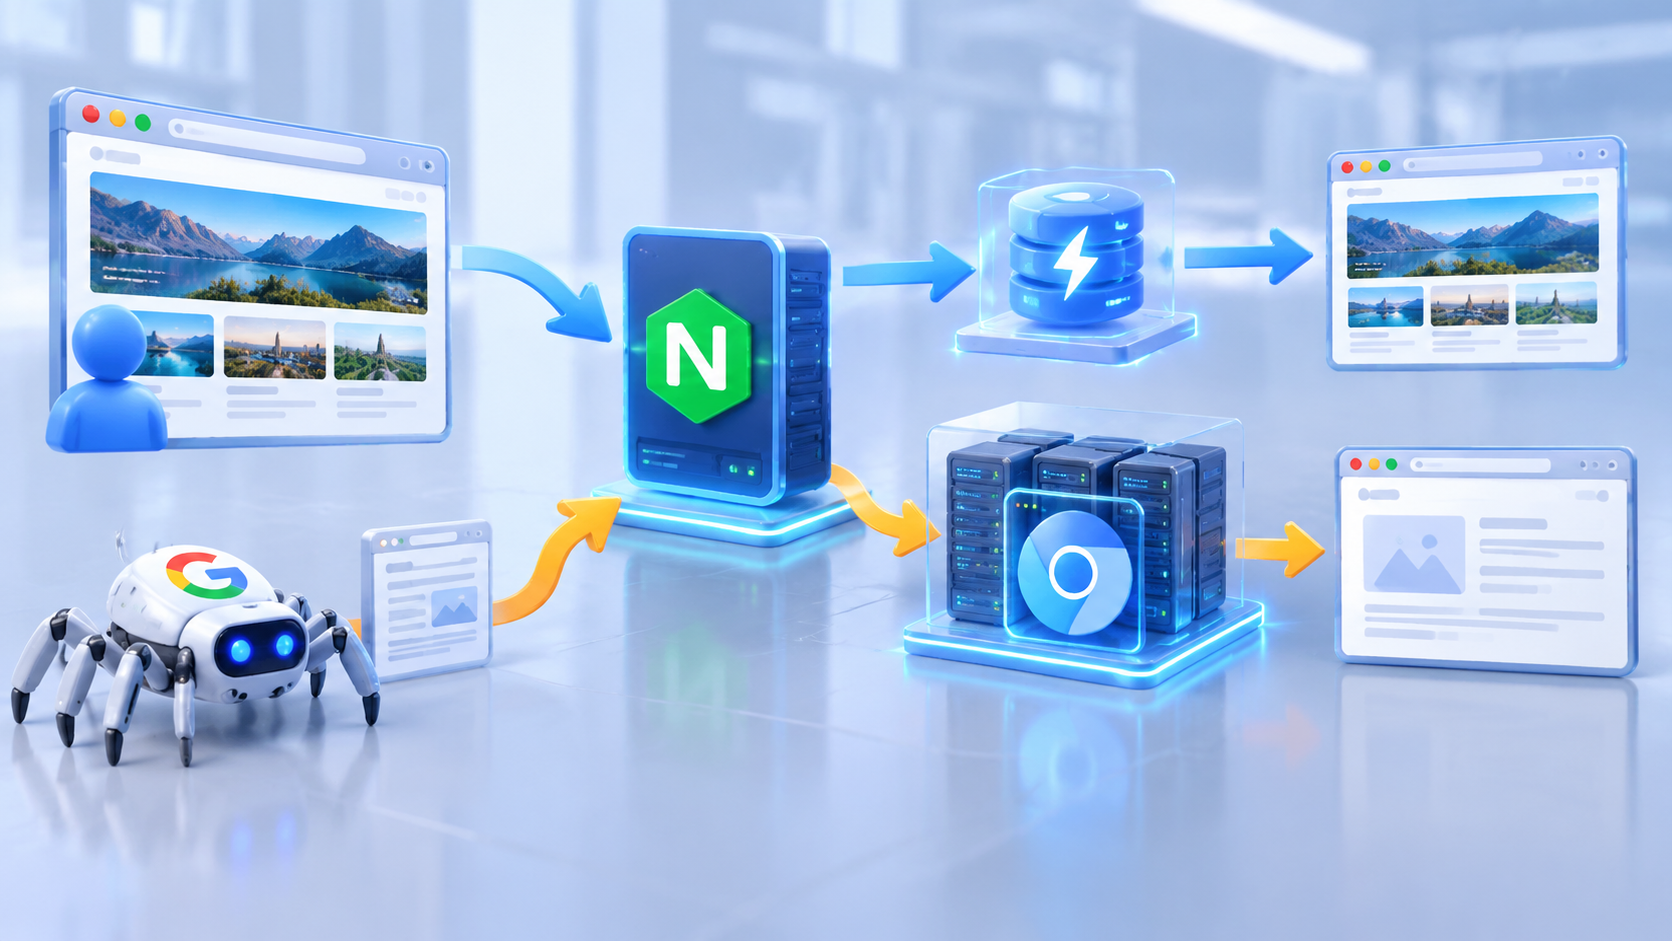
简单来说,动态渲染的核心逻辑就是“看人下菜碟”:当普通用户访问时,服务器照常返回轻量、富交互的客户端渲染(CSR)页面;而当监测到是搜索引擎爬虫访问时,网关则将请求拦截,路由给后台的无头浏览器,将其渲染完毕生成的纯 HTML 和静态内容直接喂给爬虫。下面,我们将从技术架构、网关配置、无头渲染集群搭建到缓存策略,全方位拆解这一技术的落地方案。
一、 核心架构设计:动态渲染的三层漏斗
要跑通一套生产级的动态渲染系统,不能单靠一个简单的脚本,而是需要搭建一个具备高可用、抗压能力的“三层漏斗”架构:
- 流量识别层(网关/反向代理): 通常由 Nginx、OpenResty 或 CDN(如 Cloudflare Workers)充当守门人。通过解析 HTTP 请求头中的
User-Agent,区分普通用户与爬虫。 - 缓存分流层(KV/内存存储): 爬虫的抓取具有瞬时并发高的特点,绝对不能让每个爬虫请求都穿透到后台无头浏览器。利用 Redis 或 CDN 边缘缓存,对渲染出的静态 HTML 进行缓存。
- 渲染引擎层(Headless Service): 基于 Puppeteer、Playwright 或现成方案(如 Prerender、Rendertron)构建的无头浏览器集群,负责加载 JS、执行 API 数据请求,并将最终生成的 DOM 树序列化为字符串输出。
二、 网关路由实现:Nginx 的爬虫嗅探与拦截
实现的第一步,是在 Web 服务器最前端精准捕获爬虫。以高并发场景下最常用的 Nginx 为例,我们可以通过配置 Map 指令建立爬虫识别规则。
在 nginx.conf 中加入以下配置:
http {
    # 匹配常见搜索引擎爬虫的 User-Agent
    map $http_user_agent $is_crawler {
        default 0;
        ~*Baiduspider 1;
        ~*Googlebot 1;
        ~*bingbot 1;
        ~*360Spider 1;
        ~*YisouSpider 1;
        ~*Sogou 1;
    }

    server {
        listen 80;
        server_name example.com;

        location / {
            # 排除静态资源,仅拦截页面路由
            if ($uri ~* \.(js|css|png|jpg|jpeg|gif|ico|svg|woff|woff2|ttf)$) {
                set $is_crawler 0;
            }

            # 如果是爬虫,将请求反向代理到渲染服务或缓存中间层
            if ($is_crawler = 1) {
                rewrite ^(.*)$ /render?url=$scheme://$host$request_uri break;
                proxy_pass http://render-service-cluster:3000;
            }

            # 普通用户直接走原有的前端静态构建产物
            try_files $uri $uri/ /index.html;
        }
    }
}通过这一步,普通用户体验完全不受影响,资源消耗保持在静态托管的极低水平;而所有的爬虫请求被精准剥离出来,送往后端渲染管道。
三、 渲染引擎与性能把控:基于 Puppeteer 的落地
后台渲染服务最忌讳的是“资源泄露”和“无限等待”。无头 Chromium 是极度消耗 CPU 和内存的重型应用,必须进行严格的生命周期控制与资源拦截。
基于 Node.js + Puppeteer 构建的渲染服务,必须做好以下几点:
- 拦截非必要静态资源: 爬虫只需要 HTML 结构和文本、元数据(TDK),渲染时必须在代码中拦截图片、字体文件、样式表和统计打点代码,避免浪费时间和带宽。
- 生命周期控制与超时中断: 设置
networkidle2(网络连接不超过2个)作为页面加载完成标志,并强制配置最大超时(例如 6-8 秒),超时则降级返回基础 HTML,防止进程假死。 - 池化管理: 使用通用连接池(如
generic-pool)管理浏览器实例或 Tab 页签,避免频繁启停进程打崩内存。
// 渲染核心逻辑示例
const puppeteer = require('puppeteer');

async function renderPage(targetUrl) {
    const browser = await puppeteer.launch({
        args: ['--no-sandbox', '--disable-setuid-sandbox', '--disable-dev-shm-usage']
    });
    const page = await browser.newPage();

    // 启用请求拦截,砍掉多余开销
    await page.setRequestInterception(true);
    page.on('request', (req) => {
        const resourceType = req.resourceType();
        if (['image', 'stylesheet', 'font', 'media'].includes(resourceType)) {
            req.abort();
        } else {
            req.continue();
        }
    });

    try {
        await page.goto(targetUrl, { waitUntil: 'networkidle2', timeout: 8000 });
        // 获取完整的 DOM
        const html = await page.content();
        return html;
    } finally {
        await page.close();
        await browser.close();
    }
}
四、 避坑指南:DevOps 与 SEO 的权衡细节
搞动态渲染,如果缺乏经验,极其容易将技术方案做成“降权自杀”。运维与技术 SEO 专员必须密切协同,关注以下三个核心隐患:
1. 严格防范作弊嫌疑(Cloaking 风险)
动态渲染并不是黑帽 SEO 里的“障眼法(Cloaking)”,Google 官方早已明确支持该方案,但有一个铁律:爬虫看到的网页主体内容,必须与真实用户看到的完全一致。 绝对不能为了拉高关键词密度,而在渲染引擎层给爬虫额外拼接隐藏链接、堆砌无意义的文本。一旦被算法判定为内容欺骗,整个域名将遭遇毁灭性降权。
2. 构建严密的缓存与失效机制(Stale-While-Revalidate)
千万别把渲染引擎暴露给爬虫直接打!如果百度蜘蛛突然来抓几十万个深度页面,后台 Node 节点会在几分钟内因为内存溢出(OOM)集体崩溃。
- 分级缓存: 渲染后的 HTML 必须入 Redis,设置至少 24 小时到数天的过期时间。
- 主动失效: 当后台文章、产品数据发生编辑更新时,通过发布系统 Hook 异步调用清理对应 URL 的 Redis 缓存,保证下次爬虫来访时重新拉取最新快照。
3. 状态码与 HTTP Headers 的保真传递
SPA 项目在处理 404 或 500 页面时,前端路由通常依然会返回一个 HTTP 200 状态码外加一个“页面不存在”的 UI。爬虫如果抓取到带 200 状态的空页面,会导致海量死链无法被搜索引擎正常注销,进而严重稀释整站权重。
在动态渲染方案中,必须在前端全局路由注入状态标识(例如在 <head> 里写入 <meta name="prerender-status-code" content="404">),后端无头浏览器在解析到该 Meta 标签后,透传响应真正的 404 Not Found 状态码给爬虫。
五、 效果验证与日常运维监控
技术落地后,必须建立持续的监控和验证闭环:
- 本地模拟验证: 随时通过带有 UA 伪造的终端命令测试返回结果:
curl -A "Baiduspider+" -i https://example.com/your-spa-page检查响应头是否命中缓存,返回体是否已经去除了 JS 加载骨架屏,包含了直接可见的纯文本和完整元数据(Meta Title/Description/H1)。
- 日志监控与白名单校对: 必须监控 Nginx 访问日志中爬虫的响应状态分布,同时在反向代理层通过反向 DNS 解析(RDNS)校验高频访问的“爬虫”是不是真正的官方蜘蛛,避免第三方恶意采集器伪造 UA 恶意穿透无头渲染服务,将宝贵算力消耗殆尽。
动态渲染是一项典型的“以空间换架构时间”的优雅技术。它不破坏前端团队现有的工程化体验,又在基础设施层面用最小的代价彻底抹平了客户端渲染与搜索引擎爬虫之间的鸿沟。只要做好网关分流、算力隔离与缓存守护,单页应用也能获得与传统静态页面完全一致的收录效率与权重增长。
相关文章
- 内链拓扑结构对百度蜘蛛抓取深度的影响:别让稀烂的内链,把百度蜘蛛挡在网站大门外
- 网站百度蜘蛛抓取量断崖式下跌原因剖析:百度蜘蛛不爬了?老站长教你排雷
- 智能DNS解析针对百度蜘蛛独立配置线路:别让延迟毁了收录,DNS分流实战
- 降低百度蜘蛛抓取耗时的服务器优化方案:百度蜘蛛抓取慢?老站长的服务器提速心法
- URL重写伪静态对百度蜘蛛抓取效率的影响:伪静态:别让URL毁了你的收录
- 黑帽蜘蛛池诱导抓取与正规SEO的区别:蜘蛛池诱导与正规SEO实战录
- 网站改版301重定向引导百度蜘蛛权重转移:网站改版301权重转移实战指南
- 百度小程序爬虫与普通网页蜘蛛抓取差异:小程序与网页蜘蛛抓取实战避坑
- 新站TDK标签规范设置:新站做SEO,TDK到底该怎么填
- 网站初期核心关键词挖掘与布局:新站选词难?手把手教你把词定准