
多模态数据对齐与跨模态特征融合难点
跨越语义鸿沟:多模态表征对齐与动态特征融合的深水区挑战
在构建多模态大模型的工程实践中,业内早期普遍依赖于“单模态预训练编码器 + 投影线性层(Linear Projection)+ LLM主干”的拼接架构。这种方案在处理基础的问答和标注任务时表现尚可,但在处理复杂时空推断、细粒度视觉定位或多源异构信息交互时,系统往往会暴露出严重的“模态伪理解”现象。
多模态表征学习的本质,并非简单将视觉、音频与文本信号映射到同一个高维流形空间,而是在于解决不同物理信号之间底层信息密度不对称、时空结构失配以及表示空间坍缩的硬核数学与工程问题。
一、 语义粒度失配与非对称对齐的理论困境
多模态对齐的首要阻碍是信息密度的天然失衡。
- 文本信号:经过人类数千年演化的高度符号化抽象,信息熵极高,几乎每个Token都携带着浓缩的语义节点;
- 视觉与连续音频信号:属于高维度低熵的感知数据,存在大量像素级冗余(如背景噪声、重复纹理)。
以经典的对比学习(如CLIP范式)为例,模型通过余弦相似度拉近图文正样本对的距离,拉远负样本对。但在细粒度场景下,这种全局对比会迅速失效。一段文字“一只被红绳系住爪子、卧在湿润草地上的灰羽鸽子”,其对应的图像可能占满画面的仅是草地,鸽子只占局部数个Patch。
若采用硬对齐(Hard Global Alignment),模型会被迫将图像整体特征与文本强行绑合,导致局部细粒度实体特征被背景噪声淹没。即便引入最优传输理论(Optimal Transport, OT)或交叉注意力机制实现Token级“软对齐”,双向注意力的计算开销($O(N \cdot M)$)又会在高分辨率视觉Token场景下迅速击穿显存预算。如何设计低秩分解或稀疏锚点机制,在高信息密度与稀疏冗余之间实现动态语义缩放,仍是学术界与工业界反复权衡的死穴。
二、 跨模态特征融合中的“模态竞争”与表示坍缩
当进入特征融合阶段(Cross-Modal Fusion),系统往往需要通过深度交互层(如交叉注意力、门控机制或张量积运算)实现跨模态推理。然而,在端到端的梯度反向传播中,模态竞争(Modality Competition)构成了致命陷阱。
通常情况下,文本模态在语言模型预训练阶段已经构建了极其稳固的流形结构,其损失函数(Loss)梯度下降路径比未充分泛化的视觉或音频特征平滑得多。在优化目标驱动下,联合训练机制极易演变为“语言先验主导”,而视觉特征退化为旁路特征,甚至发生严重的模态坍缩(Modality Collapse)。模型表面上做出了正确预测,实际上仅凭借文本Prompt中的统计规律进行了黑盒“猜测”,并未真正调用视觉表征中的空间结构信息。
此外,直接拼接(Concatenation)或逐位相加(Element-wise Addition)在数学上默认了不同模态的潜空间(Latent Space)是正交或同胚的,但不同模态特征分布的异构性会导致几何失真。
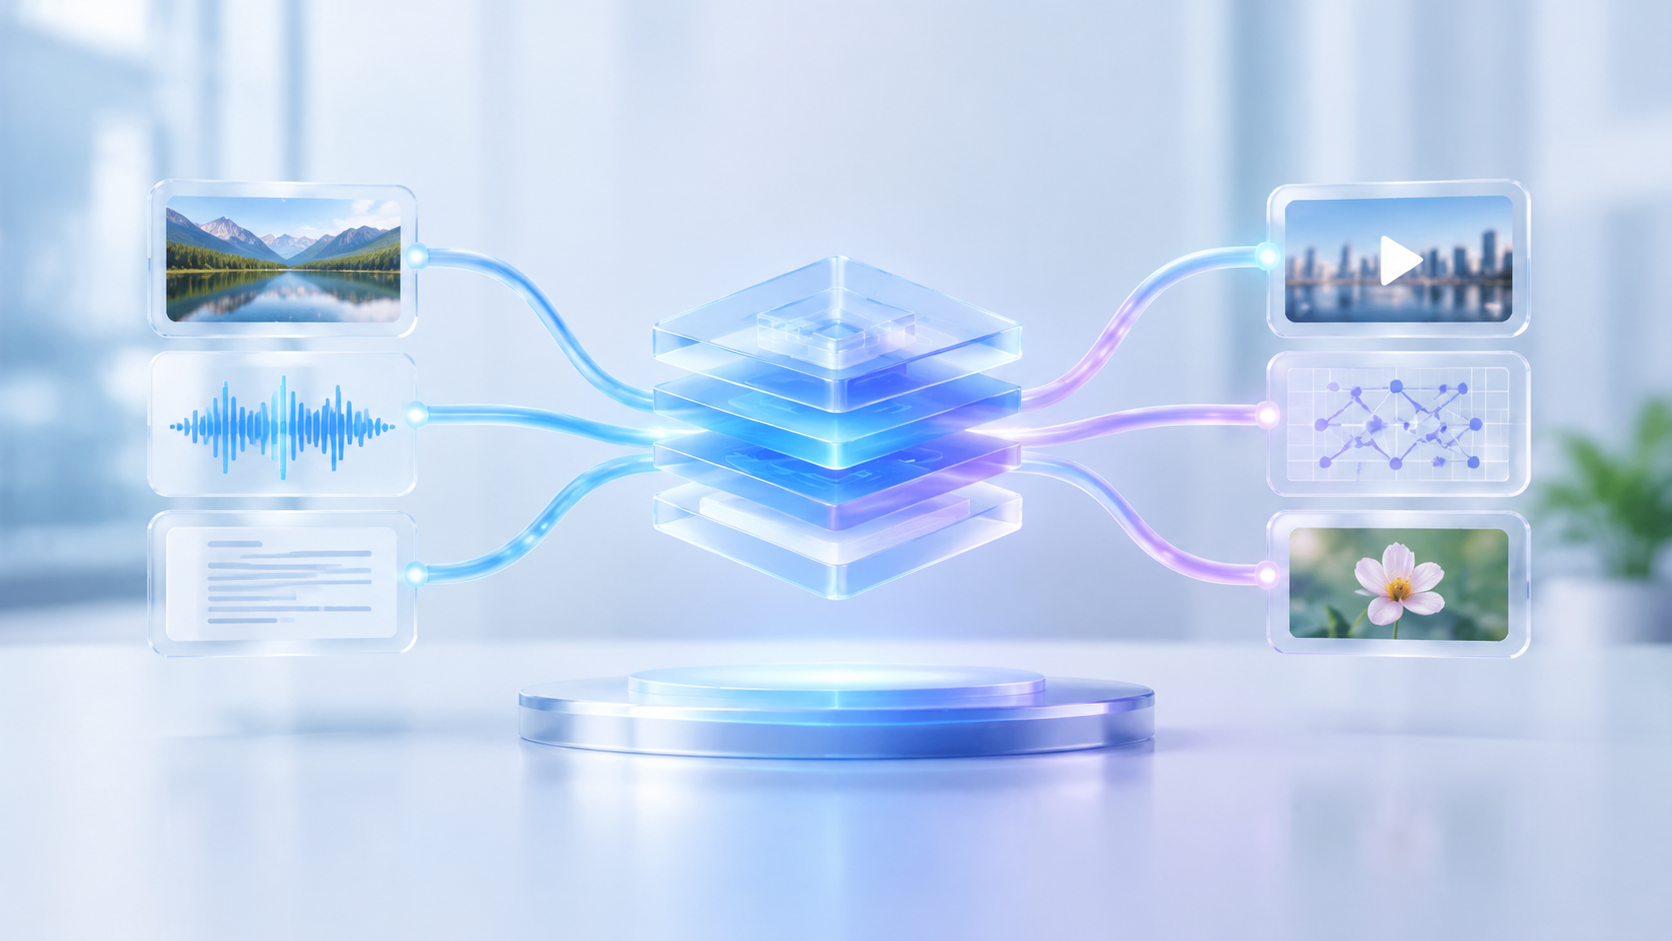
下面这张概念架构图展示了多维异构感知流经非线性投影层后,在统一潜空间中如何通过动态拓扑结构进行交叉聚合与梯度隔离的逻辑演进:
相关文章
- 非结构化文档RAG切片策略优化:非结构化文档RAG切片优化
- Dify与FastGPT私有化部署对比测评:Dify与FastGPT实测
- 大模型API接口限流与重试机制设计:大模型API限流与重试实战
- AI代码助手内网私有化接入方案:AI代码助手内网私有化实战
- 多模态模型OCR文档解析落地实战:多模态OCR文档解析实战指南
- GPU算力服务器Docker环境快速配置:GPU算力Docker快速配置
- 大模型幻觉检测与内容安全过滤:搞定大模型幻觉与内容安全过滤
- 企业级AI智能客服低代码搭建流程:企业AI智能客服低代码实操
- DeepSeek接口接入现有业务系统实操:DeepSeek接口接入实操
- Ahrefs API结合大模型挖掘内容Gap:别导表了,让AI自动扒对手词