
非结构化文档RAG切片策略优化:非结构化文档RAG切片优化
做非结构化文档RAG切片策略优化,千万别再盲信教程里无脑写死的 chunk_size=500 硬切了,直接落地“版面还原清洗 + 结构语义动态切分 + 父子索引回溯 + 元数据前置注入”这套四步组合拳,才能真正解决召回碎片化、上下文丢失的问题。
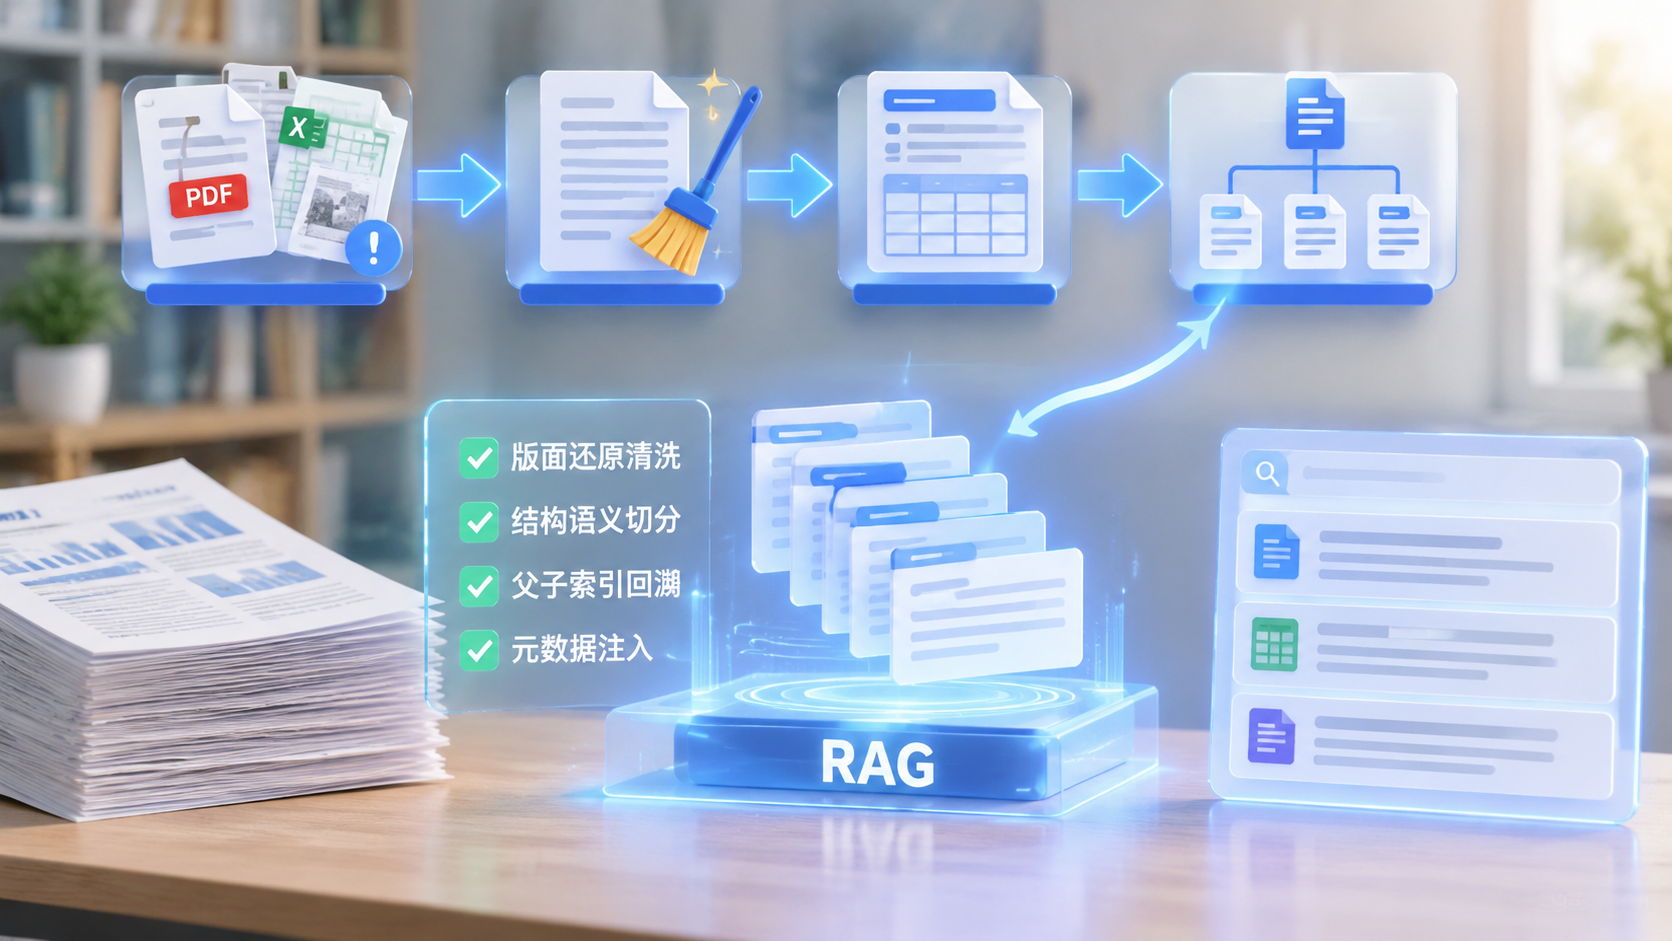
现在网上一堆 RAG 入门教程,换个大模型、调个 Prompt 吹得天花乱坠,一问底层切片怎么做的,清一色 RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50) 一把梭。结果到了企业真实环境,几百页的 PDF 合同、带合并单元格的财务报表、扫码歪斜的扫描件往库里一丢,切出来的全是一半表头、一半废话的残次品。垃圾进,垃圾出,切片这一步没做好,后面挂再贵的 GPT 或 Claude 也是瞎编。
核心方案速览
不同脏乱程度的文档,切法完全不一样。别指望一套参数吃遍天下,直接按下面这套场景对照表对号入座:
- 规章制度、技术手册、产品白皮书(有明确目录层级)
- 核心策略: 转成 Markdown 后按标题层级(H1/H2/H3)切分 + 局部滑窗微调。
- 适用场景: 条款清晰、章节逻辑强,问题通常指向具体某条规定。
- 财报、产品参数表、报价单(含大量表格与多栏排版)
- 核心策略: 版面分析工具还原结构 + 表格独立提取 + 超长表格按行切分并强行补齐表头。
- 适用场景: 涉及数值对比、字段查询,最怕一刀切在表格中间导致数据和列名分离。
- 客服录音转写、会议纪要、工单流水(无标点/弱结构/口语化)
- 核心策略: 先做话题聚类或语义相似度切片(Semantic Chunking),必要时先用小模型做一轮“摘要/主题归类”预处理再切。
- 适用场景: 缺乏天然分段标记,按固定字数切极易把一个完整的问答拆成两半。
- 长篇研报、复杂法律合同(既要精准命中,又要完整语境)
- 核心策略: 父子文档索引(Parent-Child)。用 150~250 字的小切片做向量检索,命中后把对应的 800~1200 字父切片(甚至整段)塞给大模型生成。
实操细节深度拆解
1. 前置清洗:切之前先把“PDF 毒瘤”铲干净
很多人直接用 PyPDF2 或 pdfplumber 把文字抽出来就开切,这是第一大坑。PDF 本质上是排版指令集合,不是流式文本,抽出来的文本里充斥着页眉页脚、页码、奇怪的换行符(硬回车)。一段好好的话,每行末尾带个 \n,按段落切直接碎成渣。
避坑实操:正则合并伪换行 + 剔除高频页眉页脚
如果你的文档还没上专门的版面解析模型,至少要在切片前跑一遍清洗脚本,把正文里被强行折断的行连起来,同时保护好真正的标题和列表:
import re

def clean_unstructured_text(text: str) -> str:
    # 1. 统一换行符,去除不可见控制字符
    text = text.replace('\r\n', '\n').replace('\r', '\n')
    text = re.sub(r'[\x00-\x08\x0b\x0c\x0e-\x1f\x7f]', '', text)

    # 2. 干掉常见的孤立页码(比如单独一行的 "- 12 -" 或 "第 3 页 共 20 页")
    text = re.sub(r'(?m)^\s*[-—]*\s*\d+\s*[-—]*\s*$', '', text)
    text = re.sub(r'(?m)^\s*第\s*\d+\s*页.*$', '', text)

    # 3. 修复PDF提取导致的“段内伪换行”
    # 逻辑:如果当前行不以句号、问号、感叹号、冒号结尾,且下一行不是Markdown标题或列表符号,就合并它们
    lines = text.split('\n')
    merged_lines = []
    for line in lines:
        stripped = line.strip()
        if not stripped:
            merged_lines.append('') # 保留空行作为真段落分隔
            continue

        if merged_lines and merged_lines[-1] != '':
            prev = merged_lines[-1]
            # 判断前一行是否正常结束,以及当前行是否为新结构起点
            is_prev_end = re.search(r'[。!?.!?::;;]$', prev)
            is_curr_struct = re.match(r'^(#{1,6}\s|[-*•]\s|\d+[\.、\)])\s*', stripped)
            if not is_prev_end and not is_curr_struct:
                # 中文直接拼接,英文之间补个空格
                sep = ' ' if re.match(r'^[a-zA-Z0-9]', stripped) and re.search(r'[a-zA-Z0-9]$', prev) else ''
                merged_lines[-1] = prev + sep + stripped
                continue
        merged_lines.append(stripped)

    # 4. 把连续三个以上的空行压缩成两个,方便后续按 \n\n 切分
    cleaned = '\n'.join(merged_lines)
    cleaned = re.sub(r'\n{3,}', '\n\n', cleaned)
    return cleaned.strip()
经验提示: 遇到双栏排版的 PDF,上面这套纯文本提取必然左右串行(左栏第一行接右栏第一行)。遇到这种文件别省事,直接上 MinerU(Magic-PDF)或者 Docling 先把 PDF 还原成标准 Markdown,再进入切片流程,能省掉后面 80% 的扯皮。
2. 结构感知与表格保护:别一刀切碎 Markdown 表格
清洗完转成 Markdown 后,千万别直接拿字符切片器全局平推。一旦遇到超过 chunk_size 的长表格,常规切片器会在第 15 行咔嚓一刀,下半截切片里全是 | 1200 | 35% | 否 |,神仙也不知道这几个数字对应哪一列。
可直接套用的表格安全切分代码:
思路很简单:先把文本里的表格块和普通正文拆开;普通正文按标题+字数切;遇到超长表格,按行拆分,并强制把前两行(表头 + 分隔符)拼到每一个子切片的顶部。
def split_markdown_table(table_text: str, max_chars: int = 600) -> list[str]:
    lines = [line.strip() for line in table_text.strip().split('\n') if line.strip()]
    # 少于3行(没有数据行)或长度没超标,直接整个返回
    if len(lines) < 3 or len(table_text) <= max_chars:
        return [table_text]

    header = lines[0] + '\n' + lines[1]  # 表头和 |---|---| 分隔行
    data_rows = lines[2:]

    chunks = []
    current_chunk_rows = [header]
    current_len = len(header)

    for row in data_rows:
        # 如果加上这一行会超长,且当前块里已经至少有一条数据行,就封箱切新块
        if current_len + len(row) + 1 > max_chars and len(current_chunk_rows) > 1:
            chunks.append('\n'.join(current_chunk_rows))
            current_chunk_rows = [header, row] # 新块强行带上表头
            current_len = len(header) + len(row) + 1
        else:
            current_chunk_rows.append(row)
            current_len += len(row) + 1

    if len(current_chunk_rows) > 1:
        chunks.append('\n'.join(current_chunk_rows))
    return chunks
避坑点: 很多时候 PDF 转出来的表格是 HTML 格式(<table><tr>...),千万别直接把 HTML 标签粗暴 strip 掉变成纯空格文本,那样列对齐全没了。大模型对 HTML 表格和 Markdown 表格的理解力远高于纯空格对齐的文本。超长 HTML 表格同理,解析出 <thead> 塞到每个切分后的 <table> 块里即可。
3. 落地“父子索引(Parent-Child)”:兼顾召回率与上下文完整
做非结构化文档RAG切片策略优化时,工程师最常陷入一个死循环:
- 切片设小了(比如 150 字),向量匹配极准,但喂给大模型时缺前因后果,大模型回答不完整;
- 切片设大了(比如 1500 字),上下文是全了,但一段话里塞了五六个不相关的概念,算出来的向量被严重“稀释”,压根检索不到!
破局方法只有一个:检索归检索,生成归生成(Small-to-Big)。
实操步骤:
- 切父块(Parent Chunk): 按章节或 800~1200 字切出大块,存入关系型数据库或 KV 存储(如 PostgreSQL / Redis / MongoDB),生成唯一
parent_id。 - 切子块(Child Chunk): 把每个父块再按 150~250 字(按句号边界)切分成多个子块,子块的
metadata里只存一个字段:{"parent_id": "xxx"}。 - 只对子块做 Embedding: 把子块向量化写入 Milvus / Qdrant / Elasticsearch。
- 检索回溯: 用户提问 -> 检索命中 Top-K 个子块 -> 提取对应的
parent_id并去重 -> 从数据库捞出完整的父块喂给大模型。
import uuid
import re

def build_parent_child_chunks(long_text: str, parent_size: int = 1000, child_size: int = 200):
    # 1. 先按段落尽量凑出父块(这里简化按字数和双换行边界)
    paragraphs = [p.strip() for p in long_text.split('\n\n') if p.strip()]
    parents = []
    buf = ""
    for p in paragraphs:
        if len(buf) + len(p) > parent_size and buf:
            parents.append(buf.strip())
            buf = p
        else:
            buf = (buf + "\n\n" + p).strip()
    if buf:
        parents.append(buf)

    parent_store = {} # 实际生产存 Redis / Postgres
    child_docs = []   # 实际生产做 Embedding 进向量库

    for p_text in parents:
        p_id = str(uuid.uuid4())
        parent_store[p_id] = p_text

        # 2. 按中文句末标点将父块切分为细粒度子块
        sentences = re.split(r'(?<=[。!?.!?\n])', p_text)
        c_buf = ""
        for sent in sentences:
            if not sent.strip():
                continue
            if len(c_buf) + len(sent) > child_size and c_buf:
                child_docs.append({"text": c_buf.strip(), "parent_id": p_id})
                c_buf = sent
            else:
                c_buf += sent
        if c_buf.strip():
            child_docs.append({"text": c_buf.strip(), "parent_id": p_id})

    return parent_store, child_docs
实测踩坑提示: 回溯父块后,一定要对 parent_id 做去重! 不然 Top-5 命中了同一个父块下的 4 个子块,你把同一段 1000 字的父块往 LLM 的 Prompt 里塞 4 遍,既烧 Token 又把大模型绕晕。
4. 元数据前置注入:消灭“代词失忆症”
经常看到有人把《2025版员工报销管理制度》切完之后,某一个切片开头就是:
“超出标准的,由部门总监审批后方可实报实销,逾期三个月不予受理。”
这段话单独拿去算向量,如果用户问:“2025年员工报销超标了找谁审批?” 向量库大概率排不到前面,因为切片里连“报销”两个字都没有!
直接套用的上下文注入模板:
在切片送去做 Embedding 之前,强行把文档名 + 多级标题路径 + 核心实体拼到切片文本的最前面。注意,是拼进被向量化的文本正文里,而不仅仅是放在 metadata 字典里吃灰!
# 拼装用于 Embedding 的最终文本
embedding_text = (
    f"【文档名称】{doc_title}\n"
    f"【所属章节】{' > '.join(header_hierarchy)}\n"
    f"【片段正文】\n{chunk_text}"
)
别小看这三行前缀,实测在制度类、说明书类知识库里,加上路径前缀后,Top-3 召回命中率能直接提升 15%~25%。
高频关联问题拓展
Q1:中文文档的 chunk_size 和 overlap 到底设多少合适?怎么量化评估?
别听人瞎吹“越多越好”或“BGE-M3 支持 8192 token 就切 4000 字”。
- 经验甜点区: 如果不用父子索引,纯单层切片在中文场景下,
chunk_size建议落在 300~500 汉字(约 400~700 tokens),overlap(重叠)设为chunk_size的 10%~15%(50~80字)。哪怕 Embedding 模型支持长窗口,单块超过 800 字,语义表征能力依然会明显下降。 - 量化评估土办法(别靠感觉): 找业务方拿 30~50 个真实高频问题,人工标出每个问题对应的“标准答案所在原文片段”。写个脚本跑一遍检索,算 Hit Rate@5(前5个结果包含标准片段的比例) 和 MRR(平均倒数排名)。调完切片参数跑一遍脚本,数字涨了再上线,别拍脑袋改配置。
Q2:遇到完全没有标题的“一坨纯文本”(如客服聊天记录、OCR大段白话),怎么切?
硬按字数切一定会把对话切碎。推荐两个低成本方案:
- 基于句向量的语义切片(Semantic Chunking): 按句号拆成单句,挨个算相邻两句(或滑动3句窗口)的余弦相似度。画一条相似度曲线,在相似度骤降的波谷位置下刀。比如前几句都在聊“退货运费”,下一句相似度突然跌破阈值(例如
P20分位数或< 0.55),说明话题切到“发票开具”了,直接在这里断开。 - 先洗后切(适合低频静态知识库): 用便宜的高速小模型(如 Qwen-Turbo、DeepSeek-V3 等),按每 2000 字一批喂给它,Prompt 要求:“在不删减原文核心事实的前提下,为以下口语文本加上语义分段和二级小标题”。用几分钱的算力换极高的知识库质量,这笔账绝对划算。
Q3:为什么切片里加了 chunk_overlap(重叠),检索时还是把关键信息切断了?
因为字符级切片器(哪怕是 RecursiveCharacterTextSplitter)的默认分隔符列表是 ["\n\n", "\n", " ", ""],它默认根本不认识中文句号 。 和分号 ;!
一旦段落超过了 chunk_size,又没有换行符,它就会一路回退到按单字 "" 硬切,直接把一个完整的长句子从中间劈开。
立刻修正配置: 用 LangChain 或手写切片器时,务必显式传入中文标点分隔符:
separators = ["\n\n", "\n", "。", "!", "?", ";", "……", ",", " ", ""]结尾总结
非结构化文档RAG切片策略优化没有什么玄学,本质上就是尊重文档原本的物理版面和语义边界。
明天回公司排查自己线上 RAG 效果差的问题,别急着换大模型,按这三步先检查一遍切片库:
- 把数据库里切出来的 Chunk 打印 20 条出来肉眼看——是不是充满了乱码、断行、无表头的残缺表格?
- 检查分隔符配置里有没有加中文句号,切片头部有没有注入所属文件名和章节路径;
- 如果同时面临“查不准”和“答不全”,立刻把单层切片重构为“小块做检索 + 大块(父块)做生成”的父子索引结构。
把底层的切片颗粒度打磨扎实了,哪怕接个开源 7B/14B 模型,回答准确率也能吊打那些瞎切片的百亿参数方案。
相关文章
- 非结构化文档RAG切片策略优化:非结构化文档RAG切片优化
- Dify与FastGPT私有化部署对比测评:Dify与FastGPT实测
- 大模型API接口限流与重试机制设计:大模型API限流与重试实战
- AI代码助手内网私有化接入方案:AI代码助手内网私有化实战
- 多模态模型OCR文档解析落地实战:多模态OCR文档解析实战指南
- GPU算力服务器Docker环境快速配置:GPU算力Docker快速配置
- 大模型幻觉检测与内容安全过滤:搞定大模型幻觉与内容安全过滤
- 企业级AI智能客服低代码搭建流程:企业AI智能客服低代码实操
- DeepSeek接口接入现有业务系统实操:DeepSeek接口接入实操
- Ahrefs API结合大模型挖掘内容Gap:别导表了,让AI自动扒对手词