
AI代码助手内网私有化接入方案:AI代码助手内网私有化实战
搞AI代码助手内网私有化接入方案,千万别被商业厂商忽悠去买几十万按席位收费的“私有化一体机”,剥开那些外壳里面大概率也是开源模型套了个皮。最务实、低成本且可控的落地路径就一句话:内网GPU服务器部署开源代码模型(vLLM/Ollama) + 统一API网关(LiteLLM/One API)做鉴权与审计 + 开发者IDE端安装开源插件(Continue/Tabby)直连内网网关。整套架构代码绝对不出内网,硬件一次性投入,后续增减人数零软件成本,半天就能跑通上线。
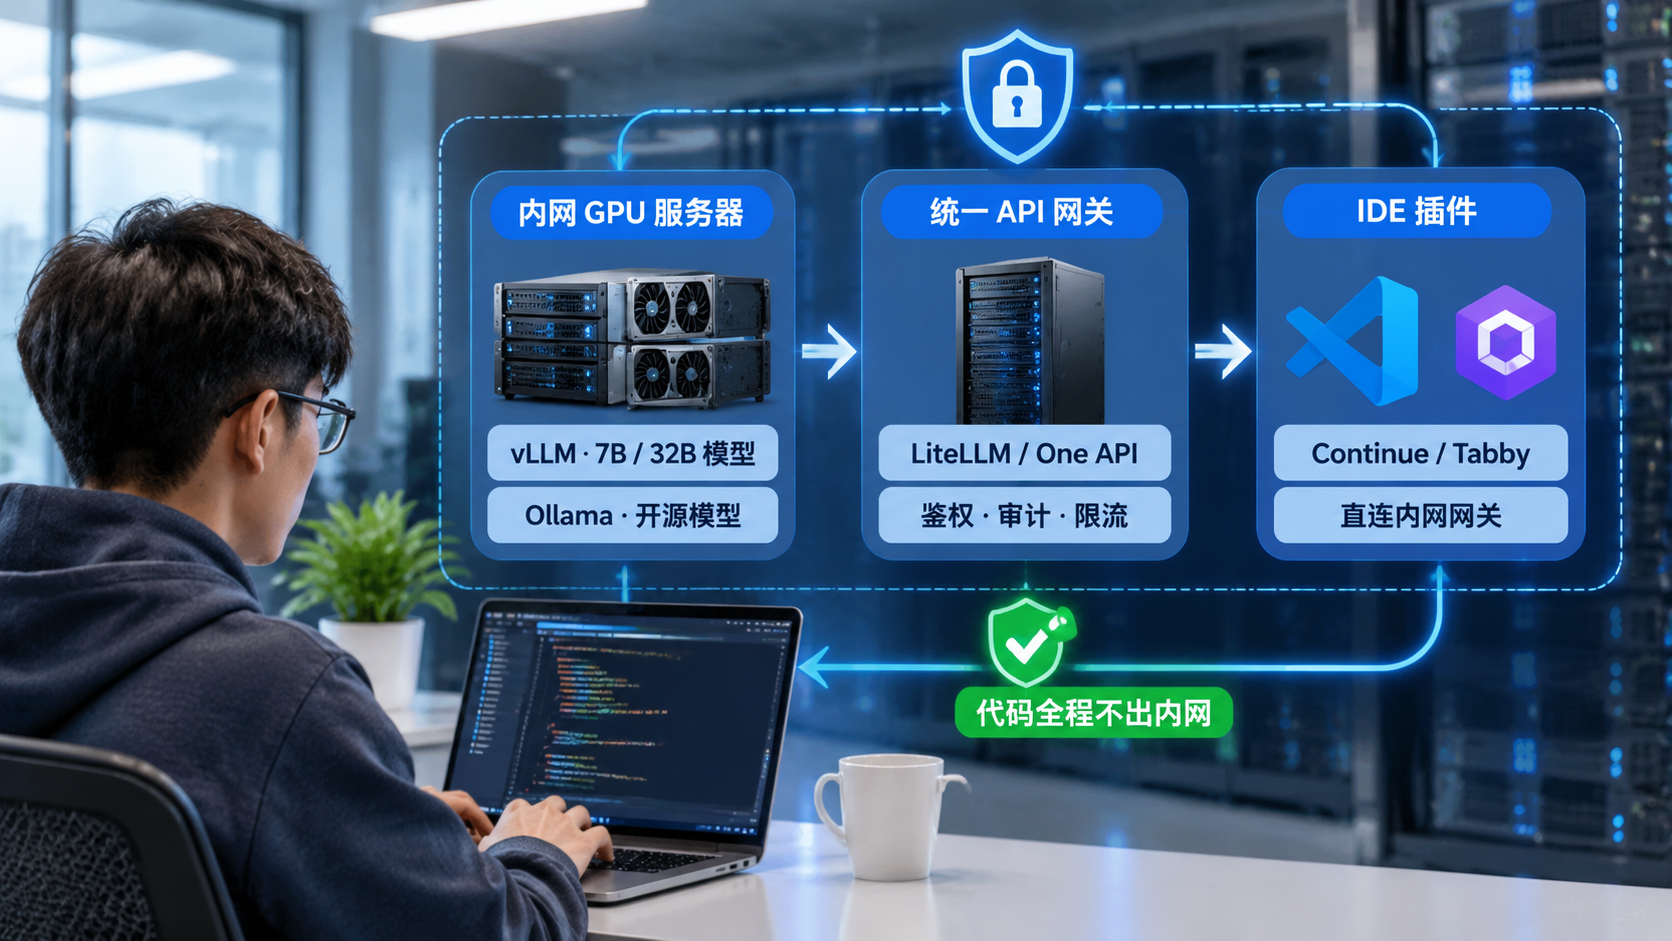
核心方案速览:按团队规模选型
别一上来就盲目堆卡,根据团队人数和现有服务器资源直接对号入座:
- 10人以内小团队 / 验证期(单卡 24G 显存,如 RTX 4090 / A10)
- 架构组合:Ollama + One API + VS Code Continue 插件
- 特点:部署最无脑,一条命令拉起模型。但高并发下 Ollama 吞吐量一般,多人同时触发代码补全时会排队。
- 20~200人研发团队 / 生产级(多卡 48G/80G 显存,如 L40S / A100 / H800)
- 架构组合:vLLM(推理引擎) + LiteLLM(网关分发) + Continue(Chat与补全)
- 特点:生产环境首选。vLLM 的 PagedAttention 和 Continuous Batching 能扛住几十人并发请求;强烈建议采用“大小模型分离”策略——用 7B 模型专门跑毫秒级自动补全,用 32B 模型专门跑侧边栏问答和代码重构。
- 纯 CPU 服务器(无 GPU 兜底)
- 实话直说:直接放弃实时代码补全。CPU 跑补全延迟动辄 5~10 秒,开发者根本没法用。如果非要搞,只能用
llama.cpp跑Qwen2.5-Coder-1.5B量化版做个内网网页问答框,当个离线查语法的工具。
- 实话直说:直接放弃实时代码补全。CPU 跑补全延迟动辄 5~10 秒,开发者根本没法用。如果非要搞,只能用
实操细节深度拆解(生产级落地方案)
内网环境通常是物理断网或严格隔离的,整个搭建过程必须采用“外网准备镜像与权重 -> 离线导入内网 -> 编排上线”的流程。下面以最稳的 vLLM + LiteLLM + Continue 方案拆解每一步。
1. 外网打包与内网模型推理部署(vLLM)
先在有外网的机器上拉取 Docker 镜像和模型权重,千万别在内网服务器折腾编译安装。
# 1. 外网机器拉取并导出 vLLM 镜像
docker pull vllm/vllm-openai:v0.6.4
docker save -o vllm_openai.tar vllm/vllm-openai:v0.6.4

# 2. 外网下载开源最强代码模型之一:Qwen2.5-Coder(国内建议用 ModelScope,速度拉满)
pip install modelscope
modelscope download --model Qwen/Qwen2.5-Coder-7B-Instruct --local_dir ./models/qwen2.5-coder-7b
modelscope download --model Qwen/Qwen2.5-Coder-32B-Instruct-AWQ --local_dir ./models/qwen2.5-coder-32b-awq
把 .tar 镜像包和 ./models 目录拷进内网 GPU 服务器,执行 docker load -i vllm_openai.tar。接着在 GPU 服务器写一个 docker-compose.yml,分别把 7B 补全模型(卡0)和 32B 对话模型(卡1)拉起来:
services:
  # 专门负责代码自动补全(要求快、低延迟)
  vllm-autocomplete:
    image: vllm/vllm-openai:v0.6.4
    container_name: vllm-coder-7b
    runtime: nvidia
    environment:
      - NVIDIA_VISIBLE_DEVICES=0
    volumes:
      - /data/models/qwen2.5-coder-7b:/model
    ports:
      - "8001:8000"
    command: >
      --model /model
      --served-model-name qwen-coder-7b
      --max-model-len 8192
      --gpu-memory-utilization 0.85
      --dtype auto
    restart: always

  # 专门负责复杂问答、单测生成、重构(要求智商高)
  vllm-chat:
    image: vllm/vllm-openai:v0.6.4
    container_name: vllm-coder-32b
    runtime: nvidia
    environment:
      - NVIDIA_VISIBLE_DEVICES=1
    volumes:
      - /data/models/qwen2.5-coder-32b-awq:/model
    ports:
      - "8002:8000"
    command: >
      --model /model
      --served-model-name qwen-coder-32b
      --quantization awq
      --max-model-len 16384
      --gpu-memory-utilization 0.90
restart: always踩坑点提醒:--max-model-len 千万别无脑拉满到 32K 或 128K,显存直接会因为 KV Cache 占满而 OOM。代码补全 8192 上下文绰绰有余,对话场景 16384 完全够用。
2. 接入 API 网关做鉴权与审计(LiteLLM)
永远不要让开发人员的 IDE 直接连 vLLM 的 8001/8002 端口。vLLM 原生鉴权极简,且没有用量统计和按人限流。一旦有人写了个死循环脚本狂刷接口,整台 GPU 服务器直接瘫痪,安全部门找你要审计日志你也拿不出来。
用 LiteLLM Proxy(或者 One API)做一层统一网关。外网提前导出 ghcr.io/berriai/litellm:main-latest 镜像,内网配置 litellm_config.yaml:
model_list:
  - model_name: coder-autocomplete
    litellm_params:
      model: openai/qwen-coder-7b
      api_base: http://10.10.1.50:8001/v1
      api_key: "dummy-key"

  - model_name: coder-chat
    litellm_params:
      model: openai/qwen-coder-32b
      api_base: http://10.10.1.50:8002/v1
      api_key: "dummy-key"

general_settings:
  master_key: "sk-intranet-admin-2025" # 管理员主密钥
  database_url: "postgresql://user:pass@10.10.1.51:5432/litellm" # 存审计日志和虚拟Key
启动网关后,你可以通过管理接口给每个研发人员发放独立的 sk-xxx 虚拟 Key,并设置每分钟请求上限(RPM)和每日 Token 配额,谁调了多少次、什么时候调的一目了然。
3. 开发者 IDE 插件离线安装与下发(Continue)
内网电脑上不了 VS Code / JetBrains 插件市场,需要运维或架构组提前把插件打包放到内网 Git 仓库或共享盘:
- 离线获取插件:在外网用浏览器打开 VS Code Marketplace 搜索
Continue,点击右侧Download Extension下载.vsix安装包(JetBrains 系列同理去 JetBrains Plugins 官网下载.zip包)。 - 内网安装命令:让开发在本地终端直接执行:
code --install-extension Continue.continue-0.9.xxx.vsix - 下发标准化配置:这是最容易翻车的地方。把下面的
config.json放到内网文档里,让开发直接覆盖本地的~/.continue/config.json(Windows 在C:\Users\用户名\.continue\config.json):
{
  "models": [
    {
      "title": "内网代码专家 (32B)",
      "provider": "openai",
      "model": "coder-chat",
      "apiBase": "http://10.10.1.50:4000/v1",
      "apiKey": "这里填分配给个人的虚拟Key",
      "contextLength": 16384
    }
  ],
  "tabAutocompleteModel": {
    "title": "内网极速补全 (7B)",
    "provider": "openai",
    "model": "coder-autocomplete",
    "apiBase": "http://10.10.1.50:4000/v1",
    "apiKey": "这里填分配给个人的虚拟Key",
    "promptTemplates": {
      "autocomplete": "<|fim_prefix|>{{{prefix}}}<|fim_suffix|>{{{suffix}}}<|fim_middle|>"
    }
  },
  "tabAutocompleteOptions": {
    "debounceDelay": 250,
    "maxPromptTokens": 2048,
    "multilineCompletions": "auto"
  },
  "allowAnonymousTelemetry": false
}两个核心避坑点:
allowAnonymousTelemetry: false必须加! 不然插件在纯内网环境会疯狂尝试向海外遥测服务器发心跳包,不仅控制台全是报错,还可能触发公司安全防火墙的告警。- FIM 模板必须显式指定:很多人配完发现 Tab 补全出来的不是代码,而是“好的,这段代码可以这样写……”之类的废话。原因就是没配好 Qwen 专属的
<|fim_prefix|>...填充模板,导致模型把它当成了普通对话。
高频关联问题拓展
1. 开发反馈“连不上内网网关,提示 Connection Refused 或 Timeout”?
排查服务器防火墙之前,90% 的情况是开发自己电脑开了代理软件,或者公司配了全网 HTTP 代理!VS Code 和 JetBrains 会默认继承系统的 HTTP_PROXY 环境变量,把发往 10.10.x.x 内网 IP 的请求也转发到代理服务器上,结果代理根本路由不到内网网关。
- 解决方案:在开发机环境变量或 IDE 设置里强制加上
NO_PROXY白名单:NO_PROXY=localhost,127.0.0.1,10.0.0.0/8,172.16.0.0/12,192.168.0.0/16
2. 公司有很多自研框架和私有 SDK,大模型不认识怎么办?
千万别听信某些供应商说的“拿公司代码库做全量微调(SFT)”。微调不仅烧卡、周期长,代码库天天迭代,模型知识永远是过时的,而且微调极易把模型原本的通用推理能力洗坏。
- 正确玩法(RAG 知识库注入):
- 轻量做法:Continue 插件原生支持
@codebase和@docs。它会自动在本地用向量化把当前打开的项目建索引(内网可以额外在网关配一个bge-m3的 Embedding 模型接口,配置进 Continue 的embeddingsProvider字段),开发提问时输入@codebase 怎么调用内部鉴权中间件,插件会自动检索当前仓库代码并拼进上下文。 - 团队级做法:内网搭一套 Dify 或 RAGFlow,把公司内部 Wiki、接口文档、公共组件库文档导入进去生成知识库,或者直接做成内部 MCP(Model Context Protocol)Server 挂给 IDE 插件调用。
- 轻量做法:Continue 插件原生支持
3. 员工同时用 IDEA(Java)和 VS Code(前端),习惯不统一怎么维护?
JetBrains 全家桶(IntelliJ IDEA、PyCharm、GoLand)同样支持安装 Continue 插件,且底层读取的是同一份 ~/.continue/config.json 配置文件!也就是说,开发只要在电脑上配好一次,VS Code 和 IDEA 两边同时生效,运维不需要针对不同 IDE 写多套接入文档。如果团队有极度追求极致 Tab 补全速度、嫌 Continue 界面太重的后端开发,也可以单独部署一套 Tabby 服务端,专门对接 IDEA 的 Tabby 插件,实测两者完全可以共用后端的 vLLM 推理服务。
4. 安全合规部门要求“绝对不能留存代码,或者必须审查输入输出”?
这套AI代码助手内网私有化接入方案本身就在物理内网闭环,推理引擎 vLLM 默认不落盘任何 Prompt 数据。如果安全部门硬性要求做敏感词拦截(比如防止员工把生产环境数据库密码、私钥误粘贴进对话框)或者审计留存:
- 审计留存:LiteLLM 接好 Postgres 数据库后,开启
success_callback: ["langfuse"](内网私有化部署一个 Langfuse),每次提问的耗时、Token、内容全都能审计。 - 防泄密拦截:在 LiteLLM 的前置 Hook(
pre_call_hook)里写一段 20 行的 Python 正则过滤脚本,一旦检测到 Prompt 里包含BEGIN RSA PRIVATE KEY或特定内网高危密钥特征,直接在网关层拒绝请求并弹窗提示。
结尾总结
落地一套好用的AI代码助手内网私有化接入方案,核心不在于模型参数有多大,而在于推理架构的并发能力、大小模型的合理分工、网关的管控能力以及 IDE 端丝滑的交互体验。与其花大价钱买一套黑盒商业产品被厂商绑定,不如花一两天时间用 vLLM + LiteLLM + Continue 把这套开源技术栈在内网跑通。硬件算力握在自己手里,模型随时可以无缝升级成最新开源版本,审计与安全规则由自己掌控,这才是技术团队最划算、最硬核的提效之道。
相关文章
- 非结构化文档RAG切片策略优化:非结构化文档RAG切片优化
- Dify与FastGPT私有化部署对比测评:Dify与FastGPT实测
- 大模型API接口限流与重试机制设计:大模型API限流与重试实战
- AI代码助手内网私有化接入方案:AI代码助手内网私有化实战
- 多模态模型OCR文档解析落地实战:多模态OCR文档解析实战指南
- GPU算力服务器Docker环境快速配置:GPU算力Docker快速配置
- 大模型幻觉检测与内容安全过滤:搞定大模型幻觉与内容安全过滤
- 企业级AI智能客服低代码搭建流程:企业AI智能客服低代码实操
- DeepSeek接口接入现有业务系统实操:DeepSeek接口接入实操
- Ahrefs API结合大模型挖掘内容Gap:别导表了,让AI自动扒对手词