
多模态模型OCR文档解析落地实战:多模态OCR文档解析实战指南
开篇点题抛结论
多模态模型OCR文档解析想要在生产环境真正落地,最稳妥的方案绝不是全量无脑调闭源大模型API,也不是拿传统OCR硬拼复杂版面,而是“规则前置分流 + PyMuPDF自适应切图 + 本地vLLM部署Qwen2.5-VL-7B + Guided JSON强约束 + 业务数学校验”的混合流水线。
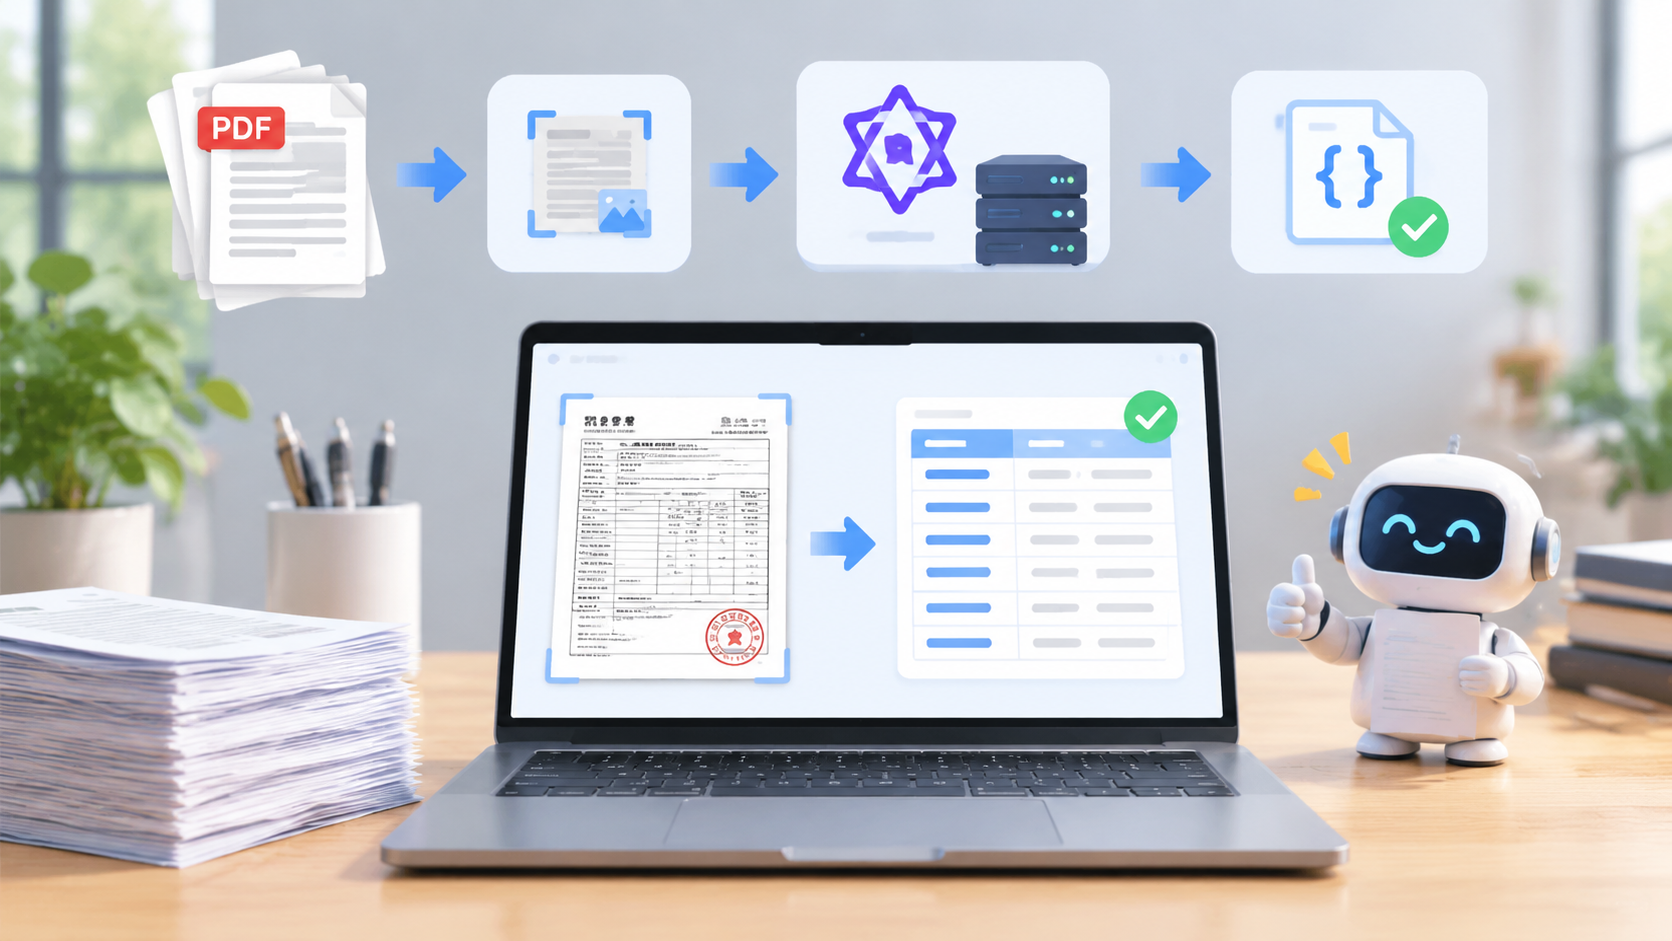
别信那些PPT架构师吹的“端到端大模型一键搞定所有文档”,真放到企业里跑几万份PDF,全调GPT-4o或Claude 3.5 Sonnet,月底看账单老板能直接让你走人;纯靠PaddleOCR或Tesseract去扫带合并单元格、红章遮挡、双栏混排的扫描件,提取出来的Markdown全串行,后面的RAG检索准确率直接崩盘。把轻量化多模态视觉模型(VLM)当成精准的“手术刀”,只切硬骨头,配合工程化的预处理和后置校验,才是花小钱办大事的正解。
核心方案速览
在正式敲代码前,先把整套落地方案的架构和选型逻辑拍死,省得后期返工:
- 流量分流层(省钱核心):
- 纯文本原生PDF(能直接选中复制文字且无复杂跨列):直接用
PyMuPDF或pdfplumber提取,0 GPU开销,毫秒级出结果。 - 常规清晰打印件(无手写、无复杂嵌套表格):走
MinerU或PaddleOCR流水线,单卡吞吐量极高。 - 硬骨头文档(倾斜扫描件、手写批注、红章盖字、无线框/合并单元格财报、双栏学术论文):丢进多模态模型OCR文档解析流水线。
- 纯文本原生PDF(能直接选中复制文字且无复杂跨列):直接用
- 模型选型与算力底座:
- 内网私有化首选:
Qwen2.5-VL-7B-Instruct(或者显存充裕上72B-AWQ)。实测下来,7B版本在单张24G显存卡(RTX 4090 / A10)上配合vLLM就能流畅跑起来,中文文档和复杂表格理解能力吊打一众老牌OCR引擎。 - 云端弹性兜底:预算充足或并发突发,直接路由到
Qwen-VL-Max或Gemini 2.0 Flash(性价比极高,长上下文和图片Token便宜到离谱)。
- 内网私有化首选:
- 输出与校验层:
- 放弃“让模型自由发挥输出JSON”的幻想,必须用 vLLM 的
guided_json配合 Pydantic Schema 锁死输出结构,拿到结果后再跑一遍业务规则(比如发票金额核验)。
- 放弃“让模型自由发挥输出JSON”的幻想,必须用 vLLM 的
实操细节深度拆解
1. PDF转图与动态分辨率控制(显存爆炸重灾区)
很多新手做多模态OCR,第一步就栽在图片分辨率上。DPI设成72或100,表格细线和小号字全糊成马赛克,模型就开始顺着你的Prompt一本正经地胡说八道;把DPI直接拉到600,一张A4纸干到 5000×7000 像素,不仅图像Token直接飙升导致推理慢如蜗牛,多张并发时 vLLM 分分钟给你报 CUDA Out of Memory。
实操经验:PDF转图统一用 200 DPI 起步,同时必须限制图片最大像素数(建议控制在 150万~200万 像素以内,即短边不低于1000px、长边不超过2000px)。遇到超长长图(比如连续几页截成一张的微信长截图或电子对账单),必须先按固定高度带重叠区(Overlap)切分再送模型。
直接套用下面这段基于 PyMuPDF (fitz) 和 Pillow 的工业级预处理脚本:
import fitz  # pip install pymupdf
import io
import base64
from PIL import Image

def pdf_to_base64_images(pdf_path: str, dpi: int = 200, max_pixels: int = 1600 * 1600) -> list[str]:
    """
    将PDF每页转为自适应分辨率的Base64 PNG图片,防止显存溢出或小字模糊
    """
    doc = fitz.open(pdf_path)
    base64_list = []

    for page_num in range(len(doc)):
        page = doc.load_page(page_num)
        # 初始按目标DPI渲染
        pix = page.get_pixmap(dpi=dpi, alpha=False)
        img = Image.open(io.BytesIO(pix.tobytes("png")))

        # 核心避坑:校验总像素,防止超大尺寸图纸撑爆多模态Encoder
        width, height = img.size
        total_pixels = width * height
        if total_pixels > max_pixels:
            scale = (max_pixels / total_pixels) ** 0.5
            new_w, new_h = int(width * scale), int(height * scale)
            img = img.resize((new_w, new_h), Image.Resampling.LANCZOS)

        # 转Base64供API直接调用
        buffered = io.BytesIO()
        img.save(buffered, format="PNG", optimize=True)
        img_b64 = base64.b64encode(buffered.getvalue()).decode("utf-8")
        base64_list.append(f"data:image/png;base64,{img_b64}")

    doc.close()
return base64_list- 适用场景:所有多页PDF、高清扫描件入库前的标准化切片。
- 避坑点:千万别用
pdf2image调poppler,在Linux容器里装依赖能烦死你,而且内存回收极差;PyMuPDF纯C底层,速度快好几倍。另外别存成低质量JPEG,JPEG的有损压缩噪点在黑字边缘会产生蚊式噪声,极其干扰手写体和小数点识别,老老实实用PNG。
2. 私有化推理服务部署(vLLM跑通Qwen2.5-VL)
企业文档大多涉密(合同、财务报表、身份证件),数据根本出不了内网。在单机单卡(以最常见的24G显存4090为例)部署 Qwen2.5-VL-7B-Instruct,直接用 vLLM 拉起兼容 OpenAI 格式的接口。
坑点预警:vLLM 默认的 --max-model-len 会尝试按模型配置的最大长度(如32K甚至128K)预分配 KV Cache,24G显存开机直接OOM。做单页/双页文档解析,8192 的上下文长度完全够用,省下来的显存留给图片Token和并发Batch。
# 确保 vllm >= 0.7.2,transformers 为最新版以支持 Qwen2.5-VL
export CUDA_VISIBLE_DEVICES=0

vllm serve Qwen/Qwen2.5-VL-7B-Instruct \
  --served-model-name qwen25-vl-ocr \
  --host 0.0.0.0 \
  --port 8000 \
  --dtype bfloat16 \
  --max-model-len 8192 \
  --gpu-memory-utilization 0.90 \
  --limit-mm-per-prompt '{"image": 2}' \
--max-num-seqs 16- 参数解读与避坑:
--limit-mm-per-prompt '{"image": 2}':限制单次请求最多传2张图(比如当前页+上一页表头),防止恶意请求或Bug把显存打穿。- 如果你的卡只有 16G 显存(比如T4或4060Ti),不要硬跑 BF16,去 HuggingFace/ModelScope 拉官方的
Qwen2.5-VL-7B-Instruct-AWQ量化版,启动参数加上--quantization awq,实测精度损失在文档解析场景下几乎感知不到。
3. Prompt设计与结构化JSON强约束(彻底治好格式幻觉)
很多人用多模态模型解析文档,Prompt写得跟许愿一样:“请帮我把这张发票里的内容提取出来,返回JSON格式”。结果模型一会儿给你包一层 json ... Markdown代码块,一会儿把没识别出来的字段顺手瞎编个“无”或“0.00”,甚至在长表格最后直接给你来一句“……其余部分以此类推”就开始偷懒。
落地方案:
- System Prompt 钉死边界:明确缺失值填
null、禁止脑补、遇到模糊遮挡标记[UNCLEAR]、复杂跨行合并单元格直接要求输出 HTML<table>标签(划重点!Markdown表格原生不支持rowspan和colspan,遇到财务合并单元格必乱,而HTML表格模型天生就能精准还原结构)。 - 代码层用 Pydantic + vLLM
guided_json:从底层采样概率上强制模型只输出符合 Schema 的合法 JSON,连正则清洗都省了。
直接套用下面的生产级代码:
from openai import OpenAI
from pydantic import BaseModel, Field
from typing import Optional, List

# 1. 用 Pydantic 定义严格的输出结构(以采购入库单/发票为例)
class LineItem(BaseModel):
    item_name: str = Field(..., description="货物或服务名称")
    spec: Optional[str] = Field(None, description="规格型号,无则填null")
    quantity: Optional[float] = Field(None, description="数量")
    unit_price: Optional[float] = Field(None, description="单价")
    amount: Optional[float] = Field(None, description="金额")

class DocumentExtractResult(BaseModel):
    doc_number: Optional[str] = Field(None, description="单据编号或发票号码")
    doc_date: Optional[str] = Field(None, description="开具日期,统一格式化为YYYY-MM-DD")
    vendor_name: Optional[str] = Field(None, description="销售方/供应商全称")
    total_amount: Optional[float] = Field(None, description="价税合计或总金额")
    items: List[LineItem] = Field(default_factory=list, description="明细行列表")
    raw_table_html: Optional[str] = Field(None, description="若存在复杂合并单元格表格,额外输出完整HTML table源码")

# 2. 工业级可复用 Prompt
SYSTEM_PROMPT = """你是一个高精度的企业文档OCR与结构化解析引擎。
请严格遵守以下解析铁律:
1. 忠实于图像原始像素内容,严禁推理脑补图像中不存在或被完全遮挡的文字。
2. 遇到印章遮挡、污损导致无法辨认的字符,对应位置输出 "[UNCLEAR]",数字字段无法确认则输出 null。
3. 遇到包含合并单元格(跨行/跨列)的复杂表格,在 raw_table_html 字段中使用标准 HTML <table>、<tr>、<td rowspan="" colspan=""> 标签完整还原,严禁省略行(禁止出现“略”或“...”)。
4. 金额与数量字段仅提取纯数字,剔除货币符号(¥、$)和千分位逗号。"""

# 3. 调用本地 vLLM 服务
client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")

def parse_document_page(image_b64: str) -> DocumentExtractResult:
    json_schema = DocumentExtractResult.model_json_schema()

    response = client.chat.completions.create(
        model="qwen25-vl-ocr",
        temperature=0.01,  # OCR任务必须把温度压到最低,抑制发散幻觉
        max_tokens=4096,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {
                "role": "user",
                "content": [
                    {"type": "image_url", "image_url": {"url": image_b64}},
                    {"type": "text", "text": "请严格按照Schema定义提取该文档页面中的所有关键字段与明细表格。"}
                ]
            }
        ],
        # 核心技巧:利用 vLLM 的 guided_json 锁死输出结构,100% 返回合法JSON
        extra_body={"guided_json": json_schema}
    )

    raw_json = response.choices[0].message.content
return DocumentExtractResult.model_validate_json(raw_json)- 避坑点:如果你调用的是外部闭源API(如OpenAI官方或通义千问商业版),把
extra_body={"guided_json": ...}换成官方标准的response_format={"type": "json_schema", "json_schema": ...}或client.beta.chat.completions.parse(...)。切记把temperature设为0.01或0.0,OCR不是写小说,不需要任何创造力。
4. 业务规则二次校验闭环(守住最后一道防线)
多模态模型本质还是基于概率预测下一个Token,遇到模糊的“6”和“8”、或者小数点丢了,它自己不会做算术检查。但凡涉及金额、数量、身份证号、税号的场景,绝不能解析完直接入库,必须用代码做数学逻辑校验,校验不过的直接标记 need_review=True,路由给更强的72B大模型复核或者扔进人工审核队列。
def validate_financial_doc(result: DocumentExtractResult) -> dict:
    """
    财务单据数学勾稽关系校验,拦截模型视觉识别错漏
    """
    errors = []
    calculated_total = 0.0

    for idx, item in enumerate(result.items):
        if item.quantity is not None and item.unit_price is not None and item.amount is not None:
            expected_amt = round(item.quantity * item.unit_price, 2)
            # 允许 0.02 的四舍五入浮点误差
            if abs(expected_amt - item.amount) > 0.02:
                errors.append(
                    f"第{idx+1}行明细算术不平: {item.quantity} * {item.unit_price} != {item.amount}"
                )
        if item.amount is not None:
            calculated_total += item.amount

    if result.total_amount is not None and result.items:
        if abs(round(calculated_total, 2) - result.total_amount) > 0.05:
            errors.append(
                f"明细累加和({calculated_total:.2f})与总金额({result.total_amount})不匹配"
            )

    return {
        "is_valid": len(errors) == 0,
        "need_human_review": len(errors) > 0,
        "errors": errors,
        "data": result.model_dump()
    }
高频关联问题拓展
1. 遇到红色公章/骑缝章盖住关键黑字,模型还是瞎猜怎么办?
多模态模型虽然抗干扰比传统OCR强,但遇到大红印章把签字或金额糊得严严实实时,依然容易出现“视觉幻觉”。
硬核实操解法:送进模型之前,利用物理光学原理用 OpenCV 提取图像的红色通道(Red Channel)!在白纸黑字红印章的图片里,红章在红色通道下的亮度值接近白色(255),而黑色墨迹依然是接近0的黑字。一行代码就能把90%的红章“一键隐身”,完全不伤黑字笔画,比复杂的HSV抠图抹白效果好得多:
import cv2
import numpy as np

def remove_red_stamp(image_bytes: bytes) -> bytes:
    # 解码图像
    nparr = np.frombuffer(image_bytes, np.uint8)
    img = cv2.imdecode(nparr, cv2.IMREAD_COLOR)
    # OpenCV 默认通道顺序是 B, G, R,直接取索引2即为红色通道
    _, _, red_channel = cv2.split(img)
    # 轻微对比度拉伸(可选,增强黑字锐度)
    _, thresh = cv2.threshold(red_channel, 0, 255, cv2.THRESH_BINARY + cv2.THRESH_OTSU)
    # 注意:如果原图同时有重要蓝色手写字,建议直接返回 red_channel 灰度图而非二值化图,保留更多边缘细节给多模态模型
    _, encoded_img = cv2.imencode('.png', red_channel)
return encoded_img.tobytes()适用场景:合同落款、财务报销单、公文批示等重度盖章文档的预处理。如果文档里有红字标题需要保留颜色语义,则同时传“原图+去红章图”给支持多图输入的VLM做交叉印证。
2. 几十页的跨页长表格,第二页没有表头全乱套怎么解?
单页独立解析时,PDF第2页、第3页往往只有密密麻麻的数据行,没有表头,模型根本不知道第一列是“期初余额”还是“期末余额”,直接张冠李戴。
解决思路(滑动上下文表头注入):
- 不要单页孤立并发,按文档维度串行或组批处理。
- 当第 $N$ 页识别出表格但缺少表头(或者第 $N-1$ 页底部是未封闭的表格行)时,把第 $N-1$ 页解析出的表头字段结构(甚至直接把第 $N-1$ 页图片作为参考图1,第 $N$ 页作为目标图2)一起塞进 Prompt:
“补充指令:图1为上一页文档,图2为当前待解析页。若图2顶部为续接表格且无独立表头,请严格沿用图1表格的列结构继续提取图2中的所有数据行。”
- 最后通过代码把连续页的
items列表按顺序extend合并,完美解决跨页断表难题。
3. 几万份历史文档积压,多模态模型吞吐量上不去怎么办?
别拿多模态模型当普通CPU脚本用,哪怕是7B模型,单卡A10/4090处理一张高清图也要 1.5~3秒,全量文档硬塞进去得跑好几天。
提效三板斧:
- 前置版面检测路由(最有效):先用极轻量的目标检测模型(如
DocLayout-YOLO,单张图耗时不到 20 毫秒)扫一遍页面。如果页面里只有纯文本段落、没有表格/公式/印章/手写体,直接切回PaddleOCR或PyMuPDF秒出;只把包含table、figure或低置信度区域的图片送给多模态模型,算力消耗直接砍掉70%以上。 - 局部裁剪(Crop)代替整页输入:如果整张A4纸你只需要提取右下角的“开票人信息”或中间那块“汇总表”,用版面检测框出目标区域 Crop 出来再送模型,图片像素少了4倍,视觉编码耗时和显存占用断崖式下降,准确率反而更高。
- 异步并发打满Batch:业务端千万别用
for循环同步requests.post请求 vLLM,一定要用asyncio+AsyncOpenAI配合信号量(asyncio.Semaphore(16))并发打过去,让 vLLM 的 Continuous Batching(连续批处理)真正转起来,吞吐量能直接翻3~5倍。
结尾总结
多模态模型OCR文档解析不是玄学,也不是买了张显卡跑个Demo就算落地了。真正在企业级场景里扛住高并发、复杂版面和奇葩扫描件,拼的从来不是谁的Prompt写得花哨,而是工程化细节的死磕:
- 算好成本账:用
DocLayout-YOLO和原生文本判断做路由分流,把多模态算力省在刀刃上。 - 管住图片分辨率:
200 DPI配合像素上限保护,既保住小数点不糊,又不让显存炸掉。 - 锁死输出与校验:
vLLM guided_json消灭格式解析报错,业务代码做算术勾稽核验兜底幻觉,红章遮挡直接抽红色通道预处理。
把这套混合流水线按模块搭好,哪怕只有一张24G显存的卡,也足够稳稳撑起绝大多数中小企业的非结构化文档数字化和RAG知识库清洗业务。先跑通最小闭环,再针对错题集(Bad Case)逐个加预处理规则,这才是AI落地的正确姿势。
相关文章
- 非结构化文档RAG切片策略优化:非结构化文档RAG切片优化
- Dify与FastGPT私有化部署对比测评:Dify与FastGPT实测
- 大模型API接口限流与重试机制设计:大模型API限流与重试实战
- AI代码助手内网私有化接入方案:AI代码助手内网私有化实战
- 多模态模型OCR文档解析落地实战:多模态OCR文档解析实战指南
- GPU算力服务器Docker环境快速配置:GPU算力Docker快速配置
- 大模型幻觉检测与内容安全过滤:搞定大模型幻觉与内容安全过滤
- 企业级AI智能客服低代码搭建流程:企业AI智能客服低代码实操
- DeepSeek接口接入现有业务系统实操:DeepSeek接口接入实操
- Ahrefs API结合大模型挖掘内容Gap:别导表了,让AI自动扒对手词