
大模型API接口限流与重试机制设计:大模型API限流与重试实战
做好大模型API接口限流与重试机制设计,核心方案就一句话:调用前在本地或网关用双维度令牌桶卡死 RPM(每分钟请求数)与 TPM(每分钟Token数),调用中设置短连接超时并精准识别异常状态码,重试时必须采用“优先读取 Retry-After 响应头 + 指数退避加随机抖动”,且严禁无脑重试 4xx 客户端错误。
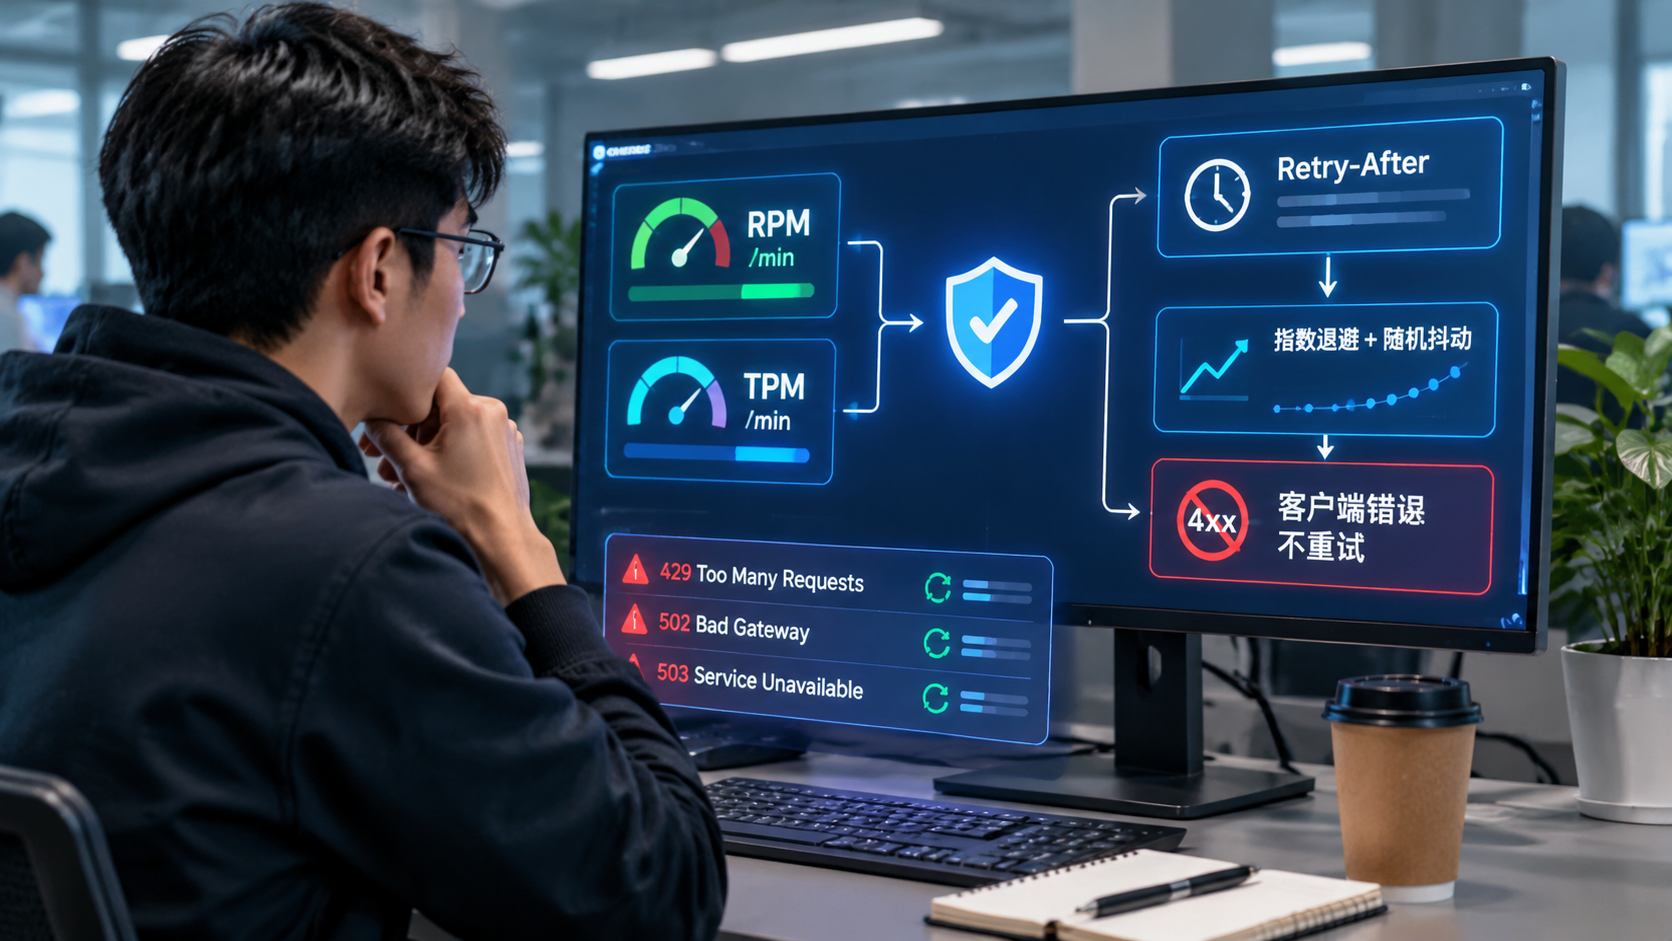
平时看不少团队写大模型接入代码,直接拿官方给的几行 Demo 改吧改吧就敢往生产环境推。跑单条测试岁月静好,一上批量跑数或者用户并发稍微上来点,日志里瞬间刷满 429 Too Many Requests 和 502 Bad Gateway;更离谱的是有人写个 for 循环加固定 sleep(1) 死磕重试,结果撞上平台并发锁直接把 Key 封了,或者把服务端工作线程全部堵死。
下面直接拆解这套经过生产环境验证的限流与重试落地架构,代码和配置拿去改改参数就能直接用。
核心方案速览
一套扛得住高并发的大模型调用链路,不能只靠单一的 try-except,必须由三层防线组成:
- 主动限流层(防撞墙):不要等平台报错了再退让。必须在请求发出前,根据账号的 RPM 和 TPM 额度做平滑削峰,避免瞬间突发请求把额度打穿。
- 精准异常与重试层(保成功):区分可重试异常(429、500、502、503、连接超时)和不可重试异常(400参数错误、401鉴权失败、403违规拦截)。重试间隔必须加入随机抖动(Jitter),防止所有失败请求在同一秒同时复活引发“惊群效应”。
- 超时控制与多渠道降级层(兜底线):改掉 SDK 默认的 10 分钟超长超时,配合流式首包判定和多 Key/多渠道冷却队列,单点挂掉立刻切走,保证业务不雪崩。
实操细节深度拆解
1. 别只限并发数,RPM 和 TPM 必须双维度限流
新手最容易踩的坑,就是写个 asyncio.Semaphore(10) 以为万事大吉。传统接口限并发就行,但大模型接口按 RPM(请求次数) 和 TPM(Token 消耗量) 两个维度算账,哪个先触顶都会报 429。比如你处理长文本摘要,一次请求 15k Token,并发只有 5,1 秒钟照样把 60k TPM 的账号额度打爆。
适用场景:单机 Python 异步脚本、批处理任务、FastAPI 后端服务。
下面是一套可直接套用的异步双维度令牌桶代码,发请求前先估算输入 Token(粗略按 字符数 * 1.5 或用 tiktoken 精准计算),拿不到令牌就异步挂起等待:
import asyncio
import time

class DualTokenBucketLimiter:
    def __init__(self, rpm_limit: int, tpm_limit: int):
        # 桶容量设为每分钟限额的 1/6(即允许最多 10 秒级别的突发),防止瞬间打满触发平台瞬时限流
        self.rpm_capacity = max(1, rpm_limit / 6.0)
        self.tpm_capacity = max(1000, tpm_limit / 6.0)

        self.rpm_rate = rpm_limit / 60.0  # 每秒补充的请求令牌数
        self.tpm_rate = tpm_limit / 60.0  # 每秒补充的Token令牌数

        self.rpm_tokens = self.rpm_capacity
        self.tpm_tokens = self.tpm_capacity
        self.last_update = time.monotonic()
        self._lock = asyncio.Lock()

    async def acquire(self, estimated_tokens: int):
        # 避坑点:如果单次请求Token大于桶最大容量,直接放行或截断估算值,否则会死循环卡死
        consume_tpm = min(estimated_tokens, self.tpm_capacity)

        while True:
            async with self._lock:
                now = time.monotonic()
                elapsed = now - self.last_update
                self.last_update = now

                # 补充令牌
                self.rpm_tokens = min(self.rpm_capacity, self.rpm_tokens + elapsed * self.rpm_rate)
                self.tpm_tokens = min(self.tpm_capacity, self.tpm_tokens + elapsed * self.tpm_rate)

                # 判断双维度是否同时满足
                if self.rpm_tokens >= 1.0 and self.tpm_tokens >= consume_tpm:
                    self.rpm_tokens -= 1.0
                    self.tpm_tokens -= consume_tpm
                    return

                # 计算还需等待的最短时间
                rpm_wait = (1.0 - self.rpm_tokens) / self.rpm_rate if self.rpm_tokens < 1.0 else 0.0
                tpm_wait = (consume_tpm - self.tpm_tokens) / self.tpm_rate if self.tpm_tokens < consume_tpm else 0.0
                wait_time = max(rpm_wait, tpm_wait)

            # 在锁外休眠,避免阻塞其他协程检查时间
await asyncio.sleep(wait_time)避坑提示:很多云厂商或模型官网写着 60 RPM,并不代表你在第 1 秒内把 60 个请求全发出去没事,底层网关往往还卡着 10 RPS 甚至更细颗粒度的滑动窗口。所以上面的 capacity 刻意压缩到了每分钟限额的 1/6,强行把流量抹平,实测能砍掉 80% 以上的莫名 429 报错。
2. 重试机制实战:优先看 Retry-After,再上指数退避+抖动
遇到报错怎么重试?千万别自己写 while retry < 3: try...except...time.sleep(2)。用 Python 成熟的 tenacity 库,再配合针对大模型场景定制的等待策略。
核心逻辑:
- 很多模型网关在返回
429时,会在 HTTP 响应头里带上Retry-After(比如告诉你要等 12 秒)。你不看这个头,第 2 秒、第 4 秒跑去重试,纯属浪费重试次数。 - 如果响应头里没有
Retry-After,或者遇到502/503/网络抖动,再走指数退避 + 随机抖动(比如2^n + random(0, 1.5)秒)。 - 遇到
400 Bad Request(上下文超长、JSON 格式错)、401(Key 失效)、403(内容风控拦截),绝对不要重试,直接抛出异常告警。
适用场景:基于官方 openai SDK(1.x 及以上版本)的所有生产级调用。
import random
import httpx
from openai import (
    AsyncOpenAI,
    RateLimitError,
    APIConnectionError,
    APITimeoutError,
    InternalServerError,
)
from tenacity import (
    retry,
    stop_after_attempt,
    retry_if_exception_type,
    RetryCallState,
)

# 1. 强制设置合理的超时!官方默认超时高达10分钟,生产环境绝不能用默认值
client = AsyncOpenAI(
    api_key="your-api-key",
    max_retries=0,  # 关闭SDK自带的盲目重试,全部由我们自己接管控制
    timeout=httpx.Timeout(60.0, connect=5.0, read=45.0, write=10.0),
)

# 2. 自定义等待策略:优先读取上游返回的 Retry-After 头部
def smart_wait_strategy(retry_state: RetryCallState) -> float:
    exc = retry_state.outcome.exception()
    # 尝试从 OpenAI SDK 异常中提取原始 response header
    response = getattr(exc, "response", None)
    if response is not None:
        retry_after = response.headers.get("retry-after") or response.headers.get("retry-after-ms")
        if retry_after:
            try:
                # 兼容秒和毫秒(如果是 retry-after-ms 需除以1000)
                val = float(retry_after)
                if "retry-after-ms" in response.headers and not response.headers.get("retry-after"):
                    val = val / 1000.0
                # 在官方建议时间基础上,再加 0.2~1.2 秒随机抖动,防止扎堆重连
                return min(val, 60.0) + random.uniform(0.2, 1.2)
            except ValueError:
                pass

    # 降级策略:指数退避 (2, 4, 8...) + 随机抖动,最大等待不超过 30 秒
    attempt = retry_state.attempt_number
    base_delay = min(30.0, 2 ** attempt)
    return base_delay + random.uniform(0.1, 1.5)

# 3. 仅针对瞬时故障和限流做重试
RETRYABLE_EXCEPTIONS = (
    RateLimitError,       # 429
    APIConnectionError,   # 网络断开、DNS解析失败
    APITimeoutError,      # 建连或读取超时
    InternalServerError,  # 500, 502, 503, 504
)

@retry(
    stop=stop_after_attempt(4),  # 最多试4次(首次+3次重试)
    wait=smart_wait_strategy,
    retry=retry_if_exception_type(RETRYABLE_EXCEPTIONS),
    reraise=True,  # 耗尽次数后把真实异常抛给上层业务处理
)
async def call_llm_safely(messages: list, limiter: DualTokenBucketLimiter):
    # 粗略估算输入Token,中文场景下 1个汉字约1.5~2 token,英文按字符/4
    text_len = sum(len(m.get("content", "")) for m in messages)
    await limiter.acquire(estimated_tokens=int(text_len * 1.5) + 500)

    return await client.chat.completions.create(
        model="gpt-4o-mini",
        messages=messages,
)避坑提示:切记把 SDK 初始化时的 max_retries=0 关掉!OpenAI、Anthropic 的官方 SDK 默认自带 max_retries=2。如果你外层包了 tenacity 重试 4 次,内层 SDK 自己又偷偷重试 2 次,实际底层会请求 4 * 3 = 12 次!一旦接口慢下来,整个调用链路会卡死几分钟才报错。
3. 流式输出(SSE)中途断连怎么处理?
做对话机器人或前端实时打字机效果时,最头疼的就是流式传输(stream=True)。如果模型吐了 50 个字,突然连接重置(ChunkedEncodingError 或 RemoteProtocolError)怎么办?
直接整段重试会导致前端界面吐出一半文字后突然删掉重来,用户体验极差。正确的实操准则只有一条:以“是否收到首个有效 Token”作为分界线。
- 首包之前报错:用户端还没看到任何字,可以安全执行整段重试,用户无感知。
- 吐出内容之后报错:绝对不要隐式重发整个请求,直接中断当前流,向前端发送一个特定错误事件(如
{"error": "stream_broken", "can_continue": true}),由前端保留已生成的半截内容,并提供“继续生成”按钮,把已生成文本拼进assistant历史消息里续写。
async def stream_llm_with_safe_retry(messages: list, max_attempts: int = 3):
    for attempt in range(1, max_attempts + 1):
        first_chunk_received = False
        try:
            stream = await client.chat.completions.create(
                model="gpt-4o-mini",
                messages=messages,
                stream=True,
            )
            async for chunk in stream:
                content = chunk.choices[0].delta.content if chunk.choices else None
                if content:
                    first_chunk_received = True
                    yield content
            return  # 正常结束直接退出循环

        except RETRYABLE_EXCEPTIONS as e:
            # 一旦已经吐出过内容,严禁透明重试,直接抛出交由上层提示“中断”
            if first_chunk_received or attempt == max_attempts:
                raise e
            # 首包未收到,可以安全退避重试
            await asyncio.sleep((2 ** attempt) + random.uniform(0.1, 1.0))
4. 多进程/多容器部署下的分布式限流(Redis Lua)
单机内存里的令牌桶,一旦你用 Gunicorn 起了 8 个 Worker,或者在 K8s 里扩了 5 个 Pod,限流立刻失效——每个实例都以为自己没超标,加起来直接把上游打爆。
适用场景:多副本微服务架构、多台服务器同时消费同一个 API Key 池。
别在 Python 里自己拿 redis.get() 和 redis.set() 分两步写,并发高了必出竞态条件。直接上 Redis Lua 脚本,利用 Redis 单线程执行 Lua 的原子性搞定分布式平滑窗口限流:
-- 分布式滑动窗口限流脚本 (按分钟级限流 RPM,TPM 同理只需把incr改为传入Token数)
-- KEYS[1]: 限流Key, 如 "llm:ratelimit:rpm:key_id_1"
-- ARGV[1]: 当前毫秒时间戳
-- ARGV[2]: 窗口大小(毫秒), 如 60000
-- ARGV[3]: 最大允许次数(RPM)
-- ARGV[4]: 本次消耗数量(RPM传1, TPM传估算Token数)
-- ARGV[5]: 请求唯一ID(防ZSET成员冲突)

local key = KEYS[1]
local now = tonumber(ARGV[1])
local window = tonumber(ARGV[2])
local limit = tonumber(ARGV[3])
local cost = tonumber(ARGV[4])
local req_id = ARGV[5]

-- 清理过期窗口数据
redis.call('ZREMRANGEBYSCORE', key, 0, now - window)

-- 统计当前窗口内已消耗总量
local members = redis.call('ZRANGE', key, 0, -1)
local current_usage = 0
for _, member in ipairs(members) do
    -- member格式约定为 "req_id:cost"
    local sep = string.find(member, ":")
    if sep then
        current_usage = current_usage + tonumber(string.sub(member, sep + 1))
    end
end

if current_usage + cost > limit then
    return 0  -- 触发限流,拒绝放行
end

-- 放行并记录本次消耗,设置Key过期时间防止冷Key堆积
redis.call('ZADD', key, now, req_id .. ":" .. cost)
redis.call('PEXPIRE', key, window + 5000)
return 1
如果觉得自己维护 Lua 脚本太重,嫌麻烦的团队可以直接在架构前面架一层开源的 AI 网关(比如 LiteLLM Proxy 或 OneAPI),把多 Key 轮询、RPM/TPM 限流和自动 Fallback 统统托管给网关层,业务代码只管调内网网关地址。
高频关联问题拓展
1. 为什么后台明明显示额度没用完,接口还是频繁报 429?
大概率撞上了三种隐形墙:
- 瞬时并发脉冲:前面提过,很多厂商的 RPM 是按分钟算账,但底层网关按秒甚至 100 毫秒切片做防护。你用
asyncio.gather一瞬间甩出 50 个协程,即便总和没超 1 分钟限额,照样被秒杀。解法:批处理任务不要全量gather,改用asyncio.Semaphore配合上面的令牌桶,或者用队列消费者模式匀速吐出。 - 上游算力枯竭(Capacity Exceeded):尤其是高峰期调用热门模型(如 Claude 3.5 Sonnet、DeepSeek 满血版、GPT-4o 刚发布时),这并不是你自己的额度超了,而是平台整个机房算力不够用了。此时 HTTP 状态码同样返回 429 或 529。解法:单靠原地重试往往要等好几分钟,必须在业务层配置异构降级模型(比如主模型连续失败 2 次,自动降级切换到同生态的轻量模型或另一家云厂商的托管节点)。
2. 多 API Key 轮询(Key Pool)怎么设计才不会一起挂?
很多人搞多 Key 池喜欢用简单的 random.choice(keys) 或者无脑 itertools.cycle 轮询。这有个致命缺陷:一旦 Key A 触发了限流进入惩罚期,轮询指针还会一次次轮到它,白白浪费重试次数,甚至把报错传染给后续请求。
实操做法:给每个 Key 维护一个 cooldown_until(冷却截止时间戳)。
- 平时按“当前并发最少”或“距离上次使用最久”挑选可用 Key(过滤掉
now < cooldown_until的 Key)。 - 一旦 Key A 返回 429,立刻解析其
Retry-After(没有就默认惩罚 30 秒),更新Key_A.cooldown_until = now + 30。 - 本次重试必须换一个健康的 Key B 去执行,而不是拿着刚挨揍的 Key A 原地干等。
- 如果遇到
401 Unauthorized或insufficient_quota(彻底欠费),直接将该 Key 从内存/Redis 池子里踢出并触发飞书/钉钉告警,别再让它出来恶心业务请求。
3. 超时时间(Timeout)设多少最合适?
千万别一刀切设个 timeout=10。大模型推理有个特点:首字延迟(TTFT)长,生成耗时与输出长度成正比。你让模型写一篇 3000 字的分析报告,非流式请求等 40 秒太正常了,设 10 秒等于把所有长任务全杀掉。
推荐的拆分配置标准(对应前面 httpx.Timeout):
connect(建连超时)设为 3~5 秒:连 TCP 握手都超过 5 秒,说明网络路由早就通不了或者节点炸了,赶紧断开重试,别死等。read(读取超时)区分场景:- 非流式请求:设为 60~90 秒(复杂推理模型如 DeepSeek-R1、OpenAI o1/o3 建议放宽到 120~180 秒)。
- 流式请求:
httpx的read超时指的是“两个连续数据包之间的最大等待间隔”,而不是总耗时!流式模式下把read设为 15~25 秒 极香——只要模型在正常吐字,跑 5 分钟都不会超时;一旦模型卡死超过 20 秒不吐字,立刻触发超时熔断。
结尾总结
把大模型API接口限流与重试机制设计做到位,核心不是去背什么高大上的算法名词,而是把每一层边界条件抠死。上线前对照着过一遍下面这 4 条检查清单,基本能躲开线上 95% 的事故:
- SDK 默认配置必须改:显式关闭 SDK 自带盲目重试(
max_retries=0),按流式/非流式拆分设定connect与read超时。 - 限流必须双维度对齐:本地或 Redis 网关同时卡住 RPM 与 TPM,并把突发容量压平,别让
asyncio.gather一股脑把请求全砸出去。 - 重试必须带脑子:只重放 429/5xx/网络超时的请求,4xx 参数和鉴权错直接报错;等待时间优先吃透上游
Retry-After,保底走指数退避加随机抖动。 - 流式与多 Key 要做好隔离:流式吐出首字后不再隐式重发;多 Key 池引入冷却时间戳机制,遇 429 踢入冷宫并切备用 Key 或备用模型通道兜底。
相关文章
- 非结构化文档RAG切片策略优化:非结构化文档RAG切片优化
- Dify与FastGPT私有化部署对比测评:Dify与FastGPT实测
- 大模型API接口限流与重试机制设计:大模型API限流与重试实战
- AI代码助手内网私有化接入方案:AI代码助手内网私有化实战
- 多模态模型OCR文档解析落地实战:多模态OCR文档解析实战指南
- GPU算力服务器Docker环境快速配置:GPU算力Docker快速配置
- 大模型幻觉检测与内容安全过滤:搞定大模型幻觉与内容安全过滤
- 企业级AI智能客服低代码搭建流程:企业AI智能客服低代码实操
- DeepSeek接口接入现有业务系统实操:DeepSeek接口接入实操
- Ahrefs API结合大模型挖掘内容Gap:别导表了,让AI自动扒对手词