
HTML5语义化标签对搜索引擎理解的提升:页面标签怎么写,搜索引擎才爱抓
做网站技术运维和SEO这么多年,我常遇到一种让人哭笑不得的现象:很多站点花了大把银子买外链、死磕关键词密度,甚至上了各种大模型做内容生成,但打开控制台一看,整个页面满屏全是嵌套了七八层的 <div>。很多人不知道,HTML5语义化标签对搜索引擎理解的提升,往往比你死磕那些所谓的黑帽技巧要管用得多,而且见效更扎实。
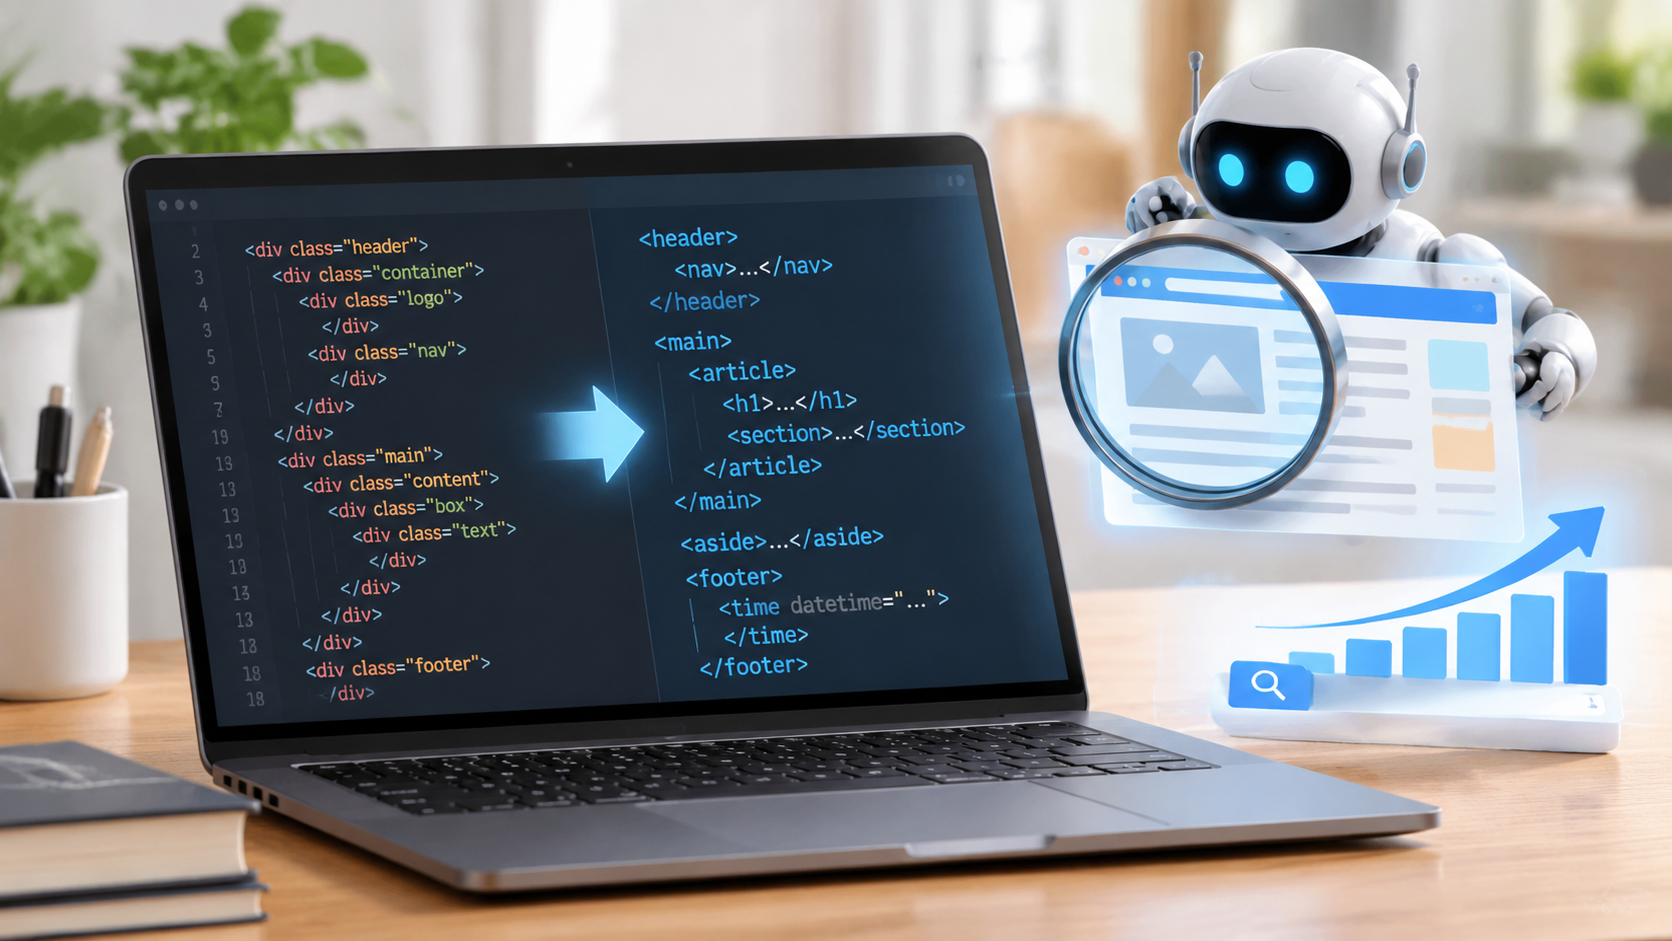
说句大实话,搜索引擎的爬虫不是真实用户,它没有视网膜,不会因为你把一个 <div> 加了粗、设成24号字、涂上红色,就认定它是这篇内容的核心大纲。爬虫眼里的页面,纯粹就是由标签节点构成的 DOM 树。你的标签用得越准,爬虫解析时消耗的资源就越少,它对你页面意图的理解也就越精准。
爬虫是怎么“看”页面的?
要弄明白语义化标签的价值,得先搞清楚搜索引擎抓取解析的底层逻辑。
以前爬虫抓到一个页面,会通过启发式算法(比如提取文本密度、分析 CSS 样式权重)来推测哪里是正文、哪里是侧边栏、哪里是导航。这个过程不仅费算力,而且容错率很低。如果你的页面满屏都是 div.class="box1" 这种写法,爬虫为了提取正文,必须把整个 DOM 树走一遍,甚至还要加载 CSS 文件计算元素的几何位置,这就极大地消耗了抓取配额(Crawl Budget)。
而 HTML5 语义化标签,本质上是一份直接递给爬虫的“页面解剖图”。当爬虫看到特定的标签时,它会走内置的解析捷径,快速完成结构切片。
几个核心标签的正确打开方式
别把语义化想得太复杂,在日常写代码或者排查主题模板时,抓牢下面这几个关键标签,结构就不会跑偏:
1. <main>:别给爬虫捉迷藏
一个页面原则上只能有一个 <main> 标签。它的作用非常纯粹:明确告诉爬虫,页面最核心、不随全站模板变动的正文内容就在这里。
当你把正文用 <main> 包裹起来后,爬虫可以直接跳过顶部的轮播图、通栏通告,把 NLP(自然语言处理)的算力直接聚焦在这块区域。这对于计算页面的主题关联度(Topical Relevance)是决定性的。
2. <article> 与 <section>:理清主次和逻辑
这是被误用最多的两个标签。很多前端图省事,直接拿它们当替代版的 <div> 来用,这是大忌。
<article>代表的是一段独立成篇、拿出去放在别的网站也能读懂的内容。比如博客的正文、电商的产品详情卡片、论坛的单个回复。爬虫看到<article>,会把里面的内容当成一个独立的知识单元(Entity)来索引。<section>则是把一个长主题按逻辑切块。比如写一篇长技术文档,第一部分是背景介绍,第二部分是安装配置,第三部分是常见报错。每一部分配一个<section>,里面必须包含对应的<h2>到<h4>标题。这样做的好处是,搜索引擎在生成 SERP(搜索结果页)的片段摘要(Featured Snippets)或者网页快照折叠时,能直接切中对应的小标题段落。
3. <nav> 与 <aside>:给爬虫打“降权预防针”
做 SEO 不仅要告诉爬虫什么重要,更要告诉它什么可以忽略。
<nav>:用来放全局导航、分类面包屑。爬虫通过这里的链接来发现新 URL,但绝不会把里面的文字权重计入当前页面的主题词里。<aside>:边栏、相关推荐、广告位、作者名片,统统塞进<aside>。很多站点核心词密度被拉低,就是因为右侧边栏里杂七杂八的内容太多,稀释了正文。用<aside>标出来后,搜索引擎会自动把这部分权重视为次级补充,保护了核心正文的纯粹性。
4. <time> 标签:抢占时效性排名的暗器
在技术类、资讯类网站中,内容的发布与更新时间直接影响搜索引擎的时效性评分(Freshness Score)。不要随便用一个 <span>2024-03-01</span> 糊弄过去,规范的写法是:
<time datetime="2024-03-01T08:30:00+08:00">2024年3月1日</time>带上规范的 datetime 属性,爬虫连格式化日期的算法都不用跑,直接读取机器时间戳,对被收录和即时排名极其友好。
AI 搜索时代,语义化的新红利
很多人觉得现在都 2024 年了,大模型和神经搜索引擎已经这么强,标签还重要吗?恰恰相反,在当前由 Perplexity、Bing Copilot 以及 Google SGE 主导的“生成式引擎时代”,语义化标签的价值被进一步放大了。
AI 搜索引擎在为用户提供答案时,底层核心技术是 RAG(检索增强生成)。大模型在调用爬虫抓取你网页内容时,第一步就是做 Chunking(文本切片)。如果你的页面用 <article>、<section> 和各级标题标签切分得清清楚楚,AI 的切片算法就能完美地切出一段高内聚的知识段落送入大模型向量库;反之,如果满屏是混沌的 <div>,AI 抓取切出来的文本就会夹杂导航词、版权声明和相关推荐碎片,导致大模型直接判定内容不可信,最终放弃引用你的网站作为参考源。
怎么快速排查自己站点的语义结构?
作为技术运维或站长,想要优化这一点,并不需要重构整个系统,按下面三步走即可:
- 脱掉 CSS 裸奔测试:在浏览器里用插件禁用掉页面的全部样式(CSS)。这时候看页面,大标题、正文、副标题、导航栏是否依然逻辑分明、层级清晰?如果是,说明骨架合格;如果乱成一团,那搜索引擎看到的也是一团浆糊。
- 善用 HTML5 Outliner:安装一个 HTML5 Outliner 插件,或者用 Chrome 开发者工具的 Accessibility(无障碍)面板,看一看它解析出来的文档大纲(Outline)。一个合格的网页,其大纲结构应该像一本结构严谨的书的目录。
- 别拿语义标签套样式:坚决杜绝“为了加个圆角写个
<section>,为了居中文字写个<header>”的陋习。结构归结构(HTML),展示归展示(CSS),职责越明确,爬虫处理起来越轻松。
总的来说,做 SEO 越到深水区,比拼的越是底层细节的规范性。多花半小时把模板里的死标签替换成规范的 HTML5 语义化标签,不仅能实打实减轻服务器渲染和爬虫抓取的开销,更能让搜索引擎毫无障碍地读懂你的页面价值——这才是最低成本、最稳健的技术型 SEO 策略。
相关文章
- 内链拓扑结构对百度蜘蛛抓取深度的影响:别让稀烂的内链,把百度蜘蛛挡在网站大门外
- 网站百度蜘蛛抓取量断崖式下跌原因剖析:百度蜘蛛不爬了?老站长教你排雷
- 智能DNS解析针对百度蜘蛛独立配置线路:别让延迟毁了收录,DNS分流实战
- 降低百度蜘蛛抓取耗时的服务器优化方案:百度蜘蛛抓取慢?老站长的服务器提速心法
- URL重写伪静态对百度蜘蛛抓取效率的影响:伪静态:别让URL毁了你的收录
- 黑帽蜘蛛池诱导抓取与正规SEO的区别:蜘蛛池诱导与正规SEO实战录
- 网站改版301重定向引导百度蜘蛛权重转移:网站改版301权重转移实战指南
- 百度小程序爬虫与普通网页蜘蛛抓取差异:小程序与网页蜘蛛抓取实战避坑
- 新站TDK标签规范设置:新站做SEO,TDK到底该怎么填
- 网站初期核心关键词挖掘与布局:新站选词难?手把手教你把词定准