
MySQL数据库查询性能优化:搞定这几步,数据库查询飞起来
在很多网站维护和后端开发的日常中,最让人头疼的莫过于服务器CPU突然跑满、接口响应变慢,最后排查一圈,发现全卡在底层的数据拉取上。做好MySQL数据库查询性能优化,不仅是降低服务器负载、节省硬件成本的直接手段,更是提升网站首屏加载速度(TTFB)、改善核心Web指标以获取更好搜索引擎排名的关键基础。面对日渐庞大的数据量,查询优化从来不是靠“碰运气”乱加索引,而是一套环环相扣的系统性工程。
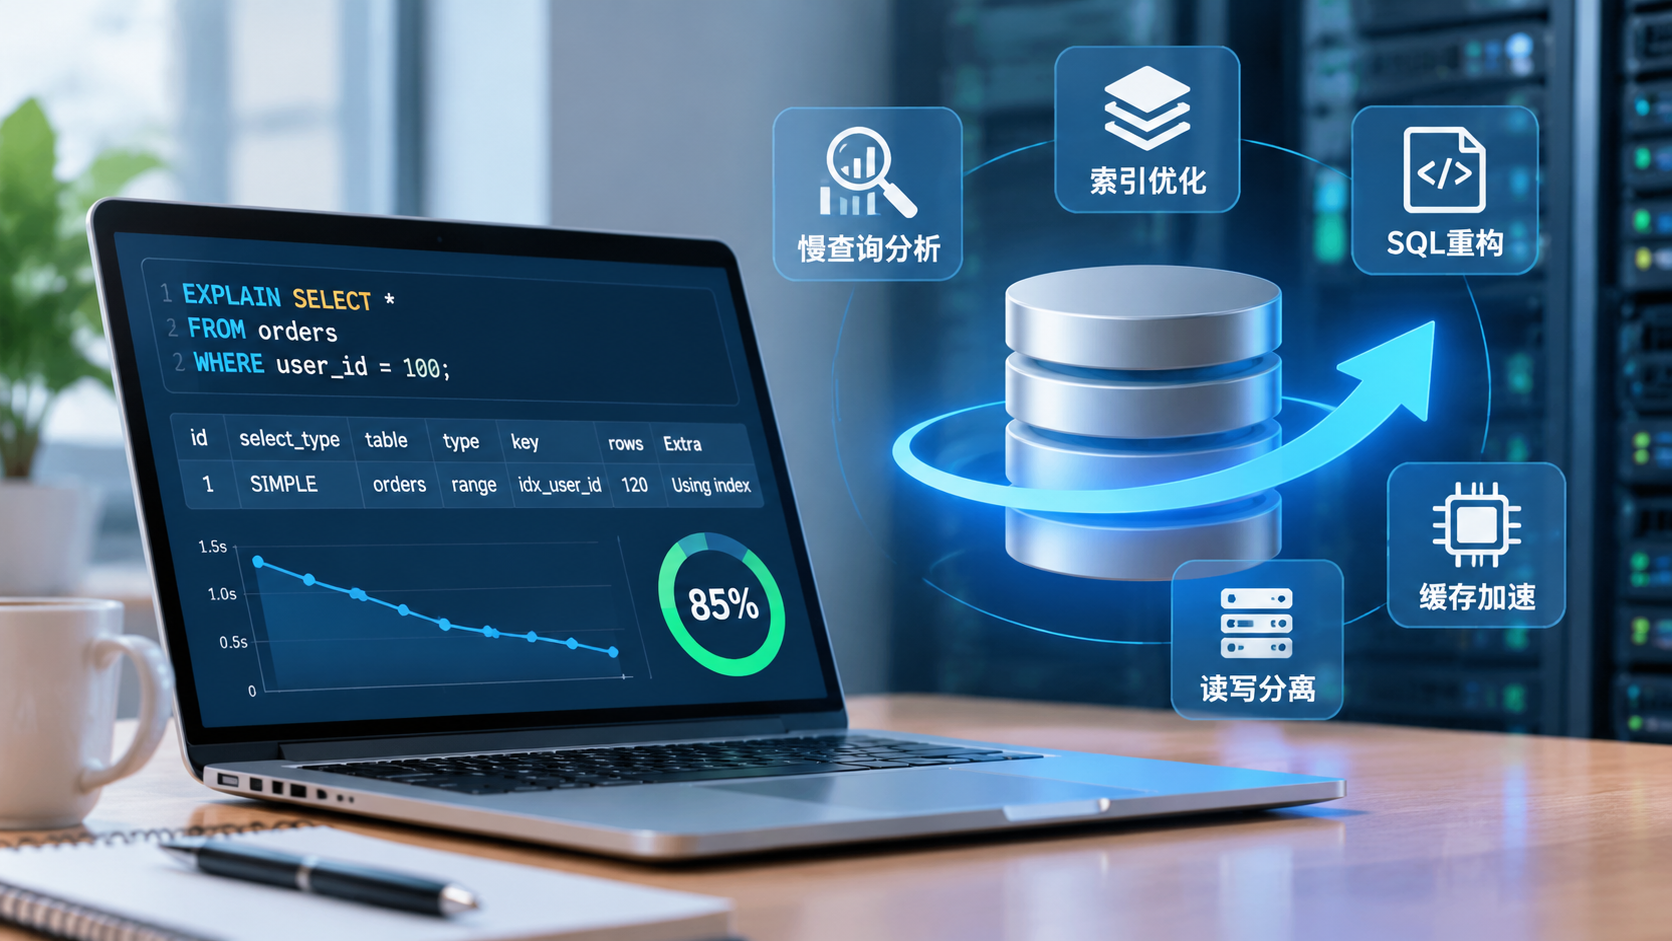
一、 别盲目动手:用工具揪出“慢查询”
优化查询的第一步,不是打开代码去改SQL,而是先弄清楚到底哪条语句拖垮了系统。
-
开启慢查询日志(Slow Query Log)
这是最直观的排查工具。在生产环境中,你可以设置阈值,让MySQL自动记录运行时间超过指定秒数的语句:SET GLOBAL slow_query_log = 'ON'; SET GLOBAL long_query_time = 1; -- 记录超过1秒的SQL通过自带的
mysqldumpslow工具定期分析日志,把执行次数最多、耗时最长的前几条语句挑出来重点攻关。 -
吃透
EXPLAIN执行计划
找到问题SQL后,在它前面加上EXPLAIN执行一下,重点看这几个核心指标:- type(访问类型):至少要达到
range级别,如果是ALL(全表扫描)或者index(全索引扫描),性能通常很差,需要重点优化。 - key(实际使用的索引):如果为
NULL,说明根本没走索引。 - rows(预估扫描行数):数值越小越好。扫描上百万行才查出几条数据,绝对有问题。
- Extra(额外信息):如果出现
Using filesort(文件排序)或Using temporary(使用临时表),说明查询逻辑消耗了大量内存和IO,必须调整。
- type(访问类型):至少要达到
二、 索引优化:打蛇打在七寸上
很多人以为“给字段加索引”就能解决一切,但错误的索引不仅没用,还会严重拖慢写入速度。
-
最左前缀匹配原则
在建立联合索引时,字段的顺序决定了索引的生死。例如建立了(status, create_time, user_id)的复合索引,查询条件必须包含最左边的status才能用上索引。如果跳过它直接查create_time,这个索引就会直接失效。 -
善用“覆盖索引”,避免回表
这是性能飞跃的关键技巧。如果你的查询是SELECT user_id, status FROM orders WHERE user_id = 100,而你刚好建了(user_id, status)的联合索引,MySQL直接从索引树上就能拿到数据,完全不需要再去聚簇索引里做二次“回表”查询,IO开销能瞬间降到最低。 -
警惕隐式失效的“暗坑”
- 函数操作:
WHERE DATE(create_time) = '2023-10-01'会让索引彻底失效,应改成范围查询:WHERE create_time >= '...' AND create_time < '...'。 - 隐式类型转换:如果字段是字符串(varchar),查询时却写成数字(如
WHERE phone = 13800000000),MySQL会自动调用函数转换类型,导致无法使用索引。 - 头部模糊匹配:
LIKE '%abc'无法走索引,只有右侧通配符LIKE 'abc%'才能走范围索引。
- 函数操作:
三、 SQL重构:改写低效的查询逻辑
有时候索引没有问题,而是写SQL的方式违背了关系型数据库的读取原理。
-
*坚决告别 `SELECT `**
多查出来的无用字段不仅占用网络带宽,还会阻碍覆盖索引的生效,增加数据库解析数据的内存压力。需要什么字段就查什么字段。 -
拯救“深分页”灾难
类似LIMIT 1000000, 20这种操作,MySQL的做法是扫描前 1000020 条数据,然后扔掉前 100 万条,只保留最后 20 条,磁盘IO极其夸张。
优化方案(延迟关联):
先利用子查询在覆盖索引上查出对应的主键ID,再去主表拿完整数据:SELECT t.* FROM my_table t JOIN (SELECT id FROM my_table ORDER BY create_time DESC LIMIT 1000000, 20) sub ON t.id = sub.id;这种改法通常能让原本几十秒的深分页查询骤降至毫秒级。
-
合理拆分与小表驱动大表
复杂的连表(超过3张表以上的JOIN)在数据量增大后极难优化。在高并发场景下,更推崇将大SQL拆分为多条简单的主键查询,在业务代码层(或借助缓存)进行组装。这样不仅查询速度快,而且极易利用应用层缓存。
四、 底层与架构层面的双重保障
SQL优化到了极致,还需要底层环境和架构的协同配合:
- InnoDB Buffer Pool 调优:对于专属的数据库服务器,建议将
innodb_buffer_pool_size设置为物理内存的 60% - 75%,尽量让热点数据和索引全部常驻内存,减少物理磁盘寻道。 - 引入分布式缓存(Redis):针对读多写少的高频查询(比如网站首页分类、全局配置、热门文章),直接用 Redis 挡在 MySQL 前面,让90%的流量不落库,这是性价比最高的减负方案。
- 读写分离与归档:历史数据是查询变慢的罪魁祸首。定期将半年前、一年前的冷数据归档至历史库,主库只保留热数据;对读流量极大的站点搭建主从复制架构,实现读写分离。
总结
性能调优不是一蹴而就的魔法,而是一个“监控—定位—改写—验证”的持续闭环。优先通过慢查询日志找到瓶颈,利用执行计划有的放矢地优化索引与重写SQL,最后辅以合理的缓存和架构设计。遵循这套逻辑,数据库的响应速度和整体站点的承载能力都会得到质的提升。
相关文章
- Windows 11关闭后台遥测与自带广告:彻底干掉Win11偷跑流量与流氓广告
- C盘爆满深度清理与迁移技巧:C盘又红了?教你彻底清理与搬家
- 禁用无用Windows服务释放内存:砍掉这几个后台服务立省1G内存
- 开机自启项深度排查与彻底禁用:彻底干掉服务器里的自启动后门
- SSD固态硬盘4K对齐与TRIM优化:服务器SSD太卡?老站长教你调优
- 虚拟内存合理分页文件设置:网站老崩?手把手教你设虚拟内存
- 彻底卸载Windows预装全家桶软件:手把手教你干掉Win自带全家桶
- 注册表无效残留键值清理与修复:电脑老卡死?手把手教你清理注册表
- Chrome浏览器多标签内存占用优化:Chrome开多标签卡死?教你搞定
- 本地DNS缓存清理与网络延迟优化:网站解析老卡?清DNS降延迟实操