
AI会议纪要与录音转文字:开完会不用愁,AI帮你做纪要
相信很多人都有过这种崩溃瞬间:一场长达两小时的跨部门会议结束,老板转头一句“下班前把纪要发群里”,而你面对着杂乱无章的笔记本和手机里几百兆的音频录音欲哭无泪。这时候,AI会议纪要与录音转文字技术简直就是当代打工人的“救命稻草”。但很多人用了之后发现,要么转出来的文字错漏百出,要么AI总结出来的东西全是车轱辘废话,根本没法直接向领导汇报。今天我就从实操和技术落地的角度,聊聊怎么把这项技术真正用顺手,彻底告别手动码字。
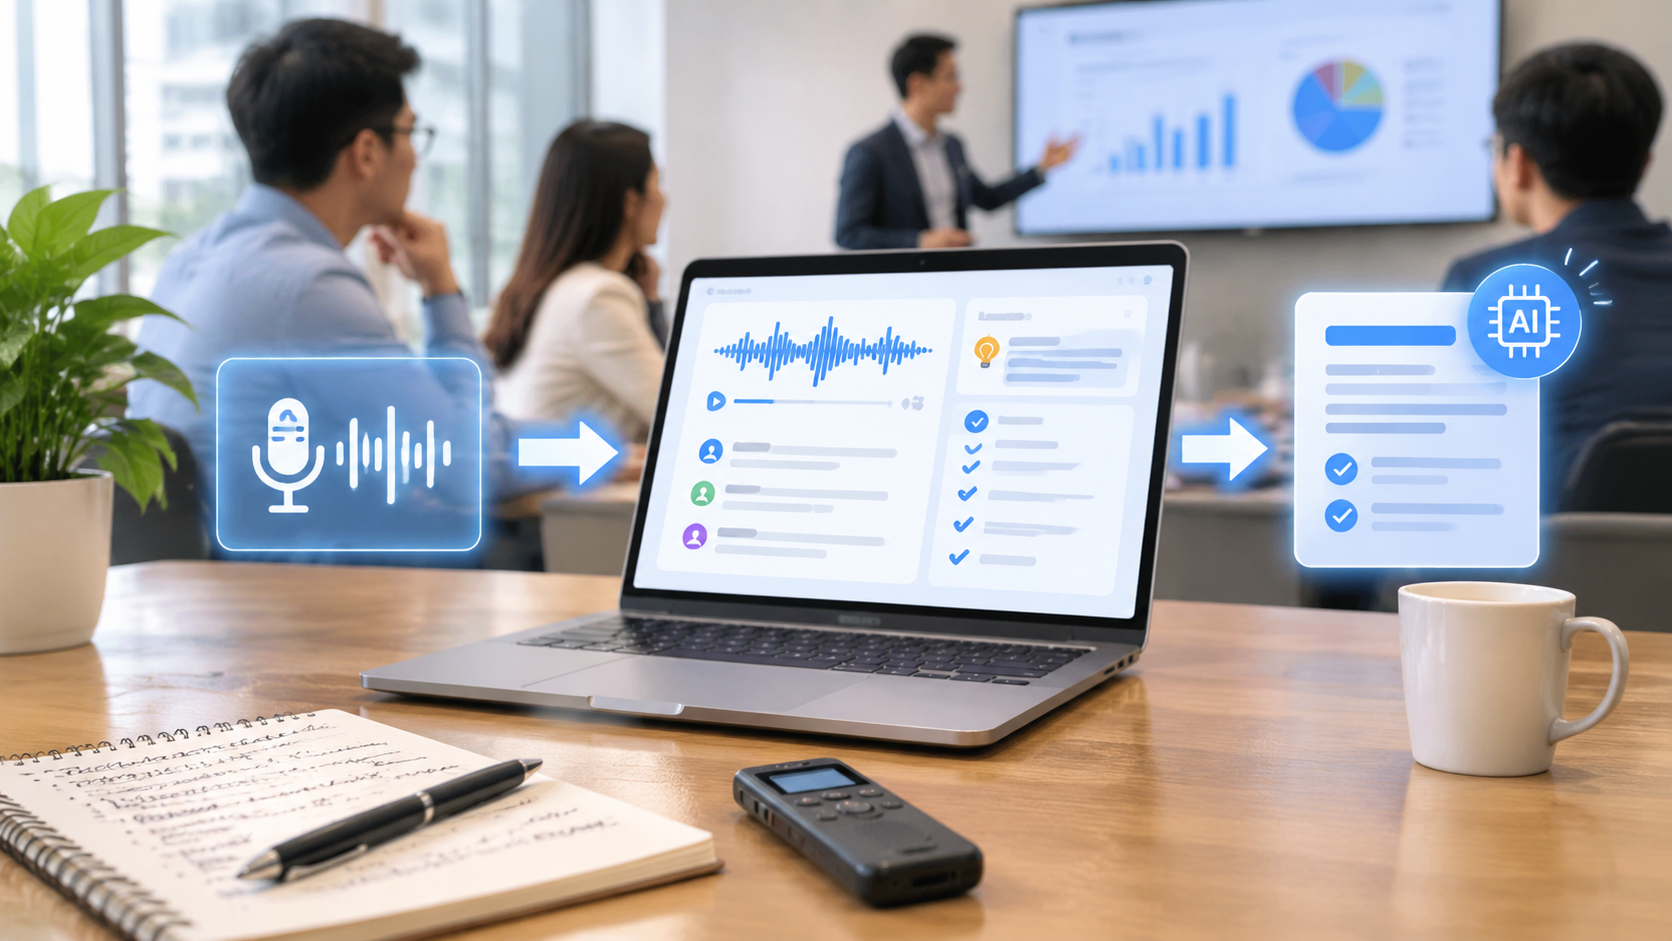
一、 为什么以前的录音转写像“人工智障”,现在却变聪明了?
要想用好工具,得先知道它背后的逻辑。以往我们用的录音转文字,核心只是语音识别(ASR,Automatic Speech Recognition),它的逻辑是“听到什么音,就打什么字”。一旦遇到普通话不标准、吞字、中英夹杂或者背景噪音,它就会完全宕机,转出一堆让人看不懂的天书。
而现在的AI会议纪要与录音转文字之所以产生质的飞跃,关键在于它由两个引擎共同驱动:
- 前半段:高精度的语音识别(ASR)+ 声纹切分(Diarization) 现在的模型不仅能把声音变文字,还能通过声纹判断“这句话到底是谁说的”,自动把发言人A、发言人B区分开来。
- 后半段:大语言模型(LLM)的理解与重构 这是颠覆性的一步。LLM不再纠结于个别错别字,它具备上下文理解能力,能自动过滤“嗯、啊、这个、那个”等语气助词,纠正同音错别字,并把口语化的长篇大论提炼成结构清晰的待办事项(TODO)和核心结论。
二、 落地痛点攻克:如何让识别率从70%飙升到95%?
很多人觉得工具不好用,其实是踩了输入源和配置的坑。以下这几个技巧,能立刻解决识别不准的问题:
1. 声音源头控制:垃圾进,垃圾出(Garbage in, Garbage out)
AI再强也救不了劣质录音。如果大家围坐在大长桌前,只用一台手机放在桌角录音,回声、敲键盘声、杂音混在一起,神仙也分不清。
- 低成本方案:推荐会议主持使用全向麦克风(如会议麦克风音箱),百来块钱就能大幅改善拾音降噪效果。
- 线上会议:尽量走系统内录(虚拟音频驱动直接抓取电脑声音),而不是用手机对着电脑外放录音,音质差异极大。
2. 专有名词与行业黑话“喂养”
每个行业都有缩写,比如互联网的GMV、ROI,研发的K8s、QPS,传统制造业的各种专业配件编号。通用模型遇到这些词通常会胡乱匹配汉字。
- 实操解法:市面上主流的工具(如飞书妙记、通义听悟、讯飞等)都支持“热词库”或“术语表”功能。在开会前,把你们业务常用的50个专业词汇、人名、项目代号录入进去,转写准确率能肉眼可见地提升一个档次。
三、 从纯文本到合格纪要:提示词(Prompt)怎么给?
拿到一万字的会议文字底稿,千万不要直接让AI“帮我总结一下”,这样你大概率会得到一段毫无营养的摘要。真正实用的会议纪要,必须包含:背景与议题、各方观点、达成共识的决策、后续行动项(谁在什么时间前完成什么)。
如果你使用的是外挂大模型(例如把导出的文本发给ChatGPT、Claude或Kimi),可以套用下面这个结构化提示词模板:
实用Prompt模板:
“你是一名资深项目管理专家。请根据以下会议转写文本,整理出一份专业的会议纪要。
文本中可能包含同音错别字和口语废话,请结合上下文自动修正并忽略无效信息。
输出必须严格遵循以下结构:
- 会议基本信息:包括核心议题、参会主要角色。
- 核心决议(Key Decisions):明确本次会议定下了哪些事情(用bullet points列出)。
- 待办任务清单(Action Items):严格按照‘任务内容 - 责任人 - 截止时间’的表格形式呈现,没有明确责任人的请标注‘待认领’。
- 争议与未决事项:有哪些问题讨论了但没达成一致,需要在下次会议跟进。”
用这种方式生成的纪要,稍微扫一眼核对下责任人,就能直接发给团队甚至抄送老板,专业度直接拉满。
四、 工具选型:公有云SaaS还是本地私有化?
市面上的产品五花八门,选哪个主要看你的使用场景和安全考量:
1. 个人与普通企业(开箱即用型)
- 飞书妙记 / 钉钉闪记:如果你本身就在用这些协同办公软件,首选自带的工具。它们的协同能力最强,支持点击文字直接跳转回对应音频段落,校对极其方便。
- 通义听悟 / 讯飞听见:转写准确率极高,特别是针对带有口音的普通话、中英混合场景,且自带的大模型摘要功能非常接地气。
2. 高度重视数据安全、涉及商业机密(私有化部署型)
对于很多技术研发团队、金融法律行业,把包含商业机密的录音上传到公有云是大忌。
- 技术方案:采用开源的 OpenAI Whisper 模型进行本地音频转文字,再接入本地运行的开源大语言模型(如基于 Ollama 部署的 Llama 3 或 DeepSeek)。
- 运维门槛:一台带有一张中端显卡(如RTX 3060及以上)的内网服务器,就可以支撑全公司离线、免费、无泄漏风险地处理所有会议音频。
总结
AI会议纪要与录音转文字从来都不是要完全取代人的思考,而是帮我们把繁重、机械的“听录音、敲键盘”工作剥离出去。我们要做的,是把关好录音质量、调教好专有词汇,最后花五分钟对AI生成的待办事项做一次逻辑核对。学会用好这一套组合拳,省下来的时间无论是去钻研业务还是早点下班,它不香吗?
相关文章
- AI自动生成PPT工具实测:站长实测:AI做PPT别再踩坑了
- Coze接入飞书搭建业务Bot:Coze接飞书搭业务Bot实操
- AI批量提取扫描件PDF数据:AI提取扫描件PDF数据实操
- AI批量清洗去重客户名单:名单去重与站长文案实操指南
- Cursor辅助编写日常运维脚本:Cursor写运维脚本实操指南
- 开源AI录音转文字私有化部署:搞定本地语音转文字与站长写作
- AI一键生成业务流程思维导图:老站长教你用AI秒画业务流程图
- AI自动审查合同关键条款风险:老站长聊AI审合同的避坑实操
- Claude长文本快速提炼行业报告:老站长用Claude啃透行业报告
- AI办公数据泄露风险与防范:别乱用AI办公了,数据正在被看光