
垃圾外链清理与Disavow工具实操:垃圾外链Disavow实操
做垃圾外链清理与Disavow工具实操,别听市面上那些只会卖焦虑的SEO代运营瞎忽悠,直接甩结论:90%的采集站、镜像站垃圾外链搜索引擎自己会直接忽略,平时根本不用管;只有当你后台收到“手动惩罚(Manual Action)”通知,或者被同行用黑帽手段在短时间内狂刷几千条博彩、色情、黑产锚文本且流量出现断崖下跌时,才需要动用 Disavow 工具提交拒链文件。盲目把低权重外链全拒掉,大概率是在自断经脉,甚至直接把网站拉进沙盒。
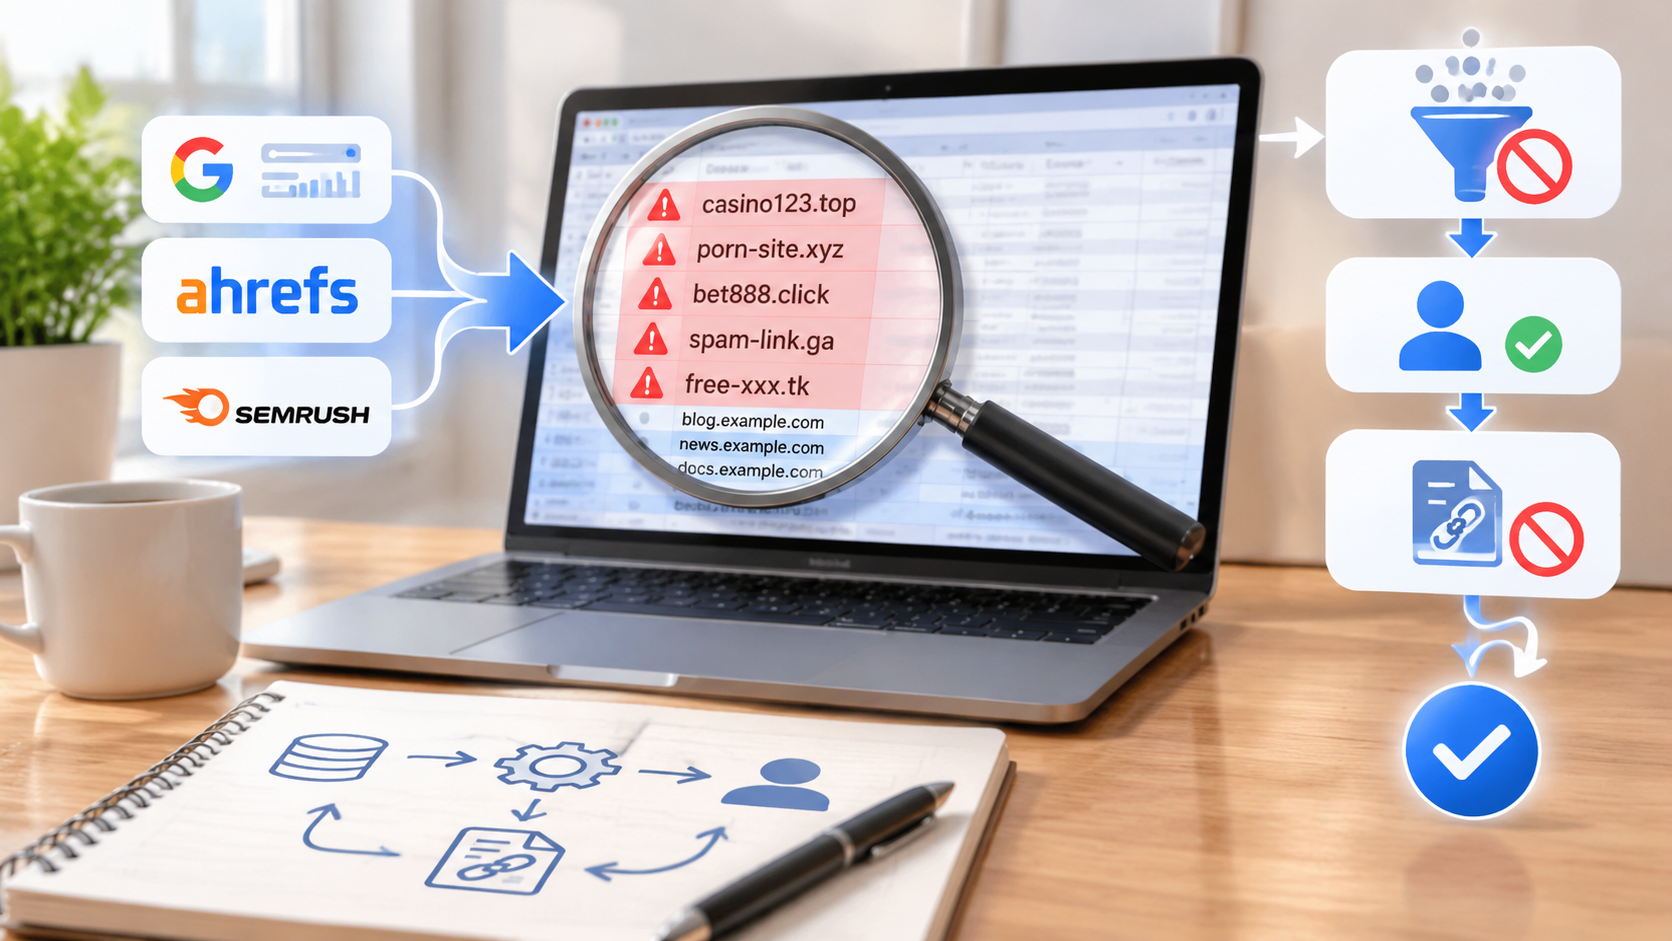
真正能落地的处理闭环只有四步:多渠道全量导出外链 -> 脚本清洗去重并标记高危特征 -> 人工抽检剔除误杀 -> 按严格格式上传 disavow.txt 并覆盖留档。下面直接上干货和可直接套用的脚本与配置。
核心方案速览
动手之前先把整体流水线对齐,免得在后台无头苍蝇一样乱点:
- 全量拿数据:别只信 Google Search Console(GSC)导出的那点数据,GSC 只给最多 1000 条样本。必须合并 GSC + 第三方工具(Ahrefs / Semrush) 的外链导出 CSV,才能看清全貌。
- 自动化初筛:用下面提供的 Python 脚本,按“高危锚文本词库 + 垃圾后缀/IP特征 + 异常外链密度”把几十万行数据洗成几百个可疑域名。
- 人工二次复核:重点排查免费建站平台(如
blogspot.com、github.io、wordpress.com)和新闻聚合站,严禁一刀切封杀整个根域名。 - 规范上传与生效:生成 UTF-8 无 BOM 编码的纯文本文件,去 GSC 专属隐藏入口(仅支持网址前缀资源)提交。如果是手动惩罚,提交拒链后必须补交重新审核请求(Reconsideration Request)。
实操细节深度拆解
1. 数据抓取与去重合并
实战中最常遇到的问题是:外链动辄几万条,Excel 打开直接卡死,而且各家工具导出的格式还不统一。
- 适用场景:被黑帽恶意刷链,需要从 GSC、Ahrefs 等多个渠道把所有指向你域名的 URL 汇到一起提取唯一域名。
- 操作步骤:把所有导出的外链 CSV 放进同一个文件夹,如果在 Linux 或 Mac 终端下,直接用下面这条命令把所有 URL 提取并按根域名/主机名去重(假设第一列或包含
http的字段是来源 URL):
# 从多个 CSV 中提取所有 http/https 链接的域名部分,排序去重后输出到 all_domains.txt
grep -hEo 'https?://[^/,"]+' *.csv | awk -F/ '{print $3}' | sed 's/^www\.//' | sort -u > all_domains.txt

# 统计总共有多少个独立来源域名
wc -l all_domains.txt- 避坑点:千万别用正则暴力把所有二级域名全砍成主域名。比如
spam-123.blogspot.com和tech-blog.blogspot.com是两个完全独立的站点,如果直接截断成blogspot.com,后面一键拒链会把整个 Blogspot 平台上的正常外链全干废。
2. 自动化初筛脚本(直接套用)
人工一条条看外链纯属浪费生命。市面上很多所谓的“外链检测工具”收几百块月费,核心逻辑其实就是关键词匹配和域名特征过滤。下面这段纯 Python 标准库脚本(无需安装任何第三方包),直接跑在你的导出表上,就能把真正有毒的链接筛出来。
- 适用场景:手里拿到了包含
Source URL(来源链接)和Anchor(锚文本)的 CSV 文件(以 Ahrefs/GSC 常见格式为例),需要快速定位黑产、色情、博彩、批发生长类垃圾站点。 - 完整可执行代码(保存为
filter_spam.py):
import csv
import re
from urllib.parse import urlparse

# 1. 高危违禁词库(根据你的业务实际情况增删,英文站点注意大小写)
BLACKLIST_KEYWORDS = [
    "casino", "poker", "bet", "slot", "gambling", "porn", "sex", "xxx",
    "viagra", "cialis", "loan", "essay", "hack", "crack", "keygen",
    "博彩", "时时彩", "菠菜", "代孕", "办证", "发票", "色情", "外围"
]

# 2. 垃圾镜像站/群发站高频特征后缀及正则
SPAM_TLD_PATTERN = re.compile(r'\.(xyz|top|click|gq|cf|tk|ml|ga|icu|buzz|monster)$', re.I)
# 纯数字或无意义随机长串前缀特征(典型黑帽站群,如 a8f9s7d6.com)
GIBBERISH_PATTERN = re.compile(r'^[a-z0-9]{12,}\.[a-z]+$', re.I)
# 免费托管平台白名单(这些平台只能封子域名或单页,不能封根域名)
FREE_PLATFORMS = {"blogspot.com", "wordpress.com", "github.io", "wixsite.com", "weebly.com", "tumblr.com"}

def extract_host(url):
    try:
        if not url.startswith(('http://', 'https://')):
            url = 'http://' + url
        host = urlparse(url).netloc.lower()
        # 去掉端口号
        host = host.split(':')[0]
        return host[4:] if host.startswith('www.') else host
    except Exception:
        return ""

def analyze_backlinks(input_csv, output_review_csv, output_disavow_txt):
    suspicious_domains = {}

    with open(input_csv, mode='r', encoding='utf-8-sig', errors='ignore') as f:
        reader = csv.DictReader(f)
        # 自动兼容常见字段名(使用前请确认你的CSV表头名称)
        for row in reader:
            src_url = row.get('Referring page URL') or row.get('Source url') or row.get('URL') or ''
            anchor = row.get('Anchor') or row.get('Anchor text') or ''

            host = extract_host(src_url)
            if not host:
                continue

            reasons = []
            text_to_check = f"{src_url} {anchor}".lower()

            # 检查违禁词
            for kw in BLACKLIST_KEYWORDS:
                if kw in text_to_check:
                    reasons.append(f"命中违禁词:{kw}")
                    break

            # 检查高危后缀与乱码站群域名
            if SPAM_TLD_PATTERN.search(host):
                reasons.append("高危垃圾后缀")
            if GIBBERISH_PATTERN.match(host):
                reasons.append("疑似随机生成站群域名")

            if reasons:
                is_free_platform = any(host.endswith(fp) for fp in FREE_PLATFORMS)
                suspicious_domains[host] = {
                    "sample_url": src_url,
                    "anchor": anchor[:60],
                    "reason": " | ".join(reasons),
                    "is_free_platform": is_free_platform
                }

    # 输出人工复核表
    with open(output_review_csv, mode='w', encoding='utf-8-sig', newline='') as f:
        writer = csv.writer(f)
        writer.writerow(["Domain", "Reason", "Free_Platform_Warning", "Sample_URL", "Anchor"])
        for host, info in suspicious_domains.items():
            writer.writerow([host, info["reason"], info["is_free_platform"], info["sample_url"], info["anchor"]])

    # 生成初步的 Disavow 草稿
    with open(output_disavow_txt, mode='w', encoding='utf-8') as f:
        f.write("# 自动初筛生成的 Disavow 草稿 - 上传前务必人工核对\n")
        for host, info in suspicious_domains.items():
            # 如果是免费平台子域名,保留完整子域名或提示人工改为单页URL
            if info["is_free_platform"]:
                f.write(f"# [注意:免费平台子域] {info['sample_url']}\n")
                f.write(f"domain:{host}\n")
            else:
                f.write(f"domain:{host}\n")

    print(f"处理完成!共标记可疑域名 {len(suspicious_domains)} 个。")
    print(f"请先打开 {output_review_csv} 人工复核,确认无误后再整理上传 {output_disavow_txt}。")

if __name__ == "__main__":
    # 替换为你实际的文件名
analyze_backlinks("backlinks_export.csv", "need_review.csv", "disavow_draft.txt")- 避坑点:千万不要看 DA/DR(域名权重)低就列入黑名单! 这是新手最容易交智商税的地方。很多垂直小众博客、个人独立开发者站点 DR 只有 5 到 15,但人家是真实编辑推荐的优质外链。判断是否垃圾的核心标准只有一个:内容相关性 + 是否有黑产/群发/纯采集特征,而不是第三方工具算出来的评分。
3. 编写标准 disavow.txt 文件
Google 对拒链文件的格式要求极其死板,格式不对它会直接跳过那一行甚至整份报错。
- 可直接套用的标准文件模板:
# 2025-05-10 清理黑帽刷量外链(第一批)
# 症状:大量博彩与色情锚文本指向首页
domain:spam-casino-site1.xyz
domain:fake-mirror-2025.top
domain:auto-scraper-bot.click

# 针对免费建站平台或大型UGC站点,只拒绝具体垃圾页面或具体子域名,严禁写根域名
https://example-user.blogspot.com/2025/04/spam-post.html
domain:spammy-sub.github.io

# 2025-05-18 补充清理镜像站群
domain:123456abcdef.icu- 核心规范与避坑点:
- 域名级 vs URL级:95% 的纯垃圾站直接用
domain:example.com,注意冒号后面没有空格,也不要加http://和www.。只有遇到github.io、blogspot.com、reddit.com这类大型平台时,才用具体 URL 或具体二级域名(如domain:spammer.blogspot.com),绝不能写domain:reddit.com。 - 编码格式致命坑:必须是 UTF-8(无 BOM) 或 7-bit ASCII 编码,扩展名为
.txt。如果你用 Windows 自带记事本保存 UTF-8,或者从 Excel 复制带了隐形字符,极易出现 BOM 头导致 Google 解析第一行失败。上传前用命令行检查并转码一下最稳妥:
- 域名级 vs URL级:95% 的纯垃圾站直接用
# 检查文件编码(看到 UTF-8 Unicode text 且没有 with BOM 字样才算合格)
file disavow.txt

# 如果带了 BOM 头,用 sed 一键剥离
sed -i '1s/^\xEF\xBB\xBF//' disavow.txt- 体积限制:单文件不能超过 100,000 行,体积不能超过 2 MB。如果真被刷了几十万条,优先把同源的垃圾全用
domain:合并,别傻傻地按 URL 往里堆。
4. 提交入口与踩坑实录
Google 早几年就把 Disavow 工具从 GSC 主菜单里藏起来了,目的就是防止站长没事乱点把自己搞死。
- Google 官方直达入口:
https://search.google.com/search-console/disavow-links - 最大踩坑点(Property 类型限制):
点进去之后你会发现下拉列表里找不到你的域名!别慌,不是账号坏了,而是 Disavow 工具只支持“网址前缀(URL-prefix)”类型的资源(比如
https://www.yourdomain.com/),不支持“网域(Domain)”类型资源(sc-domain:yourdomain.com)! 如果你当初只验证了网域资源,必须先回 GSC 左上角补验证一个对应协议头(https://带或不带www)的网址前缀资源,刷新拒链页面就能选到了。 - Bing(必应)怎么处理? 别再到处找 Bing Webmaster Tools 里的 Disavow 入口了。微软早在 2023 年下半年就已经正式下线了必应拒链工具。Bing 官方明确表示现在的算法已经能自动识别并无视绝大多数垃圾外链,不需要站长手动提交。遇到某些“资深顾问”还在收钱帮你做 Bing 拒链的,直接拉黑。
- 手动惩罚(Manual Action)的补充动作:
如果 GSC 后台已经亮红牌提示“指向您网站的非自然链接”,光上传
disavow.txt没有任何卵用,惩罚不会自动解除! 正确流程是:先按格式联系其中一部分站长要求删链(把发邮件的截图或记录存进 Google Sheet 作为“尽职调查”证据),剩下的全部写进disavow.txt上传,最后回到“人工操作”面板点击请求审核,附上你的清理说明和那份邮件记录表链接,等 Google 人工审核团队解封。
高频关联问题拓展
1. 提交了 Disavow 文件,为什么 GSC 后台“链接”报告里还能看到这些垃圾外链?
这是正常现象,别反复重复提交。Disavow 工具的本质,是让 Google 爬虫下次重新抓取到这些垃圾页面时,在内部给那条链接打上一个隐形的 nofollow 标签,使其不参与权重计算。它既不会从互联网上物理删除那条链接,也不会改变 GSC 后台的“已知外链”展示列表。 通常需要几周到几个月(取决于搜索引擎重新抓取那些垃圾页面的频率)才会逐步消除影响。
2. 手抖误删了正常外链或者行业媒体链接,怎么撤回?
Google 的拒链机制是全量覆盖(Overwrite),不是增量追加!
- 千万别新建一个只写了几条新域名的文件去上传,那样会把你之前辛苦整理的几百条垃圾域名全覆盖清空!
- 正确做法:进入 Disavow 工具页面 -> 选择你的网站资源 -> 点击下载列表(Download list),把当前线上生效的
disavow.txt下载到本地 -> 删掉你误杀的那几行正常域名(或者把新发现的垃圾域名追加到末尾) -> 重新上传这份完整的最新文件。
3. 被黑帽竞争对手持续刷垃圾外链,多久清理一次合适?
没必要每天盯着工具看,纯属内耗。Google 自从 Penguin 4.0 算法融入核心后,绝大多数低质外链都是直接“贬值无视(Devalue)”而不是直接扣分。建议每月例行巡检一次即可,或者在核心词排名出现无故全站性暴跌时紧急排查。只有当短时间内突然涌入大量高危锚文本,或者同 IP 段下几百个站群同时指向你核心转化页时,才需要介入清理。
4. 自己网站以前被黑挂过马,别人顺着木马页面刷了一堆垃圾外链过来怎么办?
这种场景根本不用写 Disavow!只要你已经清理了服务器木马并删除了那些黑产生成的页面,让服务器对这些死链直接返回 404 或 410 状态码即可。搜索引擎爬虫看到目标页面已经是 404/410,指向它的外部垃圾链接自然就作废了,没必要再去拒链文件里凑字数。只有当这些垃圾外链直接指向你正常存活的首页或核心栏目页时,才需要放进 disavow.txt。
总结
垃圾外链清理与Disavow工具实操的核心心法就八个字:宁缺毋滥,精准打击。它本来就是搜索引擎留给站长用来应对极端恶意攻击或历史遗留惩罚的“外科手术刀”,而不是日常天天吃的“保健品”。把上面那套自动化初筛脚本和核对规范收好,平时定期巡检做到心里有数;真遇到黑帽搞事时,按流程拉数据、去重、核验编码、针对性提交,稳准狠地把毒瘤切掉,别让外链焦虑耽误了正经做内容和业务优化的时间。
相关文章
- 谷歌沙盒期突围与页面快速收录技巧:谷歌沙盒期突围与页面快收指南
- 垃圾外链清理与Disavow工具实操:垃圾外链Disavow实操
- 服务器环境部署与CDN加速深度优化:服务器部署与CDN极速调优
- 独立站内容营销SOP与原创度把控:独立站内容营销SOP:原创流量的底层逻辑
- 谷歌图片搜索SEO流量获取实战:别盯着文字卷了,图搜流量才是独立站的隐形金矿
- 独立站SEO效果监控与数据看板搭建:别被虚荣指标骗了:手把手教你搭独立站SEO实战看板
- Google核心网页指标Core Web Vitals实操优化:老站长带你死磕CWV性能优化
- 外贸独立站Hreflang多语言标签防踩坑配置:独立站Hreflang避坑实操指南
- WordPress搭配Nginx极致优化TTFB实操:压榨Nginx:WP秒开TTFB实战
- Google Search Console索引报错深度排查与修复:GSC索引报错深度排查实操指南