
AI营销怎么复盘效果数据?从埋点清洗到ROI归因的全流程实操
AI营销怎么复盘效果数据,核心就一句话:别盯着生成了多少篇文案或图片这种自嗨指标,必须把模型版本、Prompt指纹作为追踪维度打入埋点系统,死磕“内容介入度、线索有效转化率(CVR)与算力摊薄后的真实ROI”。
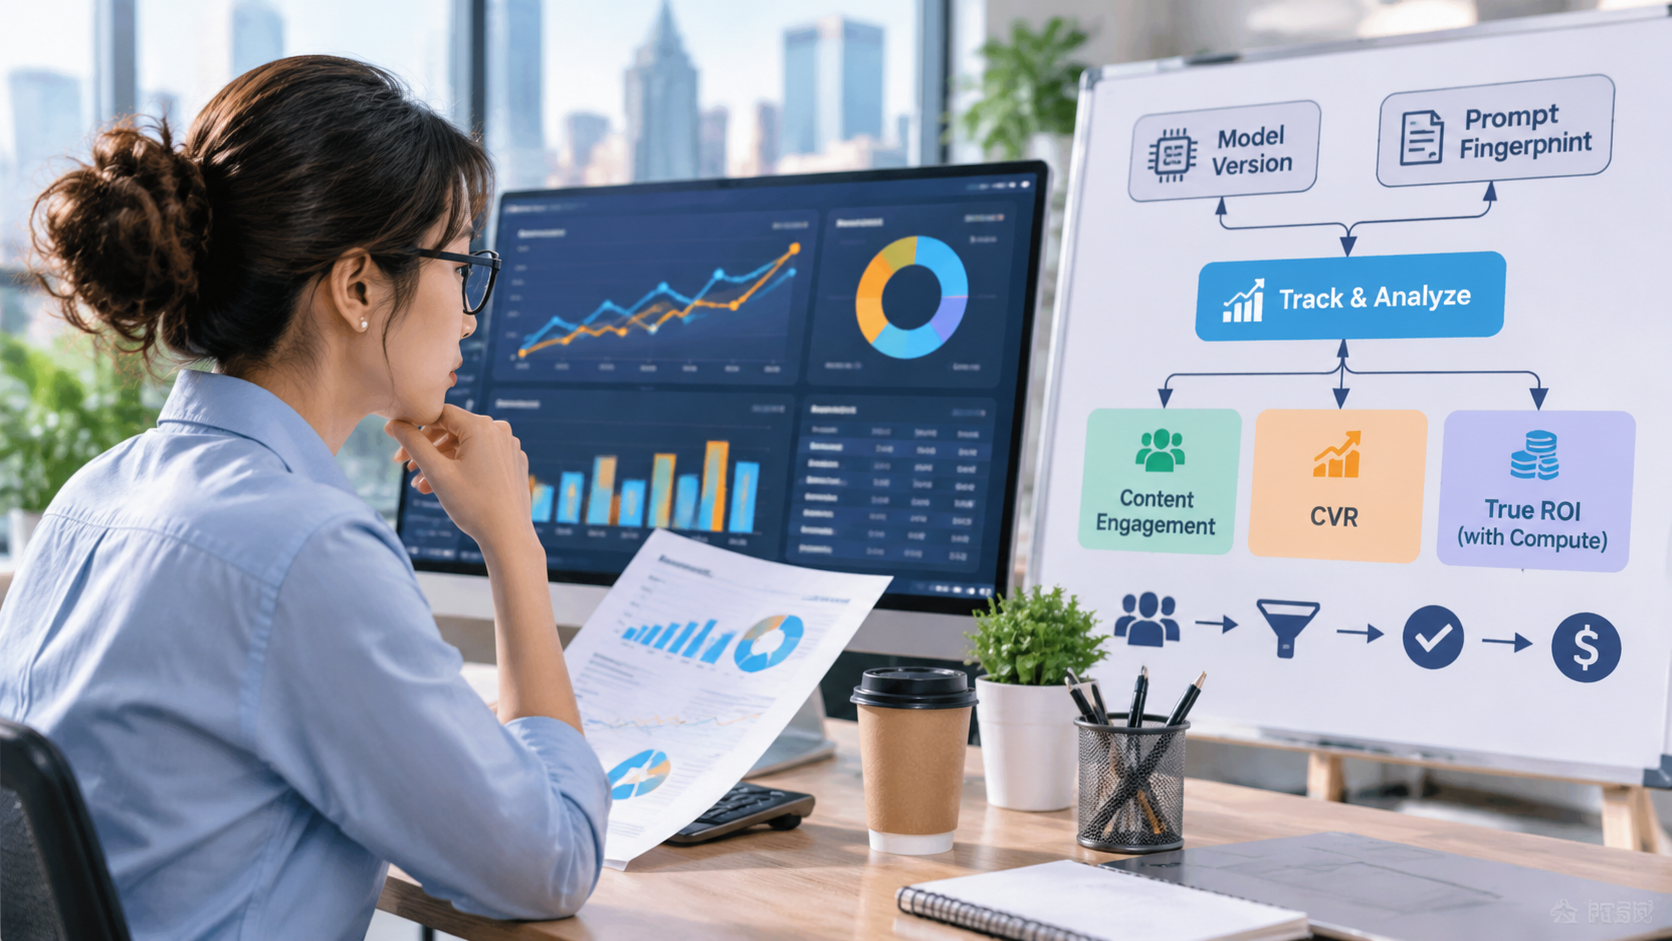
市面上很多团队做完一波AI营销,复盘PPT做得花团锦簇——“生成内容5000篇”、“曝光量提升300%”。销售部门一查后台,线索全是秒关跳出的垃圾流量,或者是大模型“幻觉”承诺了做不到的功能引来的无效客诉。这种复盘毫无意义。要想把AI营销的效果算得明明白白,必须建立从底层埋点到财务回款的闭环归因链路。
核心方案速览
复盘一套AI营销动作,直接按以下四个标准步骤执行:
- 链路标记(Trace ID打标):给每批AI生成的内容(文案、落地页、视频脚本)强绑定专属参数(包含模型名称、Prompt版本、人工微调等级)。
- 流量清洗(剔除虚荣指标):用停留时长、滚动深度、交互事件等硬指标,洗掉大模型高频词堆砌带来的无效“快餐PV”。
- 对照组归因(A/B Testing):拆分“纯人工组”、“AI直出组”、“AI初稿+人工精修组”,对比转化成本与周期。
- 全成本精算(算力计入CAC):把API Token消耗、中间件服务器、人工校对工时全部折算为营销成本,计算真实投产比。
实操细节深度拆解
步骤一:在生成阶段植入“追踪指纹”
很多团队复盘时两眼一抹黑,根本原因在于数据源头没打标。文章发在哪个渠道、是GPT-4o还是Claude 3.5生成的、套了哪版Prompt,运营人员自己都记不清。
实操做法: 在AI批量生成内容推送到CMS或社媒后台时,自动在URL或内容元数据(Meta Data)中植入结构化UTM参数。
以下是一个自动化生成带AI版本追踪链接的Python脚本片段:
import urllib.parse

def generate_ai_campaign_url(base_url, model, prompt_v, edit_level, campaign_id):
    """
    生成带AI营销追踪指纹的落地页链接
    edit_level: 0-纯AI直出, 1-轻度人工润色, 2-重度结构化重写
    """
    params = {
        "utm_source": "ai_matrix",
        "utm_medium": "seo_article",
        "utm_campaign": campaign_id,
        "utm_content": f"{model}_pv{prompt_v}_el{edit_level}", # 核心指纹
        "ai_trace_id": f"{campaign_id}_{hash(prompt_v)}"
    }
    encoded_params = urllib.parse.urlencode(params)
    return f"{base_url}?{encoded_params}"

# 示例调用
url = generate_ai_campaign_url(
    base_url="https://www.example.com/product",
    model="gpt4o",
    prompt_v="v3_painpoint_hook",
    edit_level=1,
    campaign_id="2024q3_lead_gen"
)
print(url)
# 输出: https://www.example.com/product?utm_source=ai_matrix&utm_medium=seo_article&utm_campaign=2024q3_lead_gen&utm_content=gpt4o_pv3_painpoint_hook_el1&ai_trace_id=...避坑点: 绝对不要只标记一个宽泛的“AI生成”标签。一旦某天线索量崩盘,你根本无法定位到底是模型降智、Prompt被改动,还是人工校对环节偷了懒。
步骤二:数据清洗与去噪,过滤“快餐流量”
AI生成的大批量SEO文章或社交媒体动态,很容易踩中搜索引擎和推荐算法的陷阱——前期因为关键词覆盖度高带来大量曝光,但用户点进来发现内容车轱辘话连篇,3秒内立刻关闭页面。
如果复盘只看UV和PV,你会被完全误导。
实操做法: 在数据分析平台(如Google Analytics 4、神策或自建ClickHouse)中,设置有效交互的过滤阈值。编写SQL提取真实转化数据:
-- 提取AI营销带来的高价值线索,过滤无效快餐访问
SELECT
    REGEXP_EXTRACT(utm_content, r'^(.*?)(?=_pv)') AS ai_model,
    REGEXP_EXTRACT(utm_content, r'pv([^_]+)') AS prompt_version,
    COUNT(DISTINCT session_id) AS total_visits,
    -- 核心过滤:页面停留时长 > 25秒,且滚动深度 > 50% 或触发过点击
    COUNT(DISTINCT CASE
        WHEN duration >= 25 AND (scroll_depth >= 0.5 OR click_count > 0)
        THEN session_id
    END) AS valid_visits,
    COUNT(DISTINCT user_id) AS lead_conversions,
    -- 计算真实有效转化率
    ROUND(COUNT(DISTINCT user_id) * 100.0 / NULLIF(COUNT(DISTINCT CASE
        WHEN duration >= 25 AND (scroll_depth >= 0.5 OR click_count > 0)
        THEN session_id
    END), 0), 2) AS valid_cvr_percent
FROM
    web_analytics_events
WHERE
    utm_source = 'ai_matrix'
    AND event_date BETWEEN '2024-07-01' AND '2024-09-30'
GROUP BY
    ai_model, prompt_version
ORDER BY
lead_conversions DESC;实操结论分析:
如果发现某个Prompt生成的页面 total_visits 极高,但 valid_visits 断崖式下跌,说明该Prompt生成的标题严重党化,存在欺骗点击或AI套话过重的问题,后续必须直接作废该模板。
步骤三:对照组复盘,评估AI生产的“真实增益”
复盘AI营销,本质上是衡量效率与效果的剪刀差。如果不做对照组,你很难向管理层证明到底是因为AI提效了,还是市场大盘本身的自然波动。
在复盘周期内,必须划分三个对照池进行横向拉平分析:
| 维度 | 组A:纯人工撰写 | 组B:AI+人工协同(推荐) | 组C:AI批量直出 |
|---|---|---|---|
| 单篇耗时 | 4小时 | 45分钟 | 2分钟 |
| 千字成本 | 200元(工时折算) | 40元(算力+人工) | 2元(纯API) |
| 跳出率 (Bounce Rate) | 42% | 45% | 78% |
| 最终线索获取成本 (CPA) | 120元 | 65元 | 190元(因无效流量大,导致转化极低) |
| 复盘结论 | 成本高,产能有瓶颈 | 综合投产比最高,应规模化复制 | 严重伤害域名权重与品牌,立即叫停 |
实操细节: 在很多真实业务场景中,组C(纯AI直出)的线索成本反而是最高的。因为搜索引擎对低质AI生成内容的识别能力越来越强,粗暴生成的批量内容甚至会触发降权机制,导致整站自然流量腰斩。复盘报告里一定要把这个技术损耗算进去。
步骤四:全口径成本核算(包含隐形成本)
评估AI营销的ROI,很多人只拿“广告费”和“成单金额”来算。这在传统营销行得通,在AI营销上绝对会产生财务幻觉。
真实的AI营销ROI计算公式: $$\text{真实ROI} = \frac{\text{AI营销带来的直接回款金额}}{\text{媒体投放费用} + \text{AI接口及算力消耗} + \text{微调/校对工时成本} + \text{技术支持与管线维护成本}}$$
需要核算的隐形支出项:
- API与算力费用:调用商用LLM接口(OpenAI、Anthropic等)的Token费用,本地部署开源模型(如Llama 3)的显卡租赁/折旧费用。
- 知识库与向量检索费用:RAG架构下Pinecone、Milvus等向量数据库的存储与查询开销。
- 清洗与人工复核工时:一个运营人员花在检查AI幻觉、修改错别字、修正品牌违禁词上的真实时间成本。
如果一个自动化营销管线每天能发1000篇推文,但需要3个资深工程师天天维护爬虫、修正接口断流、手动修复Prompt发疯导致的问题,那这个管线在复盘时就是技术负债,必须如实下结论关停或重构。
高频关联问题拓展
问题一:AI营销带来的线索量暴涨,但后端销售反馈“全是垃圾意向”,怎么定位?
排查与解决步骤:
- 核对输入端RAG(检索增强生成)知识库:检查AI给客户提供的信息是否包含“虚标参数”或“夸大承诺”。大模型为了迎合用户的提问(Sycophancy倾向),极易胡编乱造产品功能。
- 在落地页设置“过滤型交互”:不要只用AI生成简单的“提交姓名电话”表单。在表单中增加需要真实思考的选择题(例如:“您目前的月预算区间是?”、“当前遇到最核心的技术卡点是什么?”)。
- 用规则链拦截低意向数据:在将线索写入CRM系统前,跑一遍规则脚本。
def lead_quality_gatekeeper(lead_data):
    """
    线索有效性前置过滤网关
    """
    # 过滤明显的测试字符或无效占位符
    junk_inputs = ["test", "123", "aaaa", "随便", "无"]
    if lead_data.get("company_size") in junk_inputs:
        return False, "无效的企业规模"

    # 验证是否为真实业务邮箱(剔除临时/公共邮箱)
    public_domains = ["qq.com", "163.com", "gmail.com"]
    email_domain = lead_data.get("email", "").split("@")[-1]
    if email_domain in public_domains and lead_data.get("deal_type") == "B2B_Enterprise":
        # 降权但不断流,标记为低优先级进入培育池
        return True, "标记为低优先级培育线索"

    return True, "合格线索,准予入库派单"
问题二:多渠道批量发AI内容,如何避免被各大平台判定同质化降权?
排查与优化思路: 复盘时如果发现自然曝光曲线呈现“前高后断崖”,基本就是触发了平台的同质化指纹检测。
- 动态注入异构变量:禁止直接使用单套Prompt执行For循环批量生成。必须在Prompt中强制引入不同的受众角色、写作风格、字数跨度以及现实案例。
- 计算文本相似度监控大盘:每次批量推送前,用SimHash或余弦相似度算法对生成的文章库做自检,相似度高于65%的内容坚决打回重跑,避免“同质化灾难”。
结尾总结
搞清楚AI营销怎么复盘效果数据,本质上是一场从“唯量化论”向“唯价值论”的认知升级。千万不要被脚本跑出来的庞大生成数量所迷惑。在营销场景下,用错误模型写出来的十万篇垃圾内容,不仅带不来有效现金流,反而是对品牌资产和服务器算力的双重透支。
复盘时,老老实实把追踪埋点打深、用留存和互动硬指标清洗掉水分、把AI算力账单摆在明处,找出那套“转化率高、人工干预最少、Prompt表现最稳定”的最佳实践组合拳,这才是AI营销复盘能带给业务团队的真正价值。
相关文章
- AI内容营销怎么布局关键词:从语义拓词到Prompt喂料实操
- AI营销怎么提高客服响应速度:从意图分流到本地RAG搭建的实战落地方案
- AI营销适合什么行业?从ROI和落地场景拆解四类真正能跑通的赛道
- AI营销怎么复盘效果数据?从埋点清洗到ROI归因的全流程实操
- AI获客营销系统靠谱吗?拆解市面黑盒套路与低成本自建实操方案
- AI营销怎么搭配SEO使用:AI营销与SEO组合实战打法
- 外贸独立站智能AI客服机器人私有化部署:独立站AI客服私有化实战避坑
- 语义搜索与AI生成内容防K站策略:AI内容防K与语义搜索实操指南
- 基于AI的B2B外贸买家线索自动评分系统:外贸AI线索评分与文案避坑
- 多语言独立站AI翻译与本土化SEO优化:多语言出海SEO实操避坑指南