
AI批量处理PDF与Word文档:AI文档批量处理实战指南
在企业数字化转型与知识库建设的演进过程中,AI批量处理PDF与Word文档已成为打通非结构化数据资产壁垒的关键技术路径。传统的规则脚本或正则表达式面对版面错乱、扫描件混杂、复杂表格及非标排版的PDF和Word文档时,往往显得无能为力且极易崩溃。借助大语言模型(LLM)与多模态模型(VLM)的上下文理解、少样本学习和强容错推理能力,构建一套工业级、端到端的自动化批处理流水线,能够成百倍地提升企业在文档解析、数据提取、清洗转换及知识沉淀方面的运营效率。
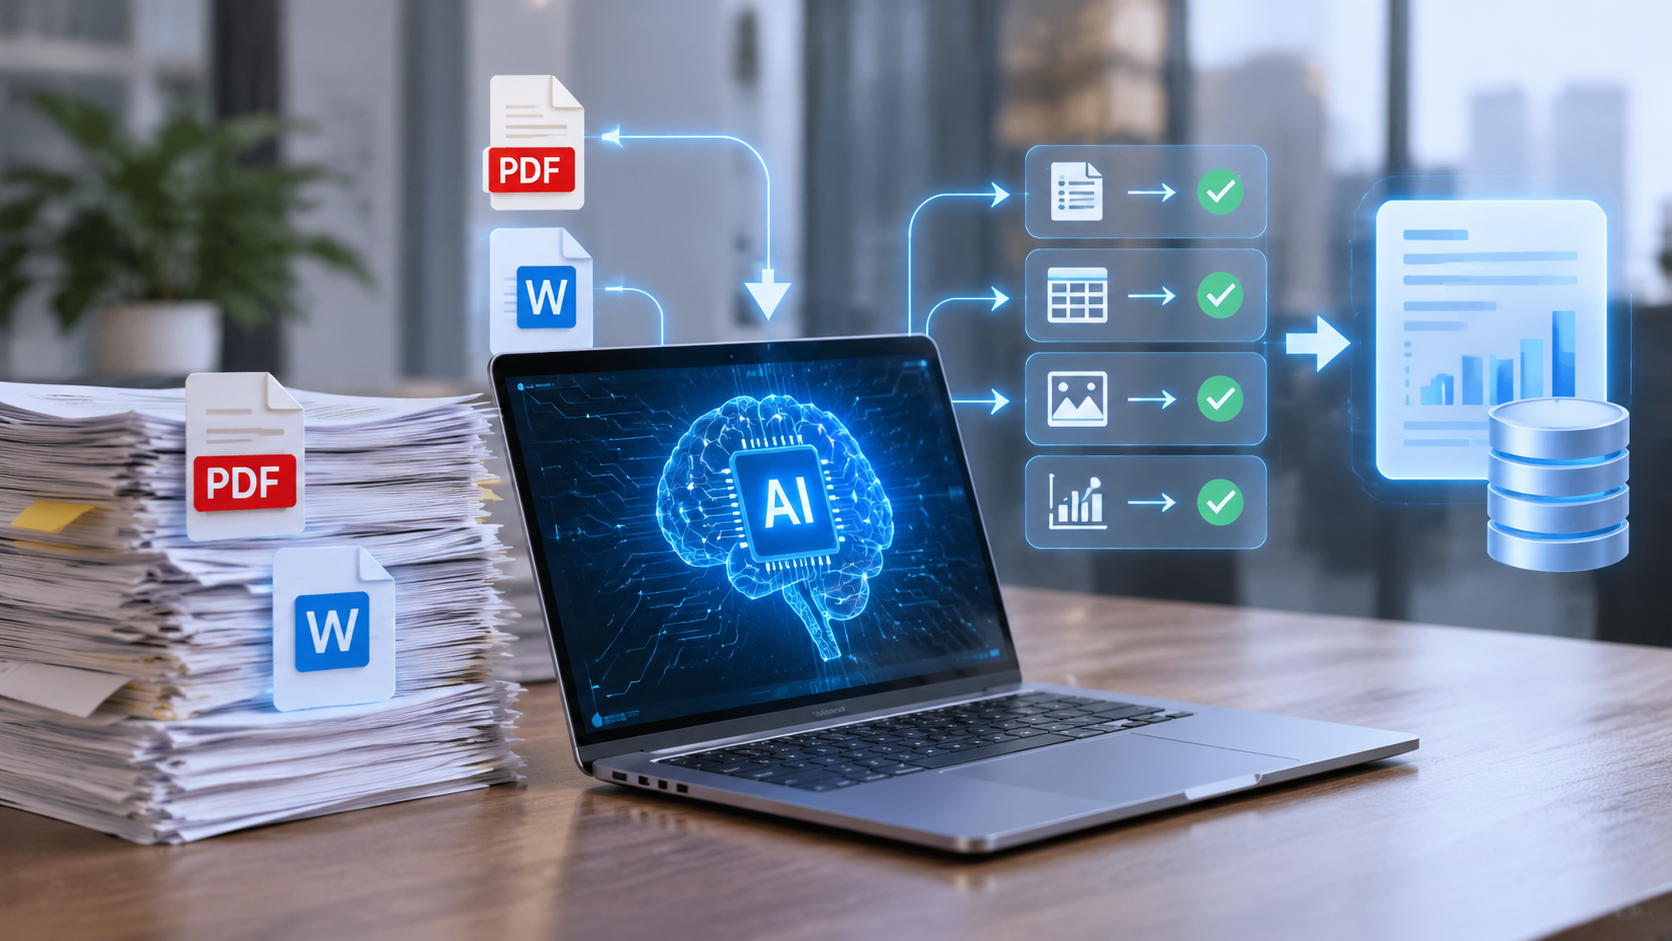
一、 核心痛点与AI处理架构演进
在进入实战方案前,必须明确PDF与Word(.docx)在底层结构上的异构性:
- Word(DOCX):本质是基于OpenXML压缩的结构化文本包,文本流连贯,但层级样式(如非原生标题、嵌套软回车)容易在程序提取时丢失逻辑关系。
- PDF:本质是基于绝对坐标的排版输出语言,不保留语义上的段落和表格逻辑,尤其是扫描件PDF,完全依赖光学字符识别(OCR)。
传统的处理方案通常依赖 PyPDF2、pdfplumber 或 python-docx 配合正则提取,维护成本极高且极易漏采。而现代AI驱动的批量处理架构通常分为四个标准分层:
- 接入与预处理层:文档队列调度、格式校验、PDF分流(文字版 vs 扫描版)。
- 多模态解析层:利用版面分析(Layout Analysis)算法将复杂版面转换为结构化Markdown或带有语义边界的文本块。
- LLM推理与提取层:通过结构化输出(Structured Outputs/JSON Schema)或多提示词链式调用,完成信息抽取、摘要或转写。
- 持久化与监控层:异步入库(PostgreSQL/Vector DB/Elasticsearch)、任务监控与重试机制。
二、 实操方案:构建高吞吐AI批处理流水线
要切实落地AI批处理,不能单纯依赖单次API调用,而需要设计一套兼顾准确率、成本与吞吐量的工程管线。
1. 深度解析:将非结构化排版语义化
对于批量处理,直接将PDF硬抽出的文本丢给LLM往往会导致表格乱序和Token浪费。建议采用两级解析策略:
- 对于纯文本/轻排版Docx与PDF:使用轻量开源库(如
Marker或MinerU)优先将其批量转化为保留表格语法(Markdown Table)的标准文本,大幅降低上下文混乱度。 - 对于复杂版面及扫描件:采用多模态模型(如 Qwen2-VL、GPT-4o-mini 或专项OCR大模型)进行“视觉切片识别”,直接将视觉坐标转变为层次分明的Markdown。
2. 批量推理:并发控制与结构化约束
LLM调用的瓶颈在于接口限流(RPM/TPM)和响应稳定性。在批量处理脚本中,必须配置异步高并发与强格式校验:
import asyncio
from pydantic import BaseModel, Field
from openai import AsyncOpenAI

# 1. 定义严格的提取数据结构(Schema)
class DocumentMetadata(BaseModel):
    title: str = Field(description="文档核心标题")
    publish_date: str = Field(description="发布时间,格式YYYY-MM-DD")
    core_summary: str = Field(description="200字以内的核心内容摘要")
    key_entities: list[str] = Field(description="文档提及的关键机构或产品")

# 2. 异步处理核心节点
async def process_document_with_ai(client: AsyncOpenAI, text_content: str, semaphore: asyncio.Semaphore):
    async with semaphore:  # 控制并发数量,防止触发限流
        try:
            response = await client.beta.chat.completions.parse(
                model="gpt-4o-mini",  # 推荐性价比极高的批处理模型
                messages=[
                    {"role": "system", "content": "你是一个专业的数据结构化引擎。请严格从输入文本中提取信息。"},
                    {"role": "user", "content": text_content}
                ],
                response_format=DocumentMetadata,
                temperature=0.1,  # 低温度保障确定性
            )
            return response.choices[0].message.parsed
        except Exception as e:
            # 运维打点:记录错误至ELK或Sentry
            return {"error": str(e)}
三、 运维级落地考量:吞吐、容错与成本控制
在实际运维千级乃至百万级PDF/Word的批处理任务时,工程落地的侧重点会迅速从“Prompt调优”转向“资源调度与成本控制”:
1. Token成本阶梯与模型分流
全量文档使用顶级模型处理在经济上不可行。最佳实践是分级推理路由(Model Routing):
- 初筛清洗:采用轻量级小参数模型(如 Llama-3-8B、Qwen-2.5-7B 部署在本地vLLM环境)完成垃圾文档过滤、基础分类与元数据提取。
- 精细解析:仅将高价值、高复杂度、涉及深层逻辑推理的文本段提交给商用前沿大模型。
2. TPM/RPM 平滑限流与指数退避
批量任务在瞬间拉起数十个Worker时,极易因触碰云端API阈值而产生 429 Too Many Requests。
- 必须在网关层引入 Token Bucket(令牌桶算法) 进行流量整形。
- 网络请求层强制配置 指数退避重试(Exponential Backoff with Jitter),避免重试雪崩击垮服务连接池。
3. 上下文截断与滑动窗口切片
面对数百页的超长PDF或技术手册Word,直接全量输入极易超过单次推理窗口或引发“针大海(Lost in the Middle)”效应。
- 按逻辑章节切分:利用正则或排版层级提取三级标题,按章节拆分为独立Task并行处理。
- Map-Reduce模式:先并行总结各章节输出局部JSON,再由汇聚节点执行“Reduce”操作,合成全篇结构化索引。
四、 价值衍生:对内容运营与SEO的深度赋能
高效的AI批量文档处理不仅是技术运维降本的工具,更是内容驱动型业务的生产力飞轮:
- 自动化构建海量长尾页面(Programmatic SEO):通过将海量存量研报、说明书、政策红头文件结构化提炼出关键问答(FAQ)、实体词条与参数对比表,可自动生成结构严密、满足Schema标记要求的聚合网页,极速获取长尾搜索流量。
- 私有RAG知识库质检:高质量的知识检索增强(RAG)高度依赖切片质量。利用AI流水线将版面繁杂的PDF/Word统一转化为语义清洗后的纯净Markdown,能直接消除表格错位带来的向量召回污染,使下游知识检索命中率获得质的飞跃。
总结
实现企业级AI批量处理PDF与Word文档,本质上是“多模态版面解析 + 异步并发调度 + 严格Schema推理约束”的系统工程。通过合理的架构分层,以低成本的小模型/解析引擎做预处理,结合大模型的语义推理和高可靠的运维重试保障,企业能够以极低边际成本激活静态文件资产,构筑起自动化、智能化的现代数据底座。
相关文章
- AI自动生成PPT工具实测:站长实测:AI做PPT别再踩坑了
- Coze接入飞书搭建业务Bot:Coze接飞书搭业务Bot实操
- AI批量提取扫描件PDF数据:AI提取扫描件PDF数据实操
- AI批量清洗去重客户名单:名单去重与站长文案实操指南
- Cursor辅助编写日常运维脚本:Cursor写运维脚本实操指南
- 开源AI录音转文字私有化部署:搞定本地语音转文字与站长写作
- AI一键生成业务流程思维导图:老站长教你用AI秒画业务流程图
- AI自动审查合同关键条款风险:老站长聊AI审合同的避坑实操
- Claude长文本快速提炼行业报告:老站长用Claude啃透行业报告
- AI办公数据泄露风险与防范:别乱用AI办公了,数据正在被看光