
AI批量处理PDF与Word文档:AI智能批量处理文档实操指南
在当今数字化办公与海量数据资产运营的背景下,AI批量处理PDF与Word文档已经从单纯的技术探索演变为了企事业单位提升内容生产力、优化运营成本的核心利器。传统的文档自动化处理往往依赖固定的规则引擎或正则表达式,面对排版混乱的Word文档或版面复杂、带有扫描图像的PDF时,经常出现解析崩溃、语义丢失和格式错乱等痛点。借助多模态大模型(LLM)与现代自动化脚本,我们能够跨越语义理解的鸿沟,实现从非结构化文档到高价值结构化数据的高效批量转换。
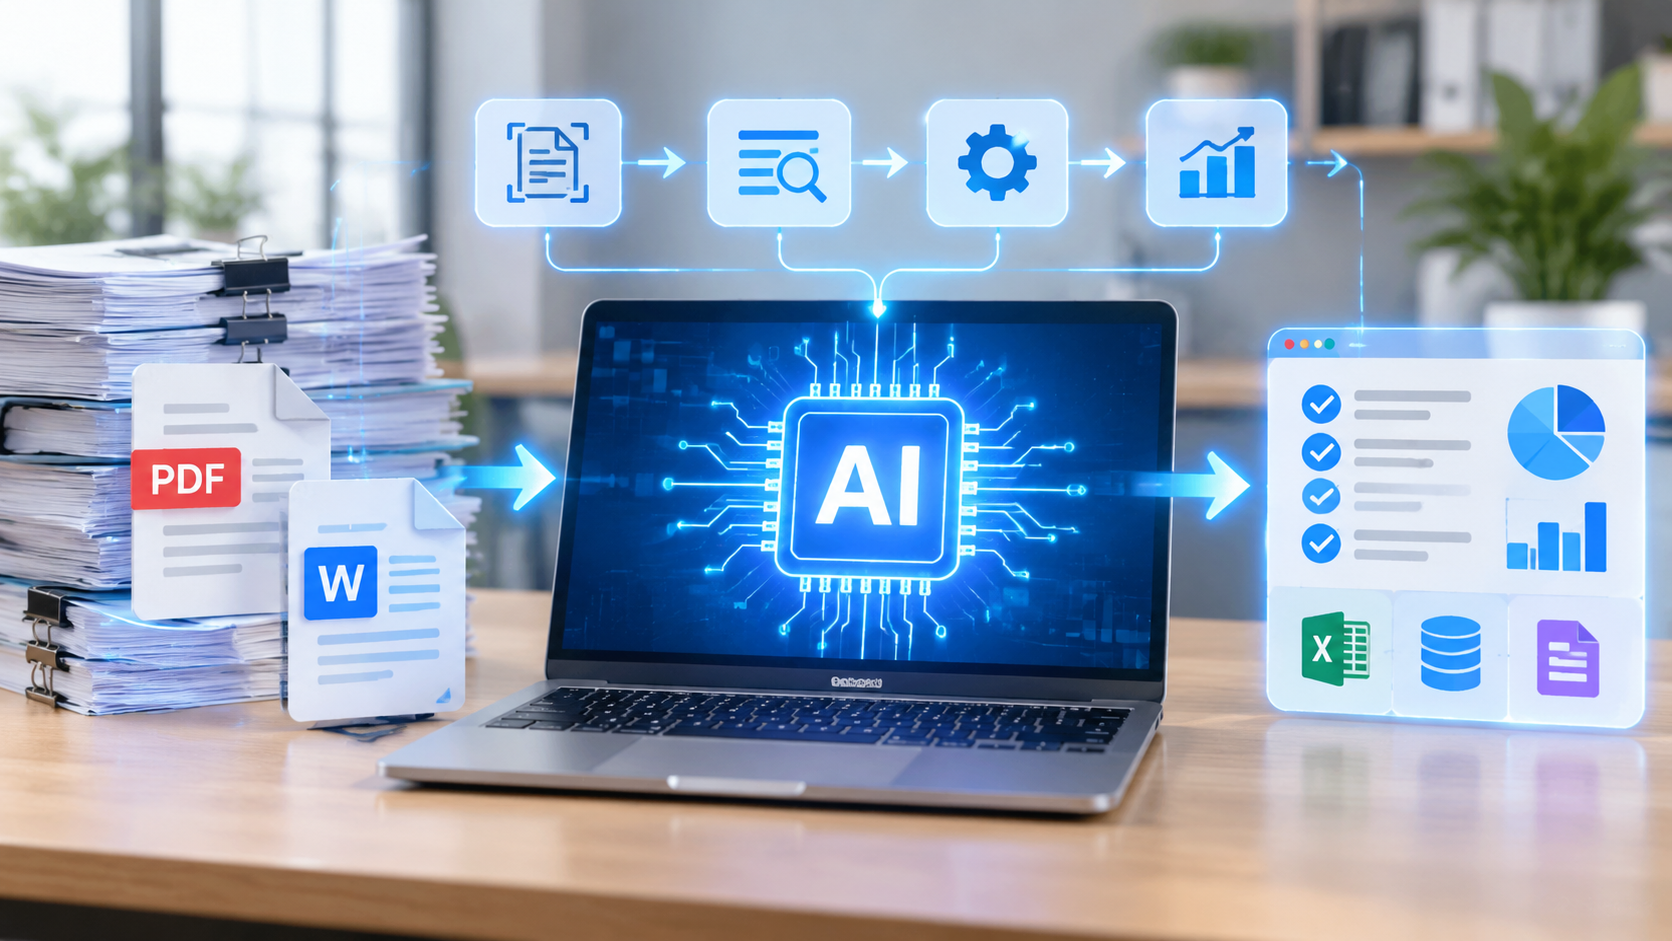
一、 为什么传统批处理无法取代AI方案?
在探讨具体落地手段前,我们需要理清传统脚本处理与AI批处理的本质差异:
- 版面解析能力的代差:传统工具(如纯文本提取库)遇到多栏排版、嵌套表格、页眉页脚干扰时,提取出的文本往往顺序混乱。AI视觉语言模型(VLM)与先进的版面分析(Layout Analysis)算法能够准确定位阅读顺序,还原逻辑段落。
- 非结构化内容的语义理解:传统程序无法判断“一段文字是否是合同的核心违约条款”或“一份研报的核心观点是什么”。AI可以通过自然语言指令(Prompting),在批量提取的同时完成清洗、摘要、分类、实体识别及翻译。
- 扫描件与复杂格式兼容:对于扫描版PDF,结合端到端OCR与大模型的纠错能力,AI能够大幅降低错字率,自动修复乱码与断句。
二、 AI批量处理PDF与Word的核心技术路线
针对不同的技术储备和业务场景,实现文档批量智能化处理主要有以下三条切实可行的路径:
方案 1:Python 脚本 + 大模型 API(灵活性最高的高并发方案)
这是技术运维与开发人员最推崇的自动化生产线模式,具有极高的定制性和吞吐量控制能力。
- 基础依赖:
- Word解析:
python-docx - PDF解析:
pdfplumber、pypdf或结合布局解析的MinerU/Marker - 异步并发:
asyncio、aiohttp
- Word解析:
- 处理逻辑:
- 批量加载与分块:扫描指定目录下的
.pdf和.docx文件,根据预设 Token 长度进行分块(Chunking),保留段落上下文。 - 并发调用:利用协程池控制并发请求数量,避免触发大模型服务商的限频(Rate Limit)。
- 结构化输出:使用 JSON Schema 或 Pydantic 强制模型输出结构化字段(如文档标题、核心标签、数据指标、摘要等)。
- 持久化存储:处理结果自动导入 MySQL、PostgreSQL 或导出为标准 Markdown/Excel。
- 批量加载与分块:扫描指定目录下的
# 示例:并发调用大模型提取核心信息的关键架构逻辑(伪代码)
import asyncio
from pathlib import Path
import docx

async def process_document(file_path, semaphore, client):
    async with semaphore:
        # 1. 本地提取文本
        doc = docx.Document(file_path)
        full_text = "\n".join([p.text for p in doc.paragraphs if p.text])

        # 2. 构造标准化Prompt并调用API
        prompt = f"请提取以下文档的核心摘要与三个SEO关键词,输出JSON格式:\n{full_text[:3000]}"
        response = await client.chat.completions.create(
            model="gpt-4o-mini", # 或 deepseek-chat 等高性价比模型
            messages=[{"role": "user", "content": prompt}],
            response_format={"type": "json_object"}
        )
        return {"file": file_path.name, "result": response.choices[0].message.content}
方案 2:开源工作流平台编排(低代码可视化落地)
对于希望快速验证效果、减少代码维护成本的团队,基于 Dify 或 FastGPT 搭建工作流是最佳选择。
- 实现方法:
- 使用平台的“文档批处理”或“知识库批量导入”节点。
- 节点链路设计:
文件上传->文本预处理/清洗->LLM信息抽取/重写->Webhook回传业务系统。 - 这种方式运维成本极低,天然具备鉴权、日志追踪与调用监控能力。
方案 3:本地私有化多模态模型(面向数据敏感与内网合规)
若文档涉及商业机密、内部财报或个人隐私,不能接入公网 API:
- 技术栈:采用 Ollama 或 vLLM 本地部署开源模型(如 Qwen2.5-7B-Instruct 或 Qwen2-VL)。
- 配套工具:结合本地 OCR 引擎(如 PaddleOCR)提取复杂版面,由本地推理服务批量生成处理结果,确保数据物理隔绝。
三、 工程化实战中的运维与性能调优
在实施大规模(成千上万份)批处理任务时,系统稳定性和成本控制是运维工程师必须面对的挑战:
1. Token 成本与上下文优化
盲目将数十页的 PDF 原文全部投喂给大模型会带来昂贵的账单和模型幻觉。实战中应采用两级过滤法:
- 先通过 Python 规则过滤无用声明、目录、页脚;
- 对于固定模板合同或报表,仅通过坐标或正则定位目标页,只把核心页面转化为文本送入模型,Token 消耗可降低 70% 以上。
2. 异常重试与断点续传设计
批量任务耗时较长,中途可能因网络抖动、Token 超限或个别文件损坏导致中断。
- 运维脚本中必须引入 SQLite / Redis 状态锁,记录每个文件的
MD5和处理状态(pending,success,failed)。 - 对 HTTP 429(Too Many Requests)和 5xx 错误实施指数退避重试(Exponential Backoff)策略。
3. Prompt 的鲁棒性控制
批量处理中,最怕模型“偶尔发散”。在 Prompt 中应明确约束:
- 禁止客套话,直接输出结果;
- 遇到无法解析的内容返回固定的空值标识符(如
{"status": "null"}); - 尽可能利用模型原生的结构化输出特性(如 OpenAI 的 Structured Outputs 或 DeepSeek 的严格 JSON 模式)。
四、 商业与SEO场景延伸:从文档到流量资产
从网站 SEO 和数字内容资产管理的角度来看,批量处理并非终点,而是数据赋能的起点:
- SEO内容矩阵生成:利用 AI 批量解析行业技术白皮书(PDF),自动提炼出长尾痛点、解决方案并改写为符合搜索引擎抓取规范的 FAQ 聚合页面,快速构建高权重的垂直内容专题。
- 结构化内链构建:批量处理 Word 稿件库时,AI 可以自动扫描文章中的核心实体名词,自动建立上下文维度的双向锚文本链接,提升整站的爬虫抓取效率与权重传递。
- 企业知识库冷启动:将原本沉睡在文件服务器中的杂乱 PDF 与 Word,批量清洗为统一格式的 Markdown 知识切片,为后续搭建 RAG(检索增强生成)智能客服提供优质的数据底座。
五、 总结
AI 技术的融入彻底重塑了非结构化文档的批处理流水线。通过将 Python 现代自动化工具的“工程确定性”与大语言模型的“语义理解力”相结合,企业能够低成本、高并发地攻克 PDF 与 Word 批量处理中的版面错乱、解析繁琐等历史难题。理清业务场景、设计健壮的并发容错架构,并制定精准的 Prompt 规范,便能在极短时间内将海量杂乱的文档转化为结构清晰、价值明确的高质量数字资产。
相关文章
- AI自动生成PPT工具实测:站长实测:AI做PPT别再踩坑了
- Coze接入飞书搭建业务Bot:Coze接飞书搭业务Bot实操
- AI批量提取扫描件PDF数据:AI提取扫描件PDF数据实操
- AI批量清洗去重客户名单:名单去重与站长文案实操指南
- Cursor辅助编写日常运维脚本:Cursor写运维脚本实操指南
- 开源AI录音转文字私有化部署:搞定本地语音转文字与站长写作
- AI一键生成业务流程思维导图:老站长教你用AI秒画业务流程图
- AI自动审查合同关键条款风险:老站长聊AI审合同的避坑实操
- Claude长文本快速提炼行业报告:老站长用Claude啃透行业报告
- AI办公数据泄露风险与防范:别乱用AI办公了,数据正在被看光