
AI办公生成内容版权归属争议:用AI写材料,版权到底算谁的?
大清早打开电脑,把需求扔给ChatGPT或者WPS AI,几秒钟搞出一篇周报、PPT大纲或者代码片段,这已经成了很多人每天的基操。但不知道你有没有想过,敲回车的那一瞬间,这篇材料的著作权到底归了谁?是敲键盘的你、给你发工资的老板,还是大模型背后的开发商?近两年来,随着各大企业全面推进数字化转型,AI办公生成内容版权归属争议已经从法学界的纯理论推演,变成了悬在每个打工人、内容创作者和企业主头顶的“达摩克利斯之剑”。
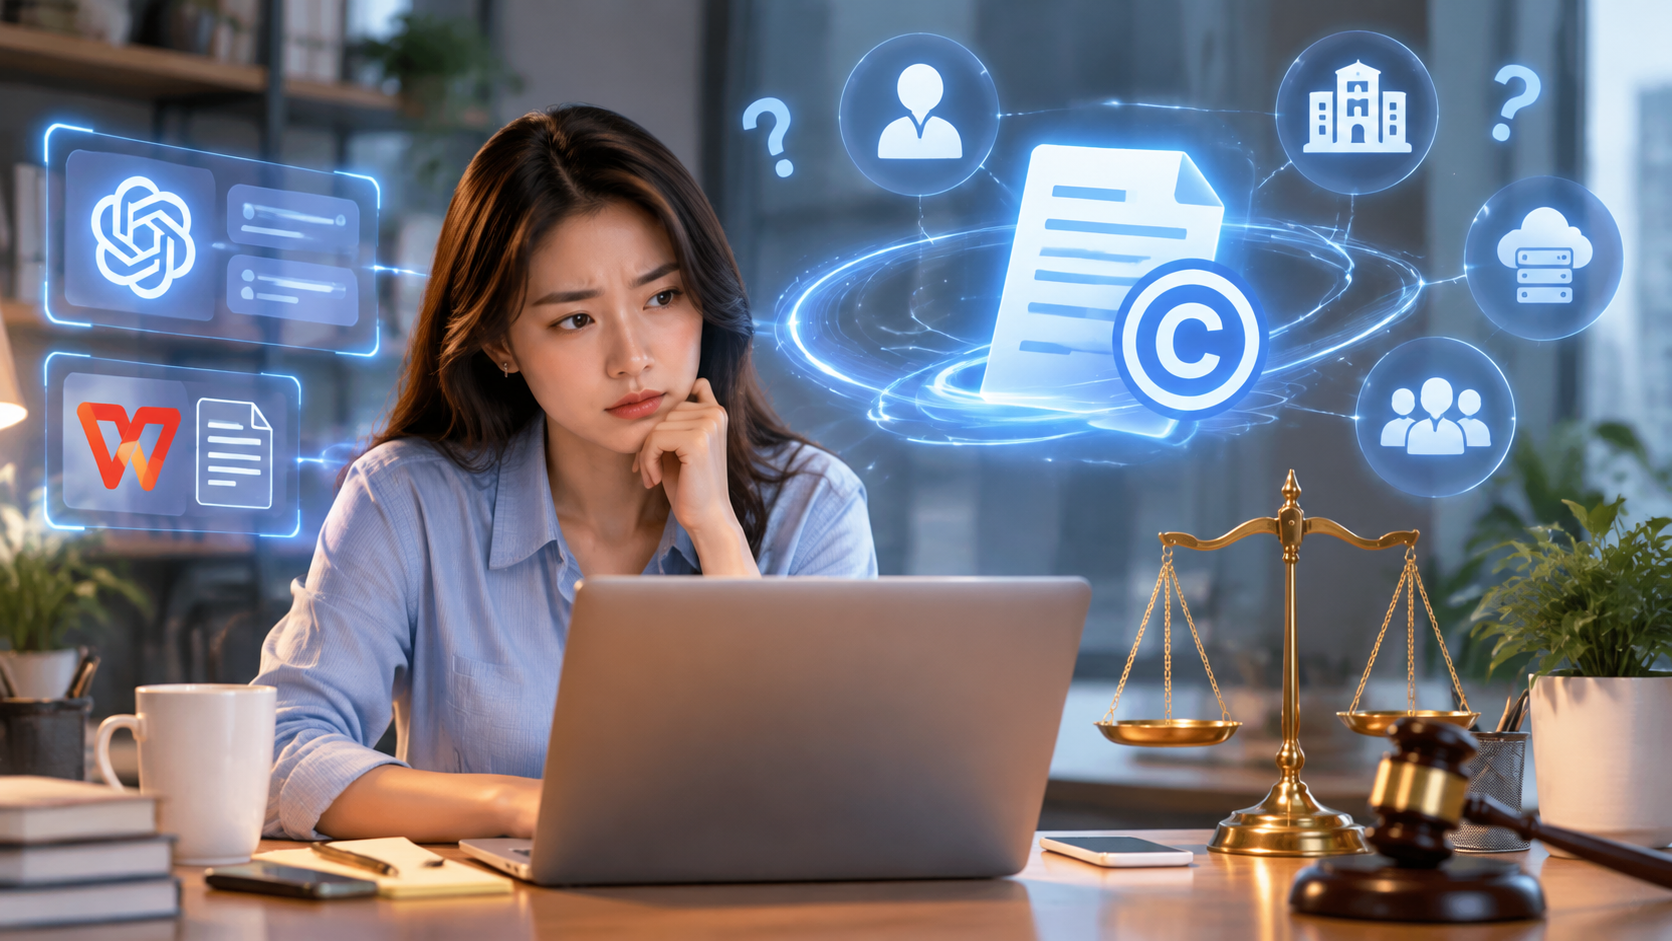
老实说,很多人现在还在“盲开”。大家用得风生水起,却很少有人翻开过软件底部的用户协议,更没人预料到一旦涉及商业诉讼,谁该来背这个侵权的黑锅。
一张图看懂:版权到底在争什么?
要搞明白这里面的纠葛,我们得先把水搅浑的几方势力摆上台面。在典型的办公场景里,内容往往经过了多道手:
- 一线员工(指令输入者): “我花了半小时调教Prompt,改了八次参数,没有我这脑力,AI吐得出来这东西吗?我是作者!”
- 企业老板(生产资料提供者): “你拿我的薪水,用公司买的企业级账号,在上班时间搞出来的东西,妥妥的‘职务作品’,版权必须归公司。”
- 模型提供商(平台方): “底层代码是我的,海量数据是我喂的,服务器是我烧电跑的,软件协议里写得明明白白……”
- 原作者群体(数据来源者): “AI生成的段落里明明有我的文风,甚至直接洗了我的观点,这是未经授权的‘数据缝合怪’。”
各执一词,谁听着都有道理。那么,目前的司法实践到底站在哪一边?
法院现在怎么判?别猜了,看判例
抛开法律条文的生硬背诵,我们看两个目前行业里最具风向标意义的事件:
1. 北京互联网法院的“AI文生图”第一案
这是国内SEO和内容圈必须了解的一个案子。原告用开源模型生成了一张美女图片发在小红书,被告未经许可直接盗用。法院最终判定:原告享有涉案图片的著作权。 为什么?法官的逻辑非常务实:原告不是简单敲个词,而是输入了几十个提示词,设置了正向反向参数,调整了画面布局与光影,体现了“人类的智力投入与个性化表达”。
2. 美国版权局的冷水(USCO)
大洋彼岸的画风完全不同。美国版权局在审查AI绘本《黎明的扎里亚》时明确表态:文字故事归作者,但AI生成的配图不能登记版权。他们的核心逻辑更死板:版权只保护人类的创作,由算法黑盒随机生成的像素,不受法律保护。
核心结论: 目前的争议焦点不在于“AI是不是作者”(法律基本一致认为AI不是人,没资格拿版权),而在于“人类在这个过程中到底干了多少活”。
拒绝当韭菜:企业与个人的实操避坑指南
如果你是做网站运营、技术运维或者文案SEO的,每天要产出海量文字,怎么在享受AI效率的同时,彻底掐死版权争议的隐患?落到实处,就三句话:
第一步:留痕!把Prompt当成“草稿纸”存下来
很多人用完AI随手一关窗口,这是大忌。如果这篇内容未来有极高的商业价值(比如核心产品说明书、SEO高权重引流文章、企业白皮书):
- 保留完整的对话链: 证明你是如何通过一层层限制条件、逻辑引导让AI吐出内容的。
- 这是对抗“机械生成论”的最硬证据,能证明内容里包含你个人的“独创性意志”。
第二步:坚守“三七原则”,切忌无脑复制粘贴
搜索引擎现在打击纯AI垃圾内容(Spam)越来越狠,法律也不保护纯粹的机械产物。
- AI占七成,人必须改三成。
- 把AI生成的文本作为骨架,人工往里面填入企业的真实业务数据、第一视角的实战经验、行业行话。一旦融入了不可替代的人工经验,版权属性瞬间夯实,SEO排名表现也会远超纯AI生成的流水账。
第三步:看清楚你买的SaaS协议
大部分打工人根本不看“用户协议”。注意两个雷区:
- 免费版工具: 很多免费AI工具在协议里埋了坑,写着“用户使用本服务生成的内容,平台拥有全球范围内的免费使用权甚至共有权”。拿这个写商业方案,等于主动泄密和让渡权益。
- 企业采购合同: 运维和采购部门在引入AI办公套件时,合同里必须强制增加一条:“服务商放弃对用户输入数据及输出成果的任何知识产权主张,且保证输出内容不侵犯第三方权益。”
| 办公场景 | 推荐操作模式 | 版权归属风险 |
|---|---|---|
| 纯AI生成的周报/备忘录 | 直接内部流转,不公开发布 | 极低(内部使用不纠结版权) |
| SEO外链/博客引流文 | AI拟大纲 + 人工精修替换案例 | 低(符合搜索引擎E-E-A-T原则) |
| 商业软件核心代码/设计图 | 商业私有化部署模型 + 严格Prompt存档 | 中(需警惕数据外泄及开源代码污染) |
| 直接搬运AI内容做电子书售卖 | 严禁直接商用 | 极高(随时可能被认定为公共领域内容) |
说句掏心窝子的话
AI本质上就是一把更快的铲子。你不能因为铁锹是工厂造的,就说你挖出来的金矿属于铁锹厂;但如果你只是站在矿坑旁边扔了把铁锹,任由它自己往下掉,你也很难理直气壮地说这坑是你挖的。
在AI办公生成内容版权归属争议尘埃落定之前,最聪明的做法永远不是站在原地等一部完美的法律出台,而是把AI当秘书,把自己当主编。机器负责提供搬砖的力气,你负责注入思想的灵魂——只要文章的“魂”还是你的,任凭风浪怎么翻,版权的底气就始终攥在你自己的手里。
相关文章
- AI自动生成PPT工具实测:站长实测:AI做PPT别再踩坑了
- Coze接入飞书搭建业务Bot:Coze接飞书搭业务Bot实操
- AI批量提取扫描件PDF数据:AI提取扫描件PDF数据实操
- AI批量清洗去重客户名单:名单去重与站长文案实操指南
- Cursor辅助编写日常运维脚本:Cursor写运维脚本实操指南
- 开源AI录音转文字私有化部署:搞定本地语音转文字与站长写作
- AI一键生成业务流程思维导图:老站长教你用AI秒画业务流程图
- AI自动审查合同关键条款风险:老站长聊AI审合同的避坑实操
- Claude长文本快速提炼行业报告:老站长用Claude啃透行业报告
- AI办公数据泄露风险与防范:别乱用AI办公了,数据正在被看光