
利用服务器日志分析Google蜘蛛抓取行为:挖日志看懂Google蜘蛛抓取套路
很多做SEO的朋友每天盯死在Google Search Console(GSC)的后台,看覆盖率报告、看抓取统计,但老实说,GSC给你的数据不仅有2-3天的延迟,还是被严重抽样过的。如果你的网站有几万甚至几百万页面,遇到收录慢、排名突然下滑或者服务器变卡,光看GSC根本查不出根因。在这个时候,利用服务器日志分析Google蜘蛛抓取行为才是真正能帮我们还原现场、解决技术SEO痛点的硬核手段。
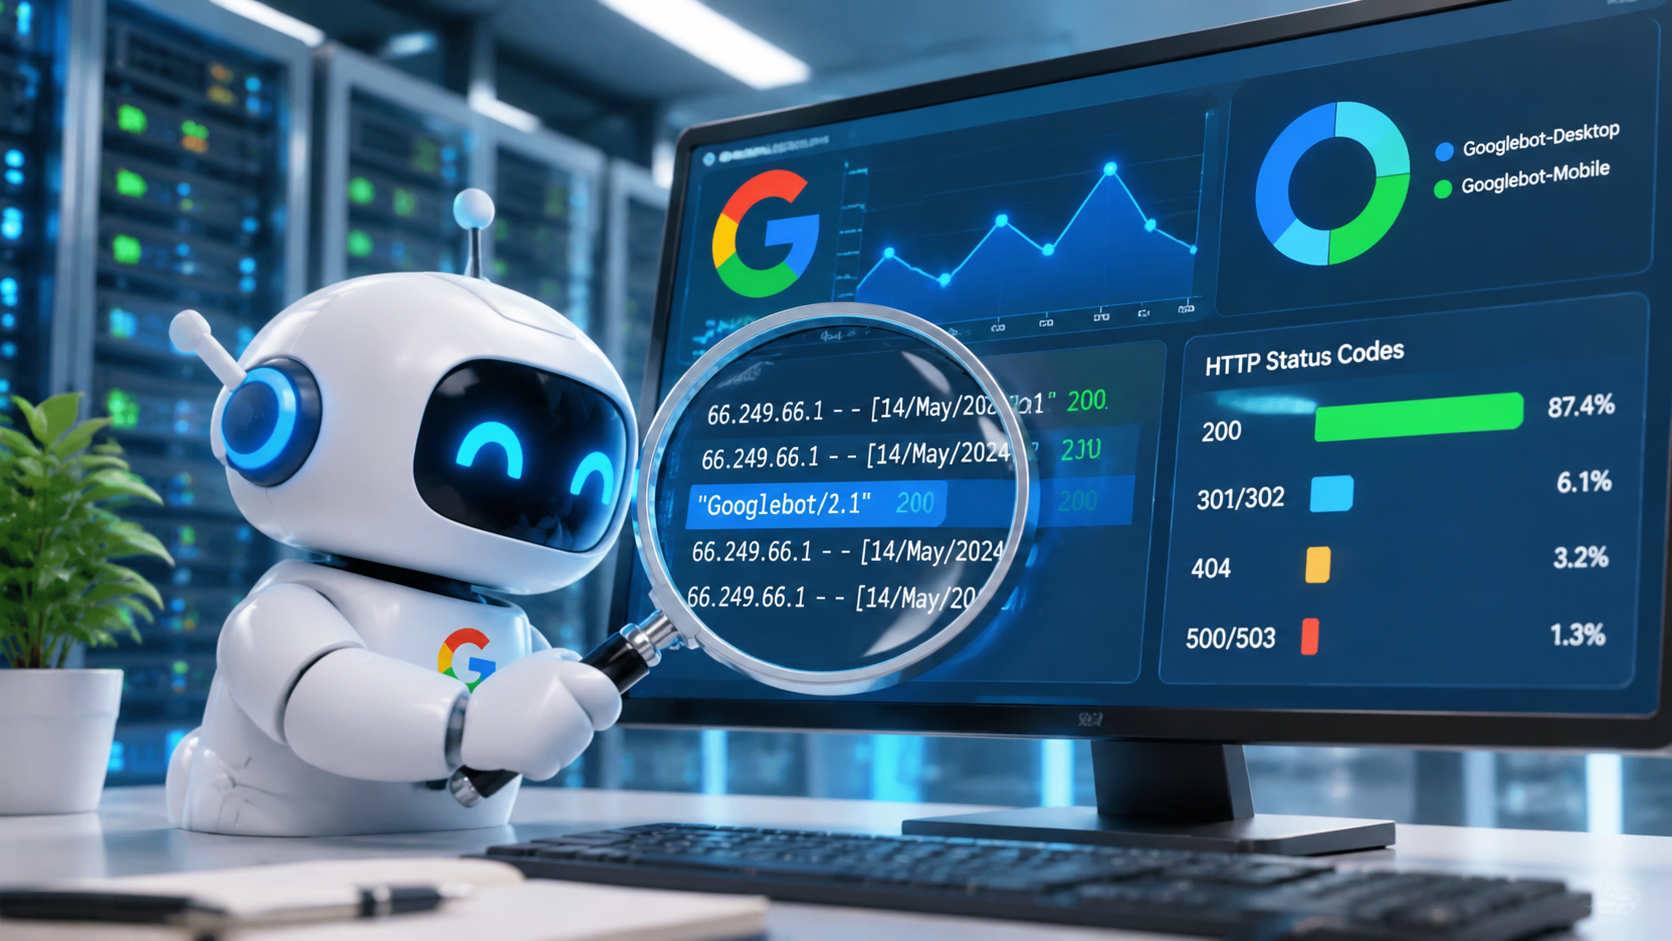
服务器日志(Access Log)是服务器对每一次访问留下的“黑匣子记录”。Googlebot什么时候来过、抓了哪个页面、耗费了多长时间、服务器给了什么反馈,清清楚楚。下面我结合平时的运维和SEO实操经验,教大家怎么把这份枯燥的文件变成直接拉升排名的抓手。
一、 第一步:别被“假蜘蛛”给骗了
看日志前,必须先洗掉伪造Googlebot的垃圾爬虫。现在很多黑产或竞争对手会伪装成Googlebot的User-Agent来抓取内容。
正常的Googlebot日志大致长这样:
66.249.66.1 - - [14/May/2024:10:15:20 +0800] "GET /seo-guide/ HTTP/1.1" 200 15243 "-" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"怎么验证真伪? 不能单靠User-Agent,必须靠反向DNS解析(rDNS)。 在Linux终端里,直接用命令行验证IP:
# 1. 反查域名(必须指向 googlebot.com 或 google.com)
host 66.249.66.1
# 输出:1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.

# 2. 再正查回去确认
host crawl-66-249-66-1.googlebot.com
# 输出必须包含原本的IP:66.249.66.1
把那些伪造的爬虫IP直接在Nginx或防火墙拉黑,省下服务器算力给真正的Googlebot。
二、 核心分析维度:看懂Googlebot的行为逻辑
清洗完数据后,我们要重点提取以下几个核心维度进行交叉分析:
1. 状态码分布(Status Codes)
这是最直接的健康度指标。可以用一段简单的Shell命令直接拉出Google蜘蛛的状态码占比:
grep "Googlebot" access.log | awk '{print $9}' | sort | uniq -c | sort -rn- 200 正常比例需在 85% 以上:如果连正常的200都不高,说明站点架构有问题。
- 301/302 重定向:如果爬虫大量访问到重定向链接,说明站内内部链接结构没更新,在疯狂浪费爬虫预算(Crawl Budget)。
- 404 错误:看是死链还是被猜解的路径。如果是旧页面改版没做301,必须尽快补上。
- 500/503 报警:一旦5xx错误暴增,Google会立刻降低抓取频率,这通常意味着后端PHP-FPM被打满、数据库死锁或网关超时。
2. 蜘蛛类型分布:桌面端 vs 移动端
现在Google全面转向“移动优先索引”(Mobile-First Indexing)。 如果在日志里过滤User-Agent,发现Googlebot-Desktop的抓取量还远大于Googlebot-Mobile(正常比例应该是移动端占 70%~90% 以上),说明站点在移动适配、视口声明或者结构上可能存在严重缺陷,导致Google判定网站不适合移动端渲染。
3. 抓取深度与低价值页面(爬虫陷阱)
爬虫的资源是有限的。很多电商或分类信息网站收录差,并不是权重低,而是爬虫被“卡住”了。
- 参数URL(URL Parameters):像
?sort=price&color=red&page=3这种组合筛选,会不会形成无限循环? - 站内搜索结果页:如果开放了站内搜索抓取,日志里会充斥着巨量的垃圾搜索页抓取记录。
- 无用资源文件:CSS、JS按理说应该抓,但如果带随机哈希参数每次都重新抓,就是在空耗配额。
三、 常见实战场景与排查套路
为了更直观地说明问题,我把日常运维中利用日志诊断出的SEO典型问题整理成了一张对照表:
| 日志表象 | SEO潜在危机 | 运维与SEO协同解决方案 |
|---|---|---|
| 大量的 304 Not Modified 响应 | 良好现象,节省带宽与抓取资源 | 维持现状,确保 Last-Modified / ETag 机制健康 |
| JS/CSS 文件返回大量 403 或 404 | Google渲染不完整,导致页面被判白屏或降权 | 检查 robots.txt,严禁屏蔽静态资源路径 |
| 蜘蛛频繁抓取,但新文章持续不收录 | 蜘蛛配额全被低质量老页面/死链耗尽 | 提交XML地图,用日志查看Googlebot是否按照地图URL路径抓取 |
| 抓取同一页面的响应时间(Time Taken)逐渐变大 | 页面加载慢,爬虫主动减少访问深度与频次 | 开启服务端页面静态化缓存,优化慢SQL查询 |
实操技巧:揪出耗尽爬虫预算的“罪魁祸首”
你可以通过下面的命令,按抓取次数排序,看看被Google抓得最多的前20个URL到底是什么:
grep "Googlebot" access.log | awk '{print $7}' | sort | uniq -c | sort -nr | head -20很多站长跑完这行命令才发现:被抓得最多的不是首页,不是核心文章,而是一个由于开发失误导致无限跳转的分页URL。这就是日志不会骗人的地方。
四、 搭建长效的日志监控流
不要等出事了才翻日志。建议根据团队的技术栈搭建轻量级或可视化的监控体系:
- 轻量级监控(推荐中小站): 直接部署 GoAccess。这是一个开源的实时Web日志分析器,支持在终端里以图表方式查看,也可以直接输出HTML面板。你可以快速过滤出Googlebot的独立IP、访问量、带宽消耗和状态码。
- 企业级追踪(推荐大型站点/商城): 使用 Filebeat + Logstash + Elasticsearch + Kibana (ELK栈) 或者 Loki + Grafana。将Nginx日志打成JSON格式入库,把Googlebot作为专属标签,做一个实时的SEO看板:监控每天Googlebot请求数、抓取字节数、平均响应延时。
总结
做好现代SEO早已不是单纯堆砌词汇和外链的时代了。底层的抓取通路不畅,上层的内容策略就是空中楼阁。定期利用服务器日志分析Google蜘蛛抓取行为,能让你比竞争对手更早发现网站的死链、无限陷阱和性能瓶颈,用最硬核的数据反哺SEO优化策略,让每一分抓取配额都切实转化成搜索排名的动力。
相关文章
- 独立站内容营销SOP与原创度把控:独立站内容营销SOP:原创流量的底层逻辑
- 谷歌图片搜索SEO流量获取实战:别盯着文字卷了,图搜流量才是独立站的隐形金矿
- 独立站SEO效果监控与数据看板搭建:别被虚荣指标骗了:手把手教你搭独立站SEO实战看板
- Google核心网页指标Core Web Vitals实操优化:老站长带你死磕CWV性能优化
- 外贸独立站Hreflang多语言标签防踩坑配置:独立站Hreflang避坑实操指南
- WordPress搭配Nginx极致优化TTFB实操:压榨Nginx:WP秒开TTFB实战
- Google Search Console索引报错深度排查与修复:GSC索引报错深度排查实操指南
- 海外Guest Post外链开发与辨别黑心资源:老站长谈GP外链避坑与实操
- Ahrefs挖掘低竞争高转化商业意图长尾词:老站长用Ahrefs捡漏商业词实录
- 谷歌算法更新后流量断崖式下跌恢复指南:谷歌核心算法暴跌自救指南