
批量语义去重与TF-IDF长尾词优化:别瞎堆词了,教你怎么洗出流量
这几年做外贸站或者跑英文联盟站的老铁,日子估计都不太好过。自从OpenAI把API放开后,市面上冒出一堆所谓的“全自动AI建站工具”,一帮人疯狂生成几千几万篇烂大街的口水文,结果去年到今年几波Google核心算法大更新下来,站群成片成片被K,流量断崖式跳水。
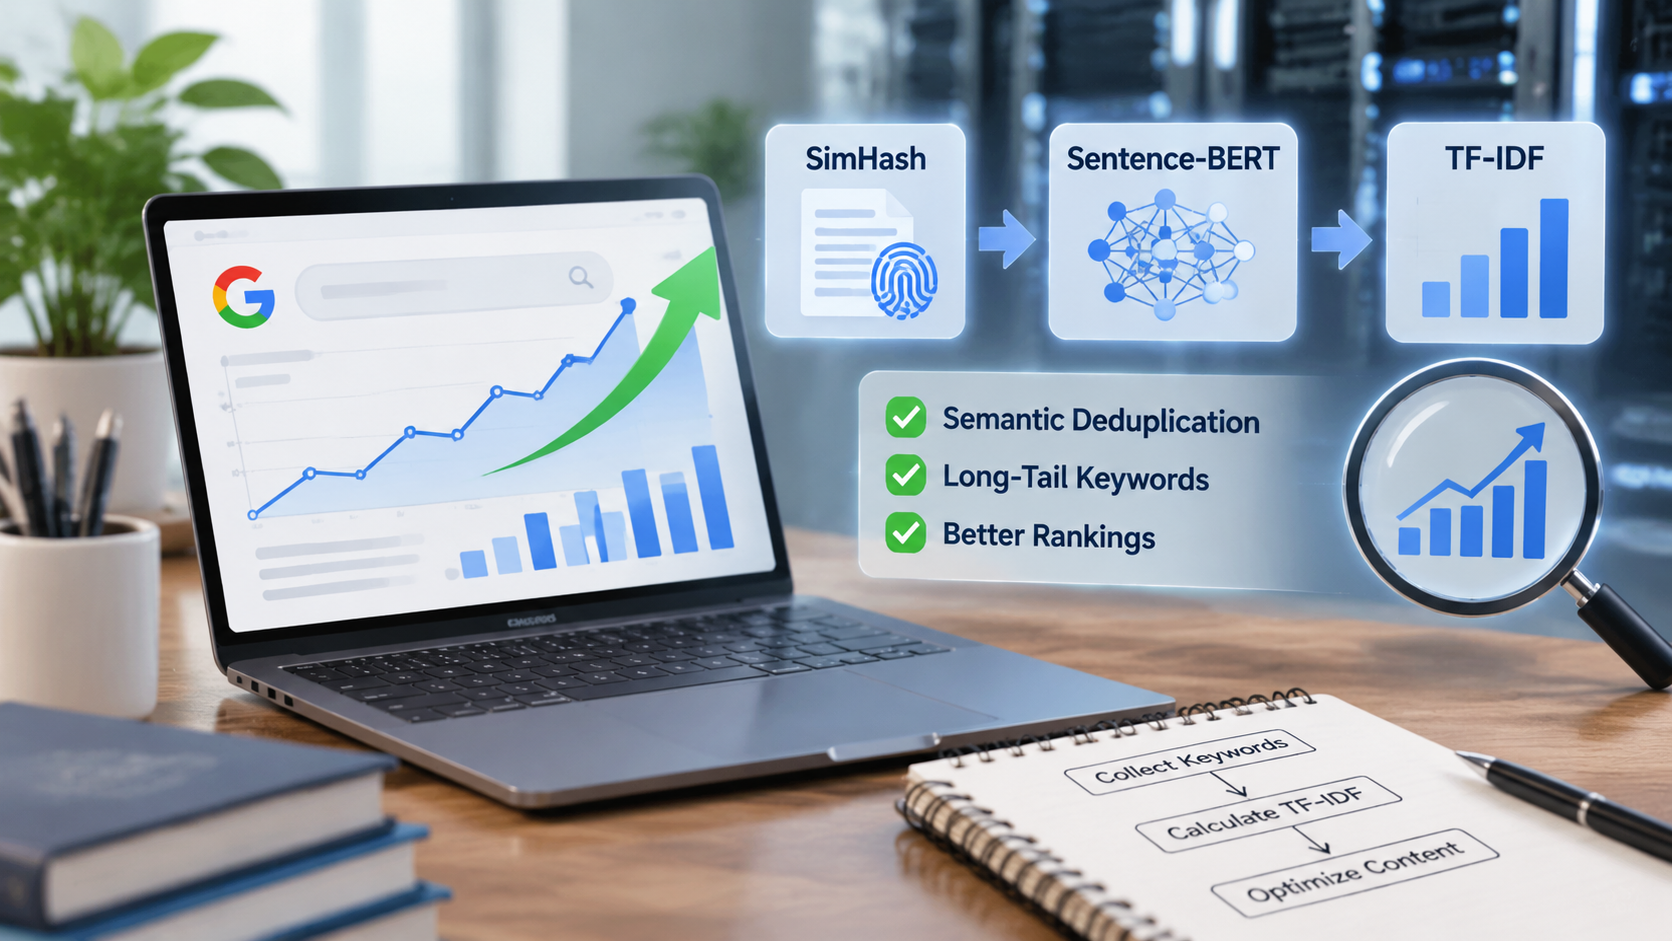
说白了,搜索引擎现在精得很,纯粹的词语替换根本蒙不过去。你如果真想靠量取胜,又不想刚建完就被Google直接打入冷宫,批量语义去重与TF-IDF长尾词优化就是你必须搞明白的两套底层基本功。
今天不跟你们扯什么高深的信息检索算法,就拿我跑在Ubuntu上的几个站群实例,聊聊这套方案到底怎么跑通。
别再用同义词替换了,那是十年前的把戏
很多站长以为的“洗稿去重”,无非是找个Spin工具,把“buy”换成“purchase”,把“cheap”换成“low-cost”。这种低级玩意儿早在Panda算法时代就被打入垃圾堆了。
现在要做的批量语义去重,核心目的不是避开查重软件,而是让搜索引擎的爬虫认为:你这批页面虽然讲的是同一个行业话题,但每个页面都有独立的增量信息,没有互相蚕食(Cannibalization)权重。
在实操中,我一般直接在Linux VPS上写个Python脚本批处理,流程其实就两步:
1. 用SimHash做粗筛,砍掉骨架重复的页面
如果你的站每天要抓取或生成几百上千篇文章,千万别一上来就跑大模型做全量对比,几千篇跑完你服务器内存早就被挤爆OOM(Out of memory)了。
- 先用轻量级的 SimHash 或者 MinHash,提取每篇文章的指纹(64位整型)。
- 计算海明距离(Hamming Distance),只要距离小于3的,直接视为孪生内容,脚本自动丢弃或者合并,不需要进入下一步。
- 这一步在CentOS或者Debian环境里,几万篇文章跑完不过几秒钟的事。
2. 向量嵌入(Sentence-BERT)做精筛
粗筛过掉后,剩下的文章很可能骨架不同,但核心语义严重重合(比如三篇文章换着花样都在说“外贸货代哪家好”)。
- 本地拉一个最轻量的MiniLM模型(比如
all-MiniLM-L6-v2,CPU就能跑,不占显存)。 - 计算段落之间的余弦相似度(Cosine Similarity)。
- 硬指标:一旦发现全篇整体语义相似度超过85%,脚本直接触发重构机制——强行打乱行文逻辑,引入差异化的案例或FAQ板块,直到相似度降到70%以下才允许入库上站。
TF-IDF长尾词优化:别去碰竞争大的大词
搞定了去重,接下来就是抢排名。搞外贸站最忌讳的就是眼高手低,天天盯着“wholesale shoes”这种大词,你权重拼得过Amazon和行业巨头吗?拼不过的。
真正能给新站带来精准询盘或者出单的,全是那些3到5个单词组成的具体需求长尾词。这时候,TF-IDF(词频-逆文档频率) 就是最好的杠杆。
很多人看公式头大,我直接说人话:
- TF(词频):某个长尾词在你的这篇特定文章里出现了几次?(是不是真的重点)
- IDF(逆文档频率):这个词是不是在全网、在你的全站其他文章里都烂大街了?(是不是独特的信息增量)
如果一个词在全站到处都是(比如“quality”、“supplier”),它的权重就会被无限压低;而如果某个词只在这篇文章里高频出现(比如“IP68 waterproof industrial switch manual”),它就会被算法认定为这篇文章的核心特征。
具体怎么落地埋词?
做实操时,别去相信那些动辄几百美金一个月的SEO SaaS工具给出的“智能建议”,很多都是胡乱塞词。我自己的工作流通常是这样的:
[GSC/Ahrefs 导出未排名的长尾词库]
                  │
                  ▼
[Python脚本计算页面文本与长尾词的TF-IDF得分]
                  │
                  ▼
[剔除停用词与同质词,锁定前5个核心高分词]
                  │
                  ▼
[自动化/人工精准植入核心展示位]- 打乱密度,重在位置:别再去信什么“关键词密度必须达到2%~3%”的鬼话。Google早就引入BERT和RankBrain了。长尾词最好的安放位置是:URL slug(别太长)、H2小标题、正文第一段前80个词,以及文章最后的FAQ模块。
- LSI词簇配合:如果你的长尾词是“custom CNC machining tolerance”,计算TF-IDF时,必须强制关联出现“microns”、“precision inspection”、“CMM”这类工程语义相关的强特征词,这会让算法直接判定你的文章专业度极高,而不是纯外行水文。
运维角度的避坑警告
最后以一个老运维的身份提醒大家几点,都是用真金白银买来的教训:
- 别在生产环境跑重度NLP任务:批量做语义去重和TF-IDF计算时,绝对不要在挂着外贸前台网站的同一台机器上高并发跑。特别是配了MySQL和Nginx的生产机,一旦脚本死循环占用100% CPU,外贸客户访问超时,你哭都来不及。最好在本地电脑跑好,清洗完通过REST API或者直接导入数据库。
- 警惕过度优化带来的惩罚:TF-IDF算法算出来的高权重词,千万别生硬地全部堆进一段里。现在的爬虫对“Unnatural phrasing”(非自然表达)极度敏感。如果一句话为了凑长尾词读起来像中式英语,宁可删掉。
- 动态监控GSC的展现量:页面洗完、词埋好上线后,盯紧Google Search Console。如果上线两周内,某个批次的页面连Impression(展现量)都没有,说明去重力度不够,直接被判定为薄弱内容(Thin Content)扔进补充索引了,必须立马回滚或者重新调大语义去重的阈值。
独立站SEO从来不是什么玄学,只要你能做到内容语义有实质差异、长尾词踩在用户真实的搜索痛点上,哪怕不用什么昂贵的自动化黑科技,靠自己写的几十行脚本老老实实清洗数据,几个月后曲线照样能稳步抬头。做站,多看服务器日志,少听大师画饼,把基础做好比啥都强。
相关文章
- Ahrefs API结合大模型挖掘内容Gap:别导表了,让AI自动扒对手词
- GSC API流量监控与排名异动告警脚本:别肉眼盯GSC了,写个告警脚本
- 自动化内链拓扑网络生成算法:别手搓内链了,教你用脚本搞定
- 批量语义去重与TF-IDF长尾词优化:别瞎堆词了,教你怎么洗出流量
- AI生成图自动压缩与WebP无损转换:AI生图太肥拖垮网站?教你自动压
- 自动化Title与Description点击率测试:手把手教你自动化测标题点击率
- AI生成的薄弱内容自动化归档方案:批量AI垃圾文?写个脚本自动归档
- 基于大模型的竞品外链锚文本分析工具开发:自己写个工具:用AI扒光竞品外链
- Embedding语义检索系统设计:搞懂语义搜索,看这篇就够了
- 基于大语言模型的网站开发流程:用大模型做网站,教你完整搞定