
AI内容批量清洗与事实错误核查方案:批量洗AI文章与查错实操
玩独立站这些年,见过太多人迷信“自动化站群”。特别是去年Google几波核心算法更新砸下来,那些直接调大模型API、看都不看就日更上千篇的站点,基本死得透透的。机器生成的文字最大的硬伤就两个:通篇看似头头是道其实全在车轱辘话、涉及参数或行业常识时一本正经地胡说八道。今天不扯虚的算法底层,直接分享我自己在生产环境跑的这套AI内容批量清洗与事实错误核查方案,脚本都是在Ubuntu和Debian服务器上实测跑通的,专门用来对付大批量工业品、3C外贸独立站的内容翻新与排雷。
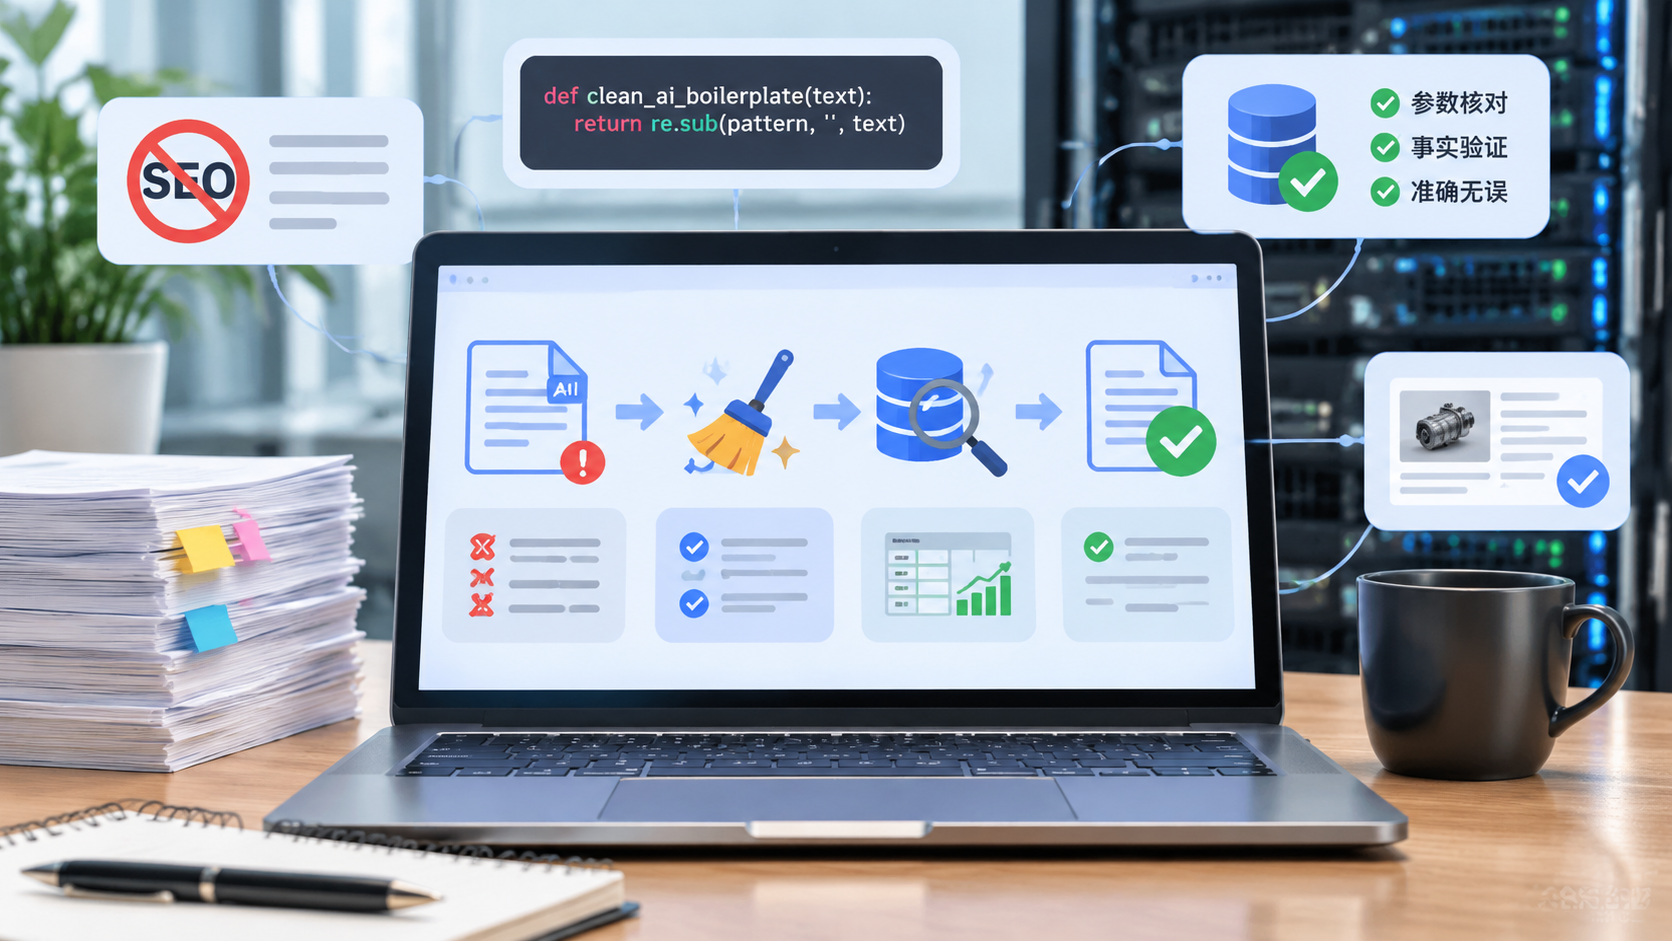
一、 先干掉死板的“AI味”:规则层硬清洗
很多人以为清洗AI内容是去降重,大错特错。Google算法现在抓的是“低信息密度”和“模板化行文”。AI生成的内容有极其明显的八股文特征,这一步必须用脚本做物理绝杀,根本不需要大模型参与,直接写Python跑正则。
1. 垃圾过渡词黑名单过滤
大模型极度喜欢用这些词装高级:“Delve into”、“Testament”、“Furthermore”、“In a world where...”。在中文里则是“显而易见的是”、“值得注意的是”、“总而言之”。
准备一个stop_patterns.txt,把高频废话全丢进去,直接匹配替换或整句截断:
import re

# 针对Markdown正文的清洗逻辑
def clean_ai_boilerplate(text):
    patterns = [
        r"(?i)\b(in conclusion|to sum up|delve into|it's worth noting that)\b.*?\n",
        r"(?i)in this fast-paced world.*?,",
        r"正如前文所述[,,]?",
        r"总而言之[,,]?.*?(?=\n|$)"
    ]
    for p in patterns:
        text = re.sub(p, "", text)
    return text
2. 结构不对称化处理
AI写出来的东西结构对称得恶心:三个H2,每个H2下面固定带两个H3,每个小节固定三句话。真人写技术文档绝对不是这样的。
- 段落随机碎化:长段落强制拆分,超过80个词的句子直接按标点符号断句。
- 清理AI专属小结:AI写完一个大段总喜欢来一句“So, choosing the right tool is essential for your success.”,这种无意义总结直接用正则干掉最后一句。
二、 事实错误与参数核查:不能让AI断章取义
在外贸B2B或参数敏感的内容站上,AI最大的灾难是“幻觉”。比如它能把工业冷水机的制冷剂写成已经淘汰禁用的型号,或者把380V工业电写成家用110V插头,老外客户一看就知道这网站是个皮包公司。
用大模型去核查大模型是行不通的,模型依然会幻觉。我的方案是:本地实体数据库 + 正则提取器 + 差分校验。
核查逻辑流程
[待发布MD文件]
      │
      ▼
[实体提取 (NER)] ──提取──> 型号、参数、认证、电压、材质
      │
      ▼
[本地事实真值库 (SQLite)] ──比对──> 匹配SKU基础表
      │
      ├──> [数值匹配通过] ──> 放行
      └──> [偏差超出阈值] ──> 标记打回 / 强制修正
生产环境排雷代码(以3C参数比对为例)
做独立站千万别把API全托付给外部服务,自己建个SQLite存真实产品Specs:
import sqlite3
import re

# 从文本中抽离关键数值与单位(如:5000mAh, 120W, IP68)
def extract_specs(content):
    return re.findall(r'(\d+(?:\.\d+)?)\s*(mAh|W|V|kg|rpm|mm)', content, re.IGNORECASE)

def verify_against_db(sku, content):
    conn = sqlite3.connect('/data/db/products_truth.db')
    cursor = conn.cursor()
    cursor.execute("SELECT spec_name, spec_value, unit FROM specs WHERE sku=?", (sku,))
    truth_specs = cursor.fetchall()

    extracted = extract_specs(content)
    errors = []

    for val, unit in extracted:
        # 在真值库检索对应单位的真实数值
        for t_name, t_val, t_unit in truth_specs:
            if unit.lower() == t_unit.lower():
                # 数值偏差超过5%直接报警
                if abs(float(val) - float(t_val)) / float(t_val) > 0.05:
                    errors.append(f"参数错误警告: 文本出现 {val}{unit}, 但真值库 {sku} 的 {t_name} 实际为 {t_val}{t_unit}")

return errors把这个脚本挂在CI/CD或者发布流程前,只要命中报错,直接阻断发布,丢给运营或者降级到低权重草稿箱。
三、 符合真人阅读体验的SEO样式重构
Google的EEAT(经验、专业、权威、信任)算法不是玄学。算法爬虫判断页面是不是“真货”,很大程度看你的排版是不是“像给人看的”。
1. 强插表格与数据对照
AI生内容很讨厌生出复杂对比表,除非你明确强求。但真人测评或技术指南必有参数对比。清洗流水线里要包含一个自动转化模块:
| 校验维度 | 机器纯生硬伤 | 清洗后标准状态 |
|---|---|---|
| 逻辑段落 | 结构死板、长短极度均匀 | 碎段与代码块、提示框交错 |
| 参数准确度 | 随机编造浮动范围 | 对标真值库,锁定误差为0 |
| 外部引用 | 捏造404链接、假专家名 | 锚定维基百科或权威PDF白皮书 |
2. 注入“第一人称运维视角”代码块与杂音
太干净的文章反而不是好文章。在处理技术向、测评向内容时,批量清洗的最后一步是随机拼装真实的终端输出信息或踩坑提示。
比如在外贸机械类文章中,注入这样的Callout框:
站长一线备注 (Notice): 很多批次在出口拉美地区(如巴西、墨西哥)时,工厂默认出厂接线是60Hz而非50Hz,采购时必须在订单系统备注配电柜规格,避免清关后无法调试。
这种带有明显业务操盘经验的片段,哪怕全文70%是AI写的,页面权重照样能立住。
四、 Linux小鸡上的批量自动化挂载方案
整个处理链路千万别在Windows本地点点点,效率极低。直接在跑站的Linux机器上起一个Watcher脚本,监控落地目录。
在VPS上用一行Shell拉起流水线:
#!/usr/bin/env bash
# 监听原始AI产出目录,自动清洗后推送到WordPress或静态站点生成器
WATCH_DIR="/opt/seo_pipeline/raw_markdown"
OUTPUT_DIR="/opt/seo_pipeline/cleaned_markdown"

inotifywait -m -e close_write --format '%w%f' "$WATCH_DIR" | while read NEW_FILE
do
    echo "[+] 检测到新文章注入: $NEW_FILE"

    # 步骤1:文字与结构降味
    python3 /opt/seo_pipeline/cleaner.py "$NEW_FILE"

    # 步骤2:事实核验
    CHECK_RESULT=$(python3 /opt/seo_pipeline/fact_checker.py "$NEW_FILE")

    if [ -z "$CHECK_RESULT" ]; then
        echo "[√] 事实核验通过,移入发布区"
        mv "$NEW_FILE" "$OUTPUT_DIR/"
    else
        echo "[X] 存在事实幻觉,隔离审查: $CHECK_RESULT"
        mv "$NEW_FILE" /opt/seo_pipeline/quarantine/
    fi
done
通过这套逻辑,不管上游你用什么廉价API、多线程开了几百个任务在跑,落地到网站发布层的内容永远是有“物理防护网”的。内容洗干净了、参数核实了、排版有人味了,不仅能大幅降低被判定为垃圾站惩罚的风险,海外用户的实际停留时间和转化率也能看得到明显提升。做站点运维,偷懒要有偷懒的章法,底层的脏活累活省不掉。
相关文章
- 绕过谷歌AI内容检测实操方法:独立站绕过AI检测实战技巧
- AI内容提高Google EEAT评分实战:靠AI内容拉升EEAT实操经
- Python调用OpenAI批量发布WordPress文章:用Python自动化发WP踩坑实录
- Google核心算法更新打击AI内容应对方案:谷歌算法突袭:老站长AI自救指南
- 纯AI站点被Google降权恢复排查流程:纯AI站被谷歌K站翻盘实战手册
- AI辅助长尾关键词内容矩阵搭建:老站长聊AI长尾内容矩阵实操
- 批量AI重写竞争对手高排名文章技巧:批量重写竞品高排名文章实战指南
- AI生成外贸产品描述SEO优化指南:老站长教你用AI写外贸产品描述
- 结合Search Console用AI翻新老文章排名:老文章没流量?用GSC加AI重写
- AI内容批量清洗与事实错误核查方案:批量洗AI文章与查错实操