
英文站Blog引流实战避坑指南
搞英文站Blog引流别再盲目堆砌AI垃圾文章了,想要稳定获取谷歌有机流量,核心只有两件事:用“搜索意图(Search Intent)”精准定位低难度长尾词,再配合“EEAT架构+ JSON-LD 结构化数据”做极致的内容交付。
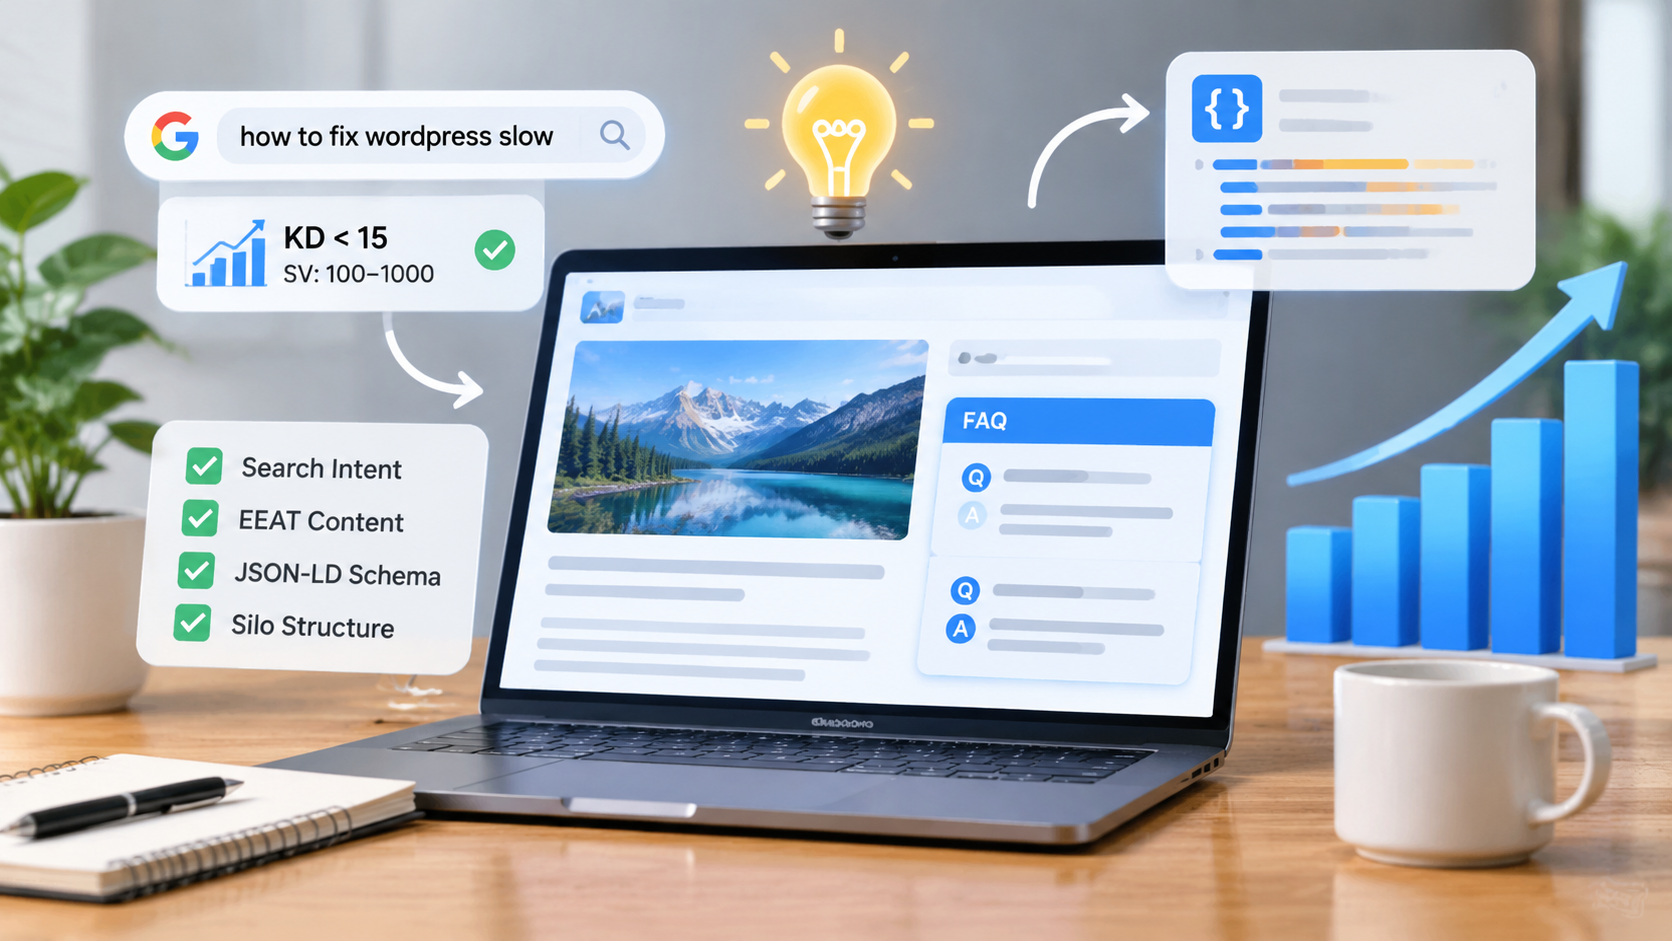
很多站长搞英文Blog,日更十篇用ChatGPT甩出来的垃圾文,几个月下来谷歌收录个位数,流量基本为零。问题出在哪?出在你的选词逻辑、内容交付方式和技术细节全在谷歌算法的雷区里蹦迪。下面结合我带团队跑过几十个英文站的实操血泪史,把这套能落地的避坑与引流方案彻底拆透。
核心方案速览
想要让英文Blog真正带来转化和流量,必须建立标准化管线(Pipeline):
- 选词避坑:放弃大词(Volume > 5000 且 KD > 30),专门吃 KD < 15、搜索量在 100~1000 之间的 Problem-Solving(问题解决型) 长尾词。
- 内容避坑:拒绝纯AI生成。采用“AI拟定大纲+人工注入真实数据/踩坑经验(EEAT)”的混合生产模式。
- 技术避坑:别只依赖SEO插件,手动部署 JSON-LD 结构化数据,强制触发 Google Rich Snippets(丰富网页摘要)。
- 内链避坑:丢掉随缘插链接的习惯,建立严格的 Silo 架构(蚕丝结构),让权重在相关文章间高效流动。
实操细节深度拆解
核心动作一:长尾词挖掘与搜索意图清洗
不要去碰像 "best VPN"、"how to make money online" 这种被巨头垄断的死坑。新站或低 DR(Domain Rating)站点做英文站Blog引流,首选是 "How to fix [Specific Error]" 或 "[Tool A] vs [Tool B] for [Specific Persona]"。
实操步骤:用 Python 脚本批量抓取 Google Suggest 长尾词
别全信 Ahrefs 的数据,搜索框自动补全是用户最真实的实时搜索意图。
import requests
import json

def get_google_suggest(keyword):
    # 模拟谷歌搜索下拉框接口
    url = f"http://suggestqueries.google.com/complete/search?client=chrome&q={keyword}"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    }
    response = requests.get(url, headers=headers)
    if response.status_code == 200:
        suggestions = json.loads(response.text)[1]
        print(f"Keywod: {keyword} -> Suggestions:")
        for item in suggestions:
            print(f" - {item}")

# 替换为你所在行业的核心词
get_google_suggest("wordpress slow after update")
避坑点:
- 搜索意图冲突(Intent Mismatch):如果用户搜 "free pdf editor",你写了一篇推荐付费软件的博客,离跳出率 90% 就不远了。搜 "Free" 的必须落地在“真免费”或“免费替代方案”上。
核心动作二:符合 EEAT 的内容结构化输出
Google 的 HCU(Helpful Content Update)算法专门杀全自动AI生成的垃圾博客。让AI帮你写大纲和过渡段,但核心观点、对比表格、代码或截图必须由人提供。
可直接套用的高效 Blog 文章结构模板(Markdown格式):
# [Actionable Title: How to Solve Problem X without Y]

## Quick Answer / TL;DR
> **Direct Solution**: [用1-2句话直接给出解决方案,方便Google抓取 featured snippet]

## Step-by-Step Guide
### Step 1: Diagnosis
[插入真实截图或诊断命令]

### Step 2: Implementation
```bash
# 提供可以直接复制粘贴的代码段/配置
sudo systemctl restart nginx
Real-world Case Study / Benchmarks
| Method | Time Taken | Success Rate | Cost |
|---|---|---|---|
| Option A | 5 mins | 95% | $0 |
| Option B | 2 hours | 60% | $50 |
FAQ
Q1: [用户高频提问]
A1: [简洁回答]
#### 避坑点:
* **废话连篇的开篇**:西方读者和谷歌极其讨厌“In today's digital world...”这种典型的AI开场白。开篇第一句话必须直接抛出答案或文章价值。

---

### 核心动作三:手动注入 JSON-LD 结构化数据

想要在搜索结果里抢占高点击率(CTR)位置,FAQ Schema 和 HowTo Schema 是必杀技。别全指望 WordPress 插件注入臃肿的代码,手动在文章头部或尾部加入精简的 JSON-LD。

#### FAQ Schema 标准代码(直接嵌入文章 HTML 中):

```html
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [{
    "@type": "Question",
    "name": "How to fix 504 Gateway Timeout in Nginx?",
    "acceptedAnswer": {
      "@type": "Answer",
      "text": "Increase the max_execution_time in php.ini and adjust proxy_read_timeout in nginx.conf to 300 seconds."
    }
  },{
    "@type": "Question",
    "name": "Does clearing cache fix 504 errors?",
    "acceptedAnswer": {
      "@type": "Answer",
      "text": "Clearing the server-side cache and proxy cache can resolve stale connection issues triggering 504 errors."
    }
  }]
}
</script>
适用场景:
所有包含“常见问题解答”的教程类、对比类 Blog 文章。
避坑点:
- 页面内容与 Schema 不一致:JSON-LD 里面的文本必须和页面上肉眼可见的文字完全一致,否则会被谷歌判定为结构化数据作弊(Structured Data Spam),直接取消 Rich Snippets 展示资格。
核心动作四:构建有效内链(Silo Architecture)
流量进来了,留不住或者无法传递权重,就是无用功。不要随意把所有文章都连到首页,要建立“ Pillar Page(核心柱页) + Cluster Posts(子簇文章)”的闭环。
          [Pillar Page: Ultimate Guide to Node.js Performance]
                               /       \
                              /         \
[Cluster 1: Memory Leak Fix] <---> [Cluster 2: Async Loop Optimization]- 子簇文章(Cluster)必须反向链接到柱页(Pillar)。
- 相同子簇内的文章互相精准锚文本链接。
- 锚文本严禁全部使用 "click here" 或全匹配主关键词,必须是自然的语义短语(如
fix memory leaks in Node.js)。
高频关联问题拓展
问题一:新发布的 Blog 文章谷歌迟迟不收录,怎么办?
光靠提交 Sitemap 效率太慢。特别是新域名,谷歌爬虫来得极慢。
解决方案:调用 Google Indexing API 主动推送 虽然这个 API 官方说是给 JobPosting 和 BroadcastEvent 用的,但实测对 Blog 页面同样有效且速度极快。
Node.js 调用脚本:
const {google} = require('googleapis');
const keys = require('./service_account.json'); // 从 Google Cloud Console 下载的密钥

const client = new google.auth.JWT(
  keys.client_email,
  null,
  keys.private_key,
  ['https://www.googleapis.com/auth/indexing'],
  null
);

async function publishUrl(url) {
  await client.authorize();
  const result = await google.indexing('v3').publish({
    auth: client,
    requestBody: {
      url: url,
      type: 'URL_UPDATED',
    },
  });
  console.log('Indexing API Response:', result.data);
}

// 替换为你刚发布的新文章 URL
publishUrl('https://yourdomain.com/blog/how-to-fix-error');
问题二:Blog 出了好几篇爆款,流量不少,但没有任何商业转化?
这是典型的“高信息流、零转化”陷阱。搜“什么是XX”的人大概率不会买东西,搜“XX怎么配”的人才有购买力。
解决方案:实施“上下文文内 CTA (In-text Call to Action)” 不要只在侧边栏挂硬广(没人会看),在文章解决关键痛点的代码下方或操作步骤中间,插入强相关的轻量提示框。
HTML/CSS 样式直接套用:
<div style="background-color: #f0f7ff; border-left: 4px solid #0066cc; padding: 15px; margin: 20px 0; border-radius: 4px;">
    <p style="margin: 0; font-weight: bold; color: #003366;">💡 Tired of configuring this manually?</p>
    <p style="margin: 5px 0 0 0; color: #333;">Check out our automated tool that fixes Nginx timeouts in 1-click. <a href="/product-page" style="color: #0066cc; font-weight: bold; text-decoration: underline;">Try it free for 14 days →</a></p>
</div>
问题三:要不要去 Fiverr 买外链(Backlinks)冲权重?
绝对不要! Fiverr 上 99% 卖外链的都是 PBN(私有博客网络)或者被惩罚过的农场站(Link Farm)。买了之后可能短时间 DR 数字上升,但下一次 Google Spam Update 就会让你的站点彻底从索引中消失。
正确的低成本外链实操逻辑:
- Broken Link Building(死链修复法):用 Ahrefs 查竞品的失效外链,写一篇更好的,发邮件给原网站主:“你这篇网页里的某个链接失效了,我写了一篇更新更全的,你要不要替换一下?”
- Data-Driven Content(数据型内容):自己做个行业小调研或整理一份开源清单(Awesome-List),这种内容天然吸引技术博客和 Hacker News/Reddit 的自发引用。
总结
做英文站Blog引流,从来不是比拼谁发文章发得多,而是比拼谁的内容能更高效、更准确地解决特定问题。
- 少做:100% 依赖 AI 批量造垃圾词库文、去 Fiverr 刷垃圾外链、堆砌死板的大词。
- 多做:深挖 Long-tail Keyword(低难度长尾词)、手动规范 JSON-LD 结构化数据、用实操代码和真实截图打造高 EEAT 页面,并用 Google Indexing API 加速收录。
执行力拉满,按照这套流程把前20篇文章做精,流量自然会呈复利式增长。
相关文章
- 解决内容同质化的垂直化策略**,核心就一句话:**砍掉80%人人皆知的泛流量大路货,把剩下的20%业务直接切进“特定环境+极端约束+私有代码/配置数据”的细分场景里。
- 一、 核心方案速览
- 模拟关键词列表(实际操作读取TXT或CSV)
- 示例:使用 cURL 快速验证线上页面是否包含正确配置的 JSON-LD script 标签
- 找出 /var/lib/docker/containers/ 下体积排名前 10 的日志文件
- Role: 资深技术/行业专家兼内容重构编辑
- 站内专题页面的SEO权重分配:专题页SEO权重分配实战指南
- 解决网站跳出率过高的内容策略:干掉网站高跳出率的硬核内容策略
- 如何挖掘高转化的SEO选题:高转化SEO选题挖掘实操指南
- 英文站Blog引流实战避坑指南