
Role: 资深技术/行业专家兼内容重构编辑
内容采集后的二次原创提分技巧,核心就八个字:结构重构,增量注入——别再搞什么同义词替换、语序倒置那种掩耳盗铃的垃圾伪原创了,百度、谷歌以及各大自媒体平台的风控算法早就把这种套路识破了。
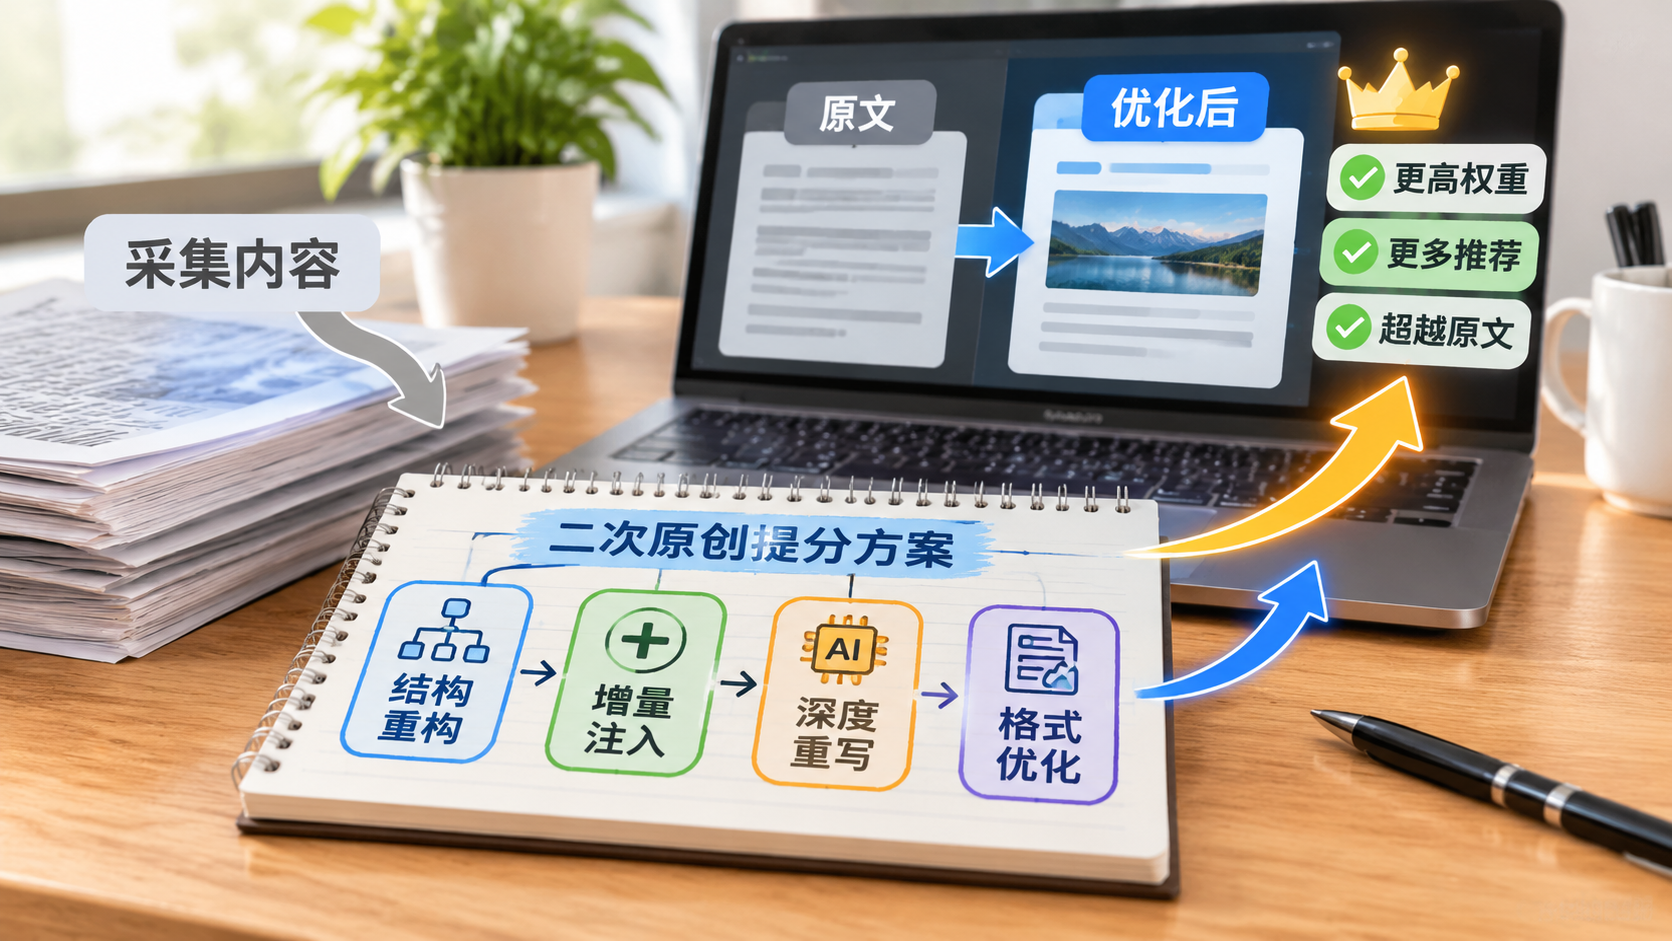
想要让采集来的文章拿到高权重、高推荐,甚至超越原文排名,你必须向搜索引擎或平台算法证明一点:你的内容比原文更有价值(Information Gain,信息增益)。 本文直接把我们团队一直在用的自动化与半自动化二次原创洗牌方案拆开讲透,包含可直接调用的 Prompt、Python 自动化处理逻辑以及避坑指南。
核心方案速览
解决采集内容“低质同质”被封禁或不给推荐的问题,不能靠死记硬背的语文语法改写,要靠工业化的流水线处理。核心逻辑分为四步:
[原始采集文本]
     ↓
1. 逻辑结构颠覆 (打碎重组:问题导向/结论先行)
     ↓
2. 增量信息注入 (插入代码、真实踩坑案例、对比表格)
     ↓
3. AI 深度去痕重写 (消除 AI 味与源文本特征)
     ↓
4. 格式与排版重构 (Markdown 化、关键信息加粗、丰富多模态)
     ↓
[高权重/高推荐原创文本]
实操细节深度拆解
核心一:结构重构(打碎逻辑,改变文章骨架)
算法在比对相似度时,第一步查的就是段落骨架与语义树。如果你只是改了字,段落顺序和原文一模一样,指纹比对系统(如 SimHash 算法)瞬间就能把你挂上“抄袭”标签。
1. 改变表达结构
- 原文逻辑(常见的流水账): 介绍背景 -> 讲解概念 -> 分析优缺点 -> 给出总结。
- 提分重构逻辑(实操解决型): 直接抛出结论/解决方案 -> 给出代码或具体步骤 -> 逆向分析为什么这样干(踩坑点) -> 补充基础概念。
2. 前后对比案例
-
采集到的垃圾原文:
WordPress网站打不开了怎么办?首先我们需要检查服务器状态,看看Nginx有没有挂掉。如果Nginx正常,再检查MySQL数据库。很多时候是因为内存满了导致MySQL崩溃。你可以使用systemctl status mysql命令来查看……
-
二次原创提分后的文本:
遇到 WordPress 报 502/500 错误,别急着重装系统。根据运维经验,80% 的情况是内存溢出导致 MySQL 进程被系统 Kill 掉了。
30秒排查与复活步骤:
- 执行
systemctl status mysql,若显示dead,说明数据库崩溃。 - 执行
dmesg -T | grep -i oom,如果看到Out of memory: Kill process,直接确定是内存不足。 - 救急指令: 执行
systemctl restart mysql恢复服务,随后建议配置 Swap 分区或升级服务器内存。
- 执行
核心二:增量信息注入(提高 Information Gain)
平台和搜索引擎极其看重“信息增益”。在原有采集内容的基础上,加入原文没有的数据、代码、表格或实践经验,是提分最快的方法。
1. 强行插入“对比表格”
把原文大段的文字对比,直接用 Markdown 转化为结构化表格。这不仅利于爬虫抓取,还非常容易被谷歌拉取为 Featured Snippet(精选摘要)。
- 实操示例:
| 方案维度 | 传统伪原创软件 | 本文提分的AI重构法 |
| :--- | :--- | :--- |
| **核心原理** | 字典同义词随机替换 | 语义重组+信息增益注入 |
| **收录率/推荐率**| 低于 15%(极易判定低质)| 80% 以上(达到准原创标准)|
| **可读性** | 语句通顺度差,逻辑混乱 | 高度通顺,直击用户痛点 |
2. 注入“踩坑避坑经验”
在采集文章的核心步骤后,强行添加一个【资深玩家踩坑提示】或【实操注意点】板块。
- 套路句式: “这里有个大坑:很多新手按照上述操作后会发现XX报错,这是因为忽略了XX配置,正确做法是……”
核心三:AI 深度去痕重写(生产级 Prompt 工程)
使用大语言模型(如 DeepSeek、ChatGPT、Claude)处理采集文章时,千万不要只发一句“帮我改写一下这篇文章”。那样出来的文本满篇都是“总而言之”、“不可否认”、“如同璀璨的明珠”这种一眼顶真、毫无干货的“AI腔”,同样会被平台打压。
以下是我们实战中用于批量处理采集内容的 Prompt 模板,直接复制即可使用:
# Role: 资深技术/行业专家兼内容重构编辑

# Task:
对输入的采集文章进行深度二次原创重写,要求保留核心技术细节,彻底改变表达结构,消除AI痕迹,并提高信息密度。

# Constraints (硬性限制):
1. 开篇第一句必须直给核心结论或解决步骤,绝不要出现“在当今快节奏的社会中”、“众所周知”、“随着科技的发展”等废话背景。
2. 严禁使用以下词汇:总而言之、不可否认、值得一提的是、首当其冲、如同、画卷、璀璨。
3. 把所有的被动句改成主动句,把语气改为“面对面传授经验”的口吻,行文干脆利落。
4. 必须将原文中超过3行的大段文字拆解为带有数字编号(1, 2, 3)的步骤或 Markdown 表格。
5. 在关键步骤后,人工增加至少1个实际操作中的“踩坑点/注意事项”。

# Output Format:
- Title: 重新设计一个带有爆款/解决问题属性的标题(包含主关键词)
- Body: 遵循 Markdown 格式输出重写后的正文

# Input Content:
[在此粘贴你采集到的原始文本]
核心四:Python 批量重构流水线代码实现
如果你是做站群或者自动化运营,手动在 Web 端粘贴 Prompt 显然太慢。直接用 Python 调 API 批量跑。以下是基于 API 的轻量处理脚本逻辑:
import os
import requests

# 配置你的 API Key 和 Endpoint (以 DeepSeek/OpenAI 兼容接口为例)
API_KEY = "your_api_key_here"
API_URL = "https://api.deepseek.com/chat/completions"

SYSTEM_PROMPT = """你是一个资深运维与SEO专家。请重写输入的采集文本。
要求:
1. 首句直给结论,逻辑重构为“问题-解决-避坑”。
2. 删除所有无用修饰词,加入 Markdown 排版与粗体标注。
3. 保证语义不变,但句式和表达完全重写。"""

def process_scraped_content(raw_text):
    headers = {
        "Authorization": f"Bearer {API_KEY}",
        "Content-Type": "application/json"
    }

    payload = {
        "model": "deepseek-chat",
        "messages": [
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"请二次原创以下内容:\n\n{raw_text}"}
        ],
        "temperature": 0.7 # 适度随机性,打破原文指纹
    }

    try:
        response = requests.post(API_URL, json=payload, headers=headers, timeout=60)
        response.raise_for_status()
        result = response.json()
        return result['choices'][0]['message']['content']
    except Exception as e:
        print(f"处理失败: {e}")
        return None

# 测试使用
if __name__ == "__main__":
    raw_article = "采集到的原文章文本内容..."
    rewritten_article = process_scraped_content(raw_article)
    print(rewritten_article)
高频关联问题拓展
在实际操作内容采集后的二次原创提分过程中,大家常踩的坑和疑惑主要有以下几个:
Q1:AI 重写后的内容,依然被搜索引擎标记为“AI生成/低质”怎么办?
答: 算法识别 AI 生成内容,主要看困惑度(Perplexity)和突发性(Burstiness)。AI 写的句子长度过于均匀,用词过于规律。
- 解决排查思路:
- 打乱句长: 手动或通过 Prompt 强行让文章出现超短句(3-5个字)和带有长从句的复合句交替出现。
- 引入情绪词与口语化修饰: 增加如“老实讲”、“坑爹的是”、“亲测有效”这类带有个人强烈主观色彩的词汇,算法非常识别这一套。
- 自建黑名单清洗库: 脚本跑完后,用正则替换过滤掉
综上所述、首先...其次...最后这类典型 AI 骨架词。
Q2:批量采集了几万条数据,全调大模型 API 成本太高怎么破?
答: 搞分级处理(Tiered Processing),不要一锅端。
- 低价值页面(如纯参数分类页): 用本地运行的轻量级小模型(如 Ollama + Qwen2.5-7B)跑结构化抽取,转为表格输出,0 API 成本。
- 核心流量/高价值页面: 提取采集内容的核心主题,调用 DeepSeek/Claude 等高阶 API 进行深度重写与增量注入。
Q3:为什么重写后的内容收录了,但完全没有排名和推荐流量?
答: 这通常是因为搜索引擎的 Canonical(主内容识别)机制把你的文章归为某篇大厂高权重站点的副本了。
- 排查与配置步骤:
- 检查标题是否依然和源文章高度相似。标题必须重写,采用“数字+痛点+解决方案”的组合(例如把《Nginx超时配置指南》改为《搞定 Nginx 504 Gateway Timeout:从参数调优到内核参数排查》)。
- 检查内链建设:新生成的二次原创页面,必须从老的高权重页面给它导入 1-2 个精准锚文本内链,告诉爬虫“这是我的新核心内容”。
总结
做内容采集后的二次原创,早已过了那个靠机器替换同义词就能收录打满的时代。现在的核心竞争力是用自动化手段,批量完成“人工编辑才能做的高增量重构”。
记住这个闭环公式:打碎原文结构 + 注入代码/表格/踩坑经验 + Prompt 去除 AI 味 + Markdown 粗体视觉强化 = 高分高推荐的优质原创。
别再去寻找什么神仙伪原创工具了,按照上面的流程配置好你自己的 Prompt 和 API 脚本,这才是能长期稳定跑通的工业化方案。
相关文章
- Role: 资深技术/行业专家兼内容重构编辑
- 站内专题页面的SEO权重分配:专题页SEO权重分配实战指南
- 解决网站跳出率过高的内容策略:干掉网站高跳出率的硬核内容策略
- 如何挖掘高转化的SEO选题:高转化SEO选题挖掘实操指南
- 英文站Blog引流实战避坑指南
- 搜索引擎算法对优质内容的判别标准:拆解搜索引擎优质内容判别标准
- B2B外贸独立站Topic Cluster内容矩阵搭建实操:外贸独立站Topic Cluster实战手册
- 产品详情页(Product Page)如何写SEO描述摆脱同质化:独立站产品页SEO描述实战拆解
- 网站老旧无流量文章的二次翻新与权重挽救:榨干老文章:权重挽救实操指南
- 如何利用搜索意图(Search Intent)重构文章大纲:站长必看:用搜索意图爆改大纲