
Canonical规范标签防止内容重复收录:网站总被重复收录?用它一招解决
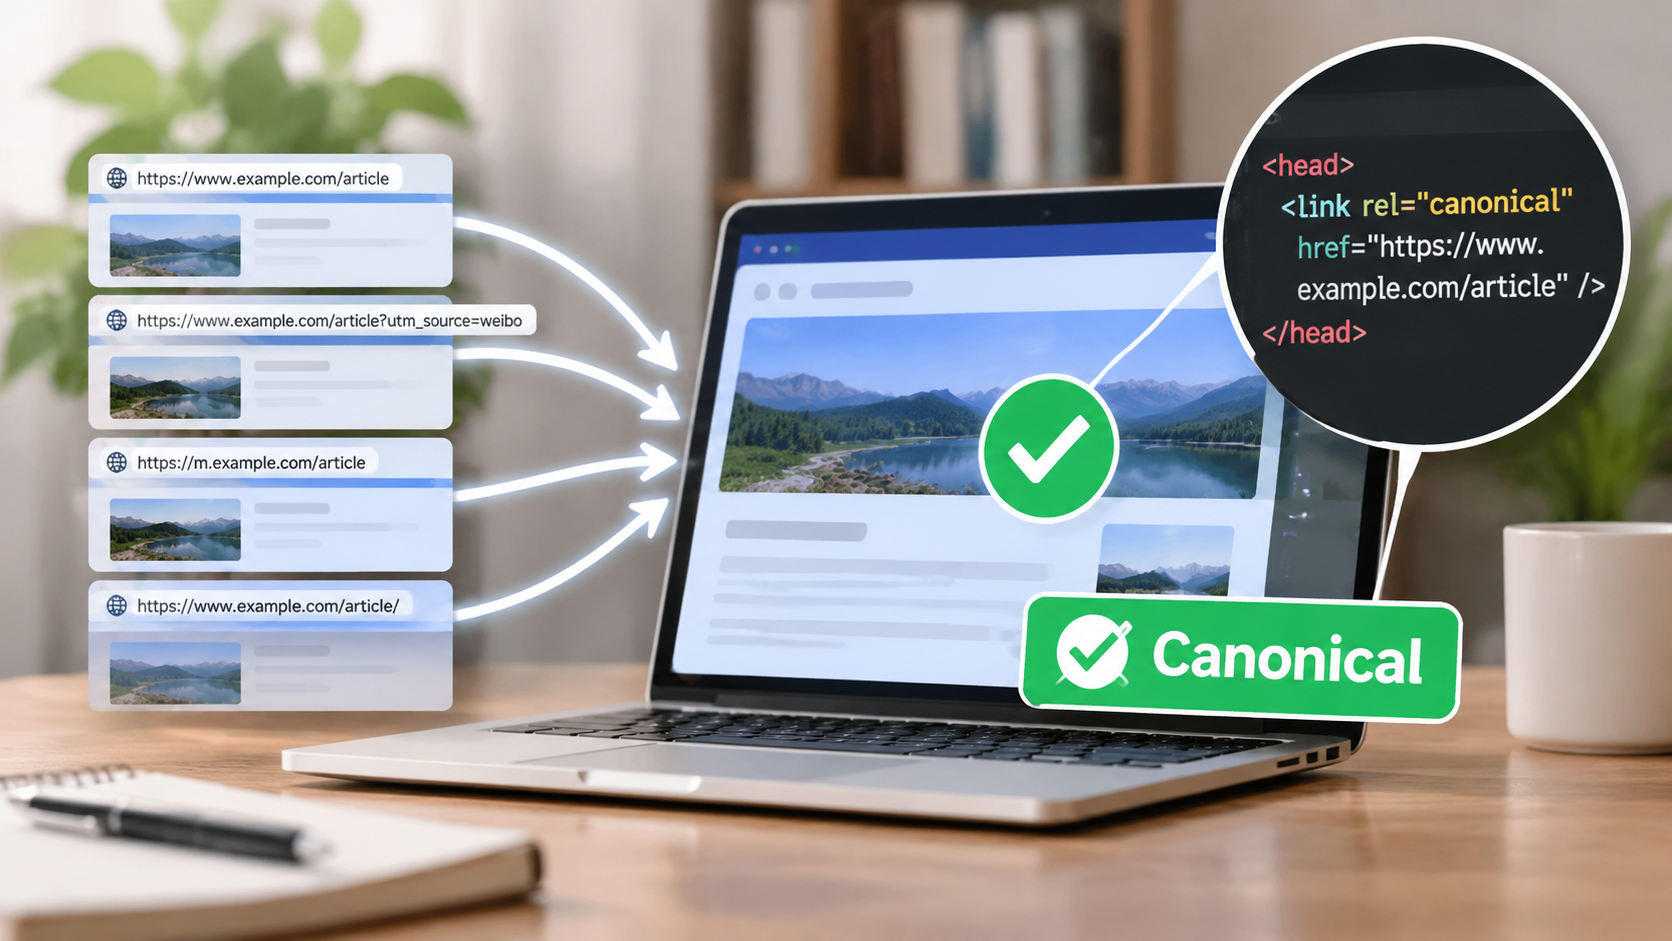
做过网站运维或者SEO的朋友,大概率都踩过这样的坑:明明只写了一篇原创内容,但在搜索引擎后台一查,却发现带参数的推广链接、分类目录页、以及手机端适配页都被抓取并收录了一遍。这种现象不仅严重稀释了原始页面的权重,还白白浪费了宝贵的抓取配额,甚至可能触发搜索引擎的重复内容惩罚。在实际业务中,通过Canonical规范标签防止内容重复收录,是技术运维和SEO人员最直接、成本最低且最优雅的解决方案。它就像是你在网页底层给搜索引擎爬虫递的一张纸条,明确告诉对方:“不管你通过哪个乱七八糟的链接爬进来的,请认准我指定的这一个唯一正统页面。”
一、 为什么你的网站总在悄悄“自我克隆”?
很多技术开发人员在设计路由时,往往只考虑“页面能不能打开”,而忽略了“搜索引擎怎么看待这个URL”。在爬虫眼中,只要URL多了一个字符,哪怕页面内容完全一致,它也是一个独立的新页面。常见的重叠场景包括:
- 跟踪参数泛滥:为了做数据归因,链接后常带有
?utm_source=weibo、?ref=article或者点击跟踪ID。 - 电商与目录筛选:比如服装列表页,按照“价格升序”和“销量降序”展示的其实是同一批商品,URL却变成
?sort=price和?sort=sales。 - URL规范化缺失:带
www与不带www、协议头http与https、末尾带斜杠/与不带斜杠混用。 - 移动端适配与自适应:虽然现在大多采用自适应布局,但依然有大量系统采用独立子域名
m.domain.com,如果不做规范化关联,极易造成移动端和桌面端双重收录打架。
二、 Canonical标签的底层机制:它和301跳转有何区别?
Canonical标签的语法非常简洁,放置在HTML文档的 <head> 区域内:
<link rel="canonical" href="https://www.yourdomain.com/original-article.html" />很多刚接触SEO的同学常问:既然都是为了解决重复页面,为什么不用301重定向?
答案在于用户体验与业务逻辑的兼顾。301重定向是强制性的,一旦跳转,访客就无法停留在原URL上。但有些场景下,用户必须停留在带参数的页面——例如带有分页筛选条件的搜索结果、带有推广渠道追踪标记的落地页等。301跳转会破坏这些参数的传值或交互逻辑。
而Canonical标签是一个弱提示性协议(对Google等国际爬虫权重极高,对百度等国内引擎也同样适用且被官方认可)。它允许不同URL正常展示给用户浏览,同时在搜索引擎建立索引的索引库(Index)阶段,把所有分散的权重、外链投票和页面信号,全部归集到Canonical指定的“主页面”上。
三、 切实可行的实施方案:如何优雅且正确地配置?
如果你想彻底杜绝重复收录,以下是标准落地步骤:
1. 坚持使用绝对路径,拒绝相对路径
这是新手最容易犯的错误。错误写法:<link rel="canonical" href="/article/123" />。这种写法在遇到跨域、二级目录或者多协议解析时,往往会让爬虫产生误解。务必写死完整的绝对路径:包含协议(https)、主域名和完整路径。
2. 必须配置“自引用”(Self-referencing Canonical)
在没有参数的“规范页面本身”,也必须在代码里加上指向自己的Canonical标签。很多人认为“既然这就是主页面,就没必要加了吧”,实则不然。自引用Canonical能有效防御恶意镜像站采集、第三方爬虫抓取加料、或者外部未受控外链导致的乱传参数问题。
3. 动态页面的自动化输出方案
如果是CMS开发或者全栈自研系统,切忌手动硬编码写死,应该结合路由在后端渲染(SSR)中动态剥离干扰参数后输出。
以Node.js/Next.js或PHP为例,系统接收到URL后,运维与开发应设定好白名单机制:主动过滤掉类似 utm_*、fbclid、page_id 等非内容参数,仅提取内容的核心标识(如 article_id),拼装出规范链接,再注入到页面模板的头部。
4. 分页体系的正确处理
分类列表的分页是重复内容的重灾区。切记:不要把第二页、第三页的Canonical全指向第一页! 这样做会导致第二页以后的深层文章无法被爬虫顺藤摸瓜抓取。正确的做法是:第一页指向第一页,第二页指向带有 ?page=2 的自身,每一页都自引,或者利用专用归档页来集中处理。
四、 避坑指南:这些低级错误千万别犯
在实际运维排错中,我们经常遇到因为Canonical配置错误导致整站收录暴跌的情况:
- 死循环与链式指向:A页面指向B页面,B页面又指向A页面;或者A指向B,B指向C。这会让搜索引擎直接放弃采信你网站上的所有Canonical标签。
- 指向非200状态码的页面:如果你把Canonical指向了一个已经404或者301跳转的链接,爬虫会认定你的技术架构极度混乱,直接无视该标签。
- 页面中存在多个Canonical标签:常见于安装了多个SEO插件的WordPress站点,或者前端SPA渲染和后端SSR混合注入导致的冲突。一个页面只要出现两个不同href的Canonical,搜索引擎会默认全部忽略。
- 与Robots.txt冲突:如果你在Canonical里指向了一个页面,但在
robots.txt规则里却把它给Disallow(屏蔽抓取)了,搜索引擎就无法抓取目标页来验证规范关系,最终两头落空。
总结
在AI内容大爆发的当下,搜索引擎为了控制爬取和存储成本,对于低质、重复内容的收录门槛正在以肉眼可见的速度提高。URL规范化早已不是“选做题”,而是每个站点技术底层的“必答题”。合理且标准地部署规范标签,不仅能把零散的网页权重凝聚在一起,更能为搜索引擎爬虫建立清晰的抓取优先级。花半天时间自查一下站内的Canonical实现逻辑,你会发现,解决收录异常和流量分散的问题,有时候就是这么一个标签的距离。
相关文章
- 内链拓扑结构对百度蜘蛛抓取深度的影响:别让稀烂的内链,把百度蜘蛛挡在网站大门外
- 网站百度蜘蛛抓取量断崖式下跌原因剖析:百度蜘蛛不爬了?老站长教你排雷
- 智能DNS解析针对百度蜘蛛独立配置线路:别让延迟毁了收录,DNS分流实战
- 降低百度蜘蛛抓取耗时的服务器优化方案:百度蜘蛛抓取慢?老站长的服务器提速心法
- URL重写伪静态对百度蜘蛛抓取效率的影响:伪静态:别让URL毁了你的收录
- 黑帽蜘蛛池诱导抓取与正规SEO的区别:蜘蛛池诱导与正规SEO实战录
- 网站改版301重定向引导百度蜘蛛权重转移:网站改版301权重转移实战指南
- 百度小程序爬虫与普通网页蜘蛛抓取差异:小程序与网页蜘蛛抓取实战避坑
- 新站TDK标签规范设置:新站做SEO,TDK到底该怎么填
- 网站初期核心关键词挖掘与布局:新站选词难?手把手教你把词定准