
示例:使用 cURL 快速验证线上页面是否包含正确配置的 JSON-LD script 标签
在这份结构化数据辅助内容排名实录里,我直接说结论:结构化数据本身并不直接拉升搜索算法的底层权重分,它的本质是给搜索引擎算法喂“精加工数据”,通过夺取富媒体摘要(Rich Snippets)大幅提升搜索结果点击率(CTR),最终用完美的用户行为数据反哺并抬升搜索排名。
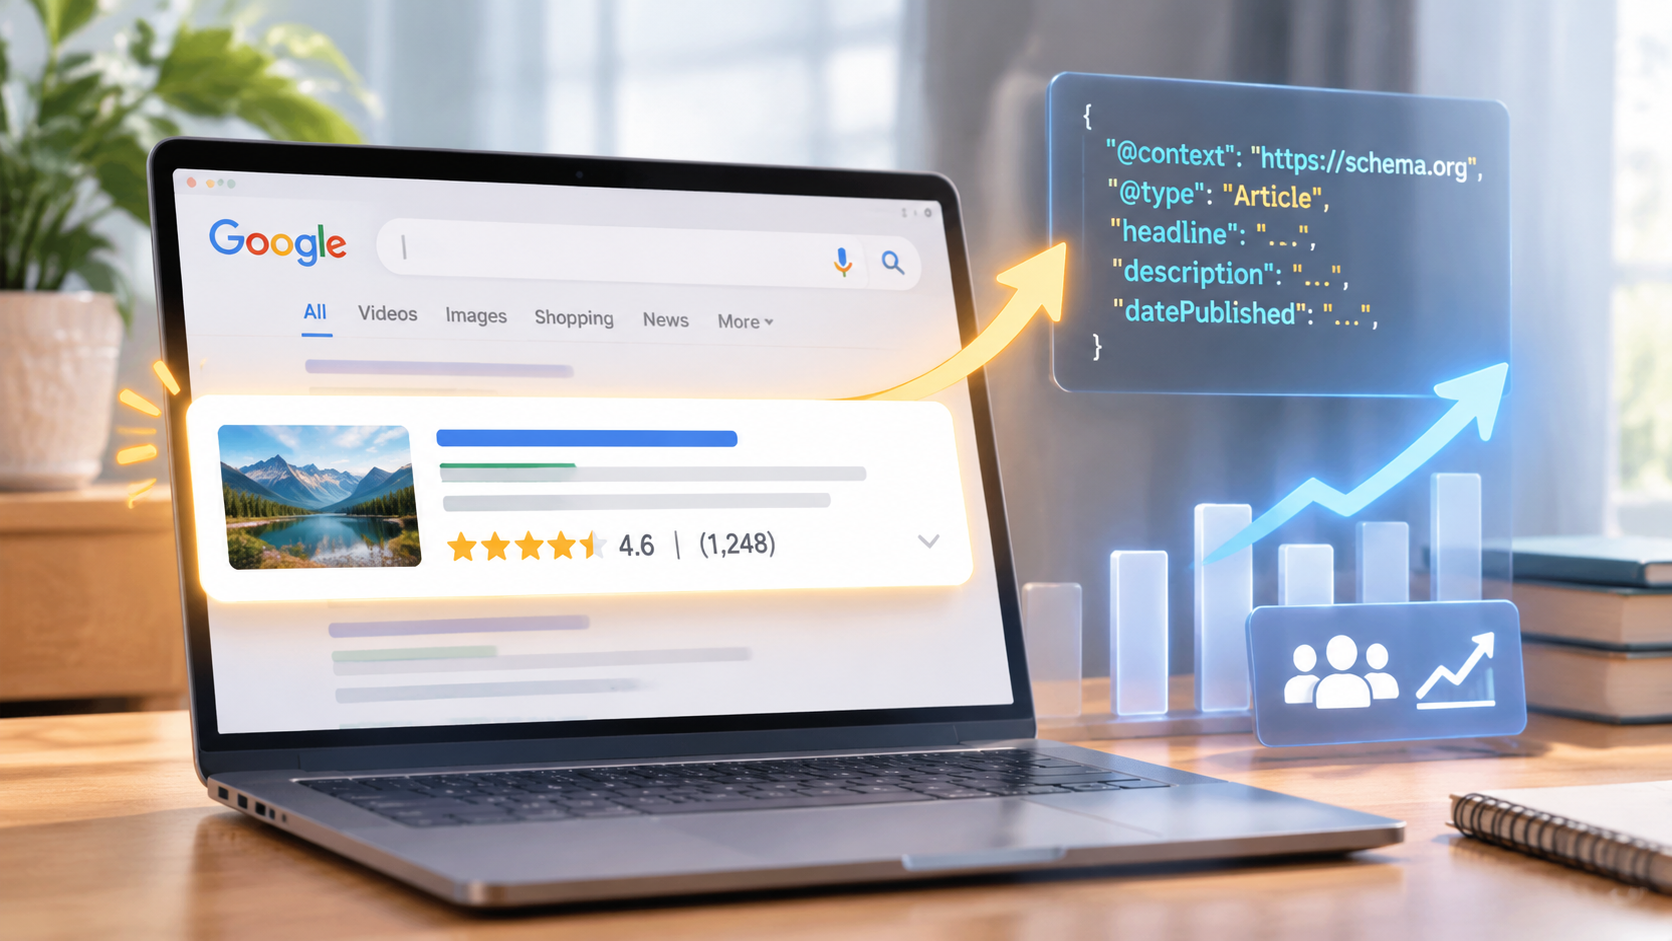
如果你还在死磕怎么写冗长的文章,却连基础的 JSON-LD 规范都没部署,相当于开着跑车挂一档拉客。下面我不讲任何脱离实际的概念,直接把这套在多个百万级流量站点上验证过的结构化数据落地方案、可直接套用的代码模板以及避坑指南砸给你。
一、 核心方案速览
想要靠结构化数据让内容排名跑出来,重点不是把 Schema.org 里的几百种类型全写一遍,而是精准适配页面类型,抓取极高视觉优先级的 SERP(搜索结果页)展示位。
针对主流业务场景,核心落地方案矩阵如下:
| 适用页面类型 | 核心 Schema 类型 | 目标 Rich Snippets 形式 | 预估 CTR 提升幅度 |
|---|---|---|---|
| 技术博客 / 知识库 / 资讯 | Article + FAQPage |
搜索结果下挂 FAQ 下拉收折框 | 20% - 35% |
| 工具 / SaaS 落地页 | SoftwareApplication / WebApplication |
评分星级、价格、平台版本角标 | 15% - 25% |
| 电商产品页 / 评测 | Product + AggregateRating + Offer |
价格、库存状态、星级评级 | 30% - 50% |
| 教程 / 操作指南 | HowTo |
步骤预览图、分步指导卡片 | 25% - 40% |
落地三步走执行路径:
- 结构抽取:使用
JSON-LD格式(Google/Bing 官方最推荐,不要用古老的 Microdata 或 RDFa)。 - 代码注入:直接打包进服务端渲染(SSR)的 HTML
<head>标签中,绝不要依赖客户端二次渲染注入(否则抓取时效性大打折扣)。 - 验证闭环:部署完成后,立即用 Google Rich Results Test 和 Search Console 进行校验。
二、 实操细节深度拆解
1. 高频场景:文章页 + FAQ 组合拳模板(最容易出效果)
在内容页中同时嵌入 Article 和 FAQPage 是目前抢占 SERP 版面面积最立竿见影的手法。通过把页面核心问题提取成 FAQ,可以直接在 Google 搜索结果里拉出 2-3 个下拉问答框,挤掉竞争对手的版面。
可直接套用的 JSON-LD 代码模板:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "TechArticle",
      "@id": "https://yourdomain.com/blog/nginx-performance-tuning/#article",
      "isPartOf": {
        "@type": "WebPage",
        "@id": "https://yourdomain.com/blog/nginx-performance-tuning/"
      },
      "headline": "Nginx高并发调优实战指南:从Worker配置到内核参数",
      "description": "深入拆解Nginx在高并发场景下的性能瓶颈,提供可直接套用的worker_processes、epoll及Linux内核参数配置代码。",
      "inLanguage": "zh-CN",
      "mainEntityOfPage": "https://yourdomain.com/blog/nginx-performance-tuning/",
      "datePublished": "2023-10-15T08:00:00+08:00",
      "dateModified": "2023-10-20T10:30:00+08:00",
      "author": {
        "@type": "Person",
        "name": "老张",
        "url": "https://yourdomain.com/author/laozhang/"
      },
      "publisher": {
        "@type": "Organization",
        "name": "运维实战技术站",
        "logo": {
          "@type": "ImageObject",
          "url": "https://yourdomain.com/assets/logo.png"
        }
      }
    },
    {
      "@type": "FAQPage",
      "@id": "https://yourdomain.com/blog/nginx-performance-tuning/#faq",
      "mainEntity": [
        {
          "@type": "Question",
          "name": "Nginx worker_processes 应该设置为多少?",
          "acceptedAnswer": "
            "@type": "Answer",
            "text": "通常建议设置为 CPU 的物理核心数(可通过 nproc 命令查看)。在 Nginx 1.25+ 中可以直接配置为 worker_processes auto; 让系统自动绑定。"
          }
        },
        {
          "@type": "Question",
          "name": "修改 Nginx 配置后如何实现无缝热加载?",
          "acceptedAnswer": "
            "@type": "Answer",
            "text": "使用 nginx -t 检查语法无误后,执行 nginx -s reload 或 systemctl reload nginx 命令即可,此时主进程会拉起新 worker 处理新请求,旧 worker 处理完现有连接后自动退出。"
          }
        }
      ]
    }
  ]
}
</script>
2. 前端单页面应用(SPA/React/Vue)动态注入方案
如果是 SSR(如 Next.js/Nuxt.js),直接放在页面组件根部即可。如果是纯前端渲染项目,必须在页面 DOM 完成挂载前将 Script 注入到 <head> 中,否则蜘蛛可能爬不到。
React/Next.js 标准注入写法语示(使用 Next.js Head 组件):
import Head from 'next/head';

export default function BlogPost({ articleData, faqData }) {
  const schemaData = {
    "@context": "https://schema.org",
    "@graph": [articleData, faqData]
  };

  return (
    <>
      <Head>
        <title>{articleData.headline} - 运维实战技术站</title>
        <script
          type="application/ld+json"
          dangerouslySetInnerHTML={{ __html: JSON.stringify(schemaData) }}
        />
      </Head>
      <main>
        {/* 页面正文内容 */}
      </main>
    </>
  );
}
3. 致命踩坑经验(血的教训)
在实际部署中,我见过太多站长代码校验全是绿勾,但等了几个月硬是不出富媒体摘要,甚至被搜索引擎下发人工判罚。原因大多出在以下三点:
- 避坑点一:隐匿内容陷阱(Hidden Content Penalty)
你在 JSON-LD 的
FAQPage里写了 5 个问答,但为了让页面看起来简洁,你在前端页面上用 CSS(比如display: none)把这些问答隐藏了。Google 极其讨厌这种作弊行为。规则很干脆:JSON-LD 展现的每一个字符,必须在页面渲染后对普通用户可见。 - 避坑点二:数据不一致(Data Mismatch)
产品页 JSON-LD 里标注的价格是
$19.99,但页面 HTML 文本因为促销改成了$14.99。这种价格或评分数据不一致会导致搜索引擎直接抹掉你的富媒体展示资格。 - 避坑点三:全局通用模板硬套(Over-generalization)
直接在网站全站全局 Footer 注入一套固定的
Organization或WebSiteSchema。这纯属浪费字节,搜索算法需要的是具体页面主体内容的细粒度结构化,不是全站通用的空话。
三、 高频关联问题拓展
Q1:结构化数据验证通过,搜索结果里为什么依然没有 Rich Snippets?
答: 校验通过(Valid)仅代表你的语法符合 Schema 规范,绝不等于搜索引擎保证展示。 Rich Snippets 是否展示受以下三个因素控制:
- 站点基础信任度(Authority):新站或权重极低的站点,就算 Schema 写得再完美,Google 也不一定给展示位。先跑通优质内容,提升站点收录和基础权重。
- 搜索意图匹配(Search Intent):如果用户搜索的是“Nginx 是什么”,算法倾向于展示维基百科卡片;只有用户搜索“Nginx 怎么配置”这种操作类意图时,
HowTo或FAQPage的展示概率才会飙升。 - 重新抓取延迟:修改结构化数据后,需要等待搜索引擎重新 Crawl 并 Re-index 页面。可以去 Search Console 手动提交
URL Inspection -> Request Indexing加快进度。
Q2:百度搜索引擎对 JSON-LD 的支持度到底怎么样?
答: 别听信网上某些教程说“百度不支持 JSON-LD”。百度早在几年前就已经全面转向对 JSON-LD 标准的支持。虽然百度 SERP 的富媒体卡片展示逻辑比 Google 更保守(更偏向给予百家号或自家产品),但规范的 JSON-LD 能极大帮助百度 Spider 准确提取页面的发布时间(datePublished)、作者(author)和正文主体,避免百度把评论区的内容误判为页面正文。
Q3:如何批量监控全站结构化数据的健康度?
答: 依靠手动去 Google 富媒体测试工具一个页面一个页面敲网址是极其低效的。生产环境的监控排查思路如下:
- 搜索控制台监控:直接看 Google Search Console 左侧菜单的 “增强”(Enhancements) 板块。如果你的
FAQ、Article或Product代码有问题,这里会直接报错并指出错误具体的行数和缺少的必要字段(如缺少image或priceValidUntil)。 - 爬虫工具自检:使用 Screaming Frog SEO Spider 等工具对全站进行抓取,在配置项里开启
Structured Data -> JSON-LD提取。抓取完成后直接导出所有报错 URL,重点排查是否存在缺失必填项(Missing Required Fields)的页面。
# 示例:使用 cURL 快速验证线上页面是否包含正确配置的 JSON-LD script 标签
curl -sL "https://yourdomain.com/blog/nginx-performance-tuning/" | grep -A 20 "application/ld+json"
四、 结尾总结
别再把结构化数据当成什么深不可测的 SEO 秘籍,它的底层逻辑极其简单:降低搜索引擎蜘蛛解析你网站内容的计算成本。
你把数据清洗得越干净、结构标得越清晰,算法就越愿意给你流量。在实践过程中,切记遵循以下四条铁律:
- JSON-LD 为唯一指定格式,放弃老旧的 Microdata。
- 页面可见内容必须与 JSON-LD 字段绝对一致,杜绝隐藏文本。
- 主攻 Article + FAQPage / Product 高收益组合,不浪费精力写无用标签。
- 上线必跑 GSC 校验,出现错误红牌第一时间修复。
把这几步踏踏实实落地,你的搜索点击率(CTR)和 SERP 版面占有率自然会给你最直接的反馈。
相关文章
- 示例:使用 cURL 快速验证线上页面是否包含正确配置的 JSON-LD script 标签
- 找出 /var/lib/docker/containers/ 下体积排名前 10 的日志文件
- Role: 资深技术/行业专家兼内容重构编辑
- 站内专题页面的SEO权重分配:专题页SEO权重分配实战指南
- 解决网站跳出率过高的内容策略:干掉网站高跳出率的硬核内容策略
- 如何挖掘高转化的SEO选题:高转化SEO选题挖掘实操指南
- 英文站Blog引流实战避坑指南
- 搜索引擎算法对优质内容的判别标准:拆解搜索引擎优质内容判别标准
- B2B外贸独立站Topic Cluster内容矩阵搭建实操:外贸独立站Topic Cluster实战手册
- 产品详情页(Product Page)如何写SEO描述摆脱同质化:独立站产品页SEO描述实战拆解