
网站内链结构设计想引导爬虫深度抓取,核心就一句话:用扁平化的网状拓扑替代树状单向链,保证全站95%以上的内容从首页点击不超过3次,并通过动态循环模块把冷门长尾页强行塞进爬虫每次必经的抓取路径里。
网站内链结构设计想引导爬虫深度抓取,核心就一句话:用扁平化的网状拓扑替代树状单向链,保证全站95%以上的内容从首页点击不超过3次,并通过动态循环模块把冷门长尾页强行塞进爬虫每次必经的抓取路径里。
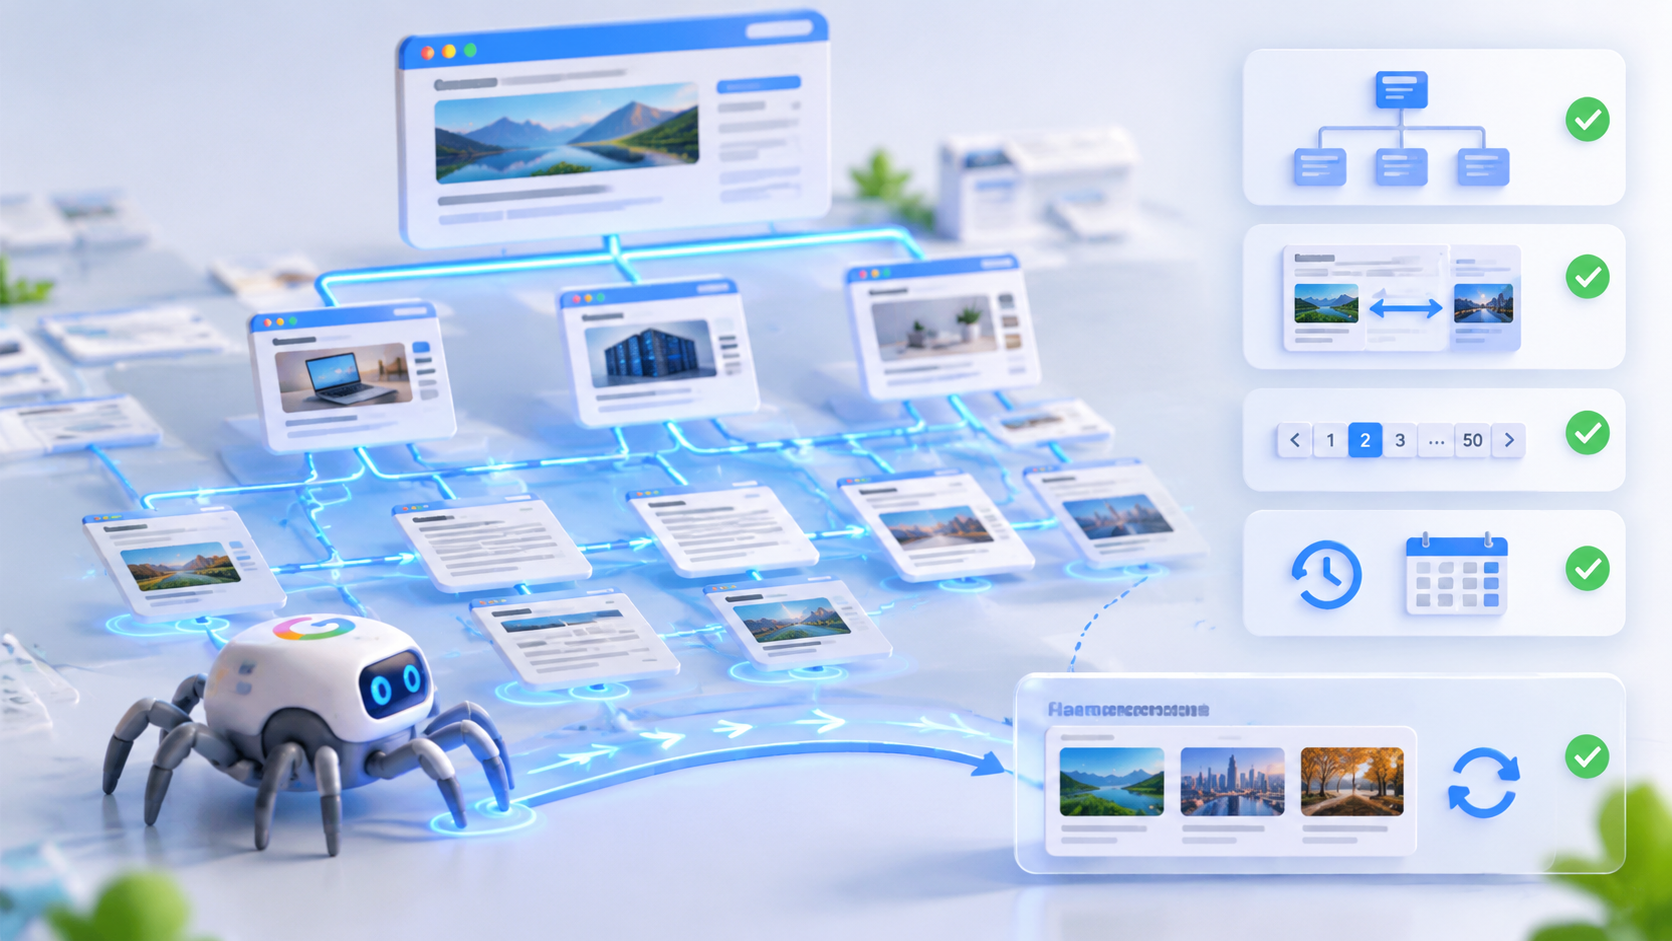
很多站点内容量几十万,搜索引擎索引量却卡在几千动弹不得,90%不是因为内容差,而是内链结构做得稀烂——爬虫顺着链接爬了两层就遇到死胡同,或者深层页面被埋在第十几层分页后面,配额(Crawl Budget)直接在浅层耗尽,根本走不到底层。
一、 核心方案速览
引导爬虫深度抓取的内链体系,本质是在有限的抓取配额内,让爬虫以最低的链路成本跑完最大的有效面积。核心打法分四步:
- 扁平化层级控制:执行“首页 -> 核心聚合/专题页 -> 内容详情页”的极简3跳逻辑,严防目录深不见底。
- 上下文语义闭环:正文锚文本不玩随机匹配,按“父子级+兄弟级”做双向锚定,拒绝单向输送。
- 消除孤岛与断头路:所有终端详情页必须自带“轮换推荐”或“相关Tag”,让爬虫永远有下一个
<a>标签可走。 - 静态化分页与倒序索引:干掉纯前端AJAX滚动加载,给爬虫保留清晰、带参数标记的标准HTML分页链路。
二、 实操细节深度拆解
1. 结构化面包屑:给爬虫打通纵向“电梯”
很多开发者用JavaScript或者CSS伪元素画了个好看的面包屑,但在HTML源码里根本没有语义,爬虫根本不吃这套。必须使用带Schema.org结构化数据的纯HTML链路,这样爬虫不仅能从深层逆向抓回上级,还能帮你在搜索结果里拿下富媒体展示位。
直接套用标准JSON-LD或Microdata格式(推荐直接内嵌在DOM结构中的Microdata,兼容性最好):
<!-- 直接嵌入DOM的标准语义面包屑 -->
<nav aria-label="Breadcrumb">
  <ol itemscope itemtype="https://schema.org/BreadcrumbList" class="breadcrumb-nav">
    <li itemprop="itemListElement" itemscope itemtype="https://schema.org/ListItem">
      <a itemprop="item" href="https://example.com/">
        <span itemprop="name">首页</span>
      </a>
      <meta itemprop="position" content="1" />
    </li>
    <li itemprop="itemListElement" itemscope itemtype="https://schema.org/ListItem">
      <a itemprop="item" href="https://example.com/linux/">
        <span itemprop="name">运维实战</span>
      </a>
      <meta itemprop="position" content="2" />
    </li>
    <li itemprop="itemListElement" itemscope itemtype="https://schema.org/ListItem">
      <span itemprop="name" aria-current="page">Nginx高并发调优配置详解</span>
      <meta itemprop="position" content="3" />
    </li>
  </ol>
</nav>避坑点:面包屑的最后一级(当前页面)不要加自身超链接,纯文本展示即可。加了不仅浪费权重,还会让爬虫在这里做无意义的死循环请求。
2. “相关推荐”算法改造:把死胡同改成换乘站
终端内容页最容易变成“抓取断头路”。很多CMS自带的“相关推荐”逻辑极其死板——要么按照发布时间倒序,要么固定推荐同分类下的前6篇文章。结果就是:老文章再也见不到天日,新文章只有几篇能被爬到。
必须让相关推荐变成一个动态抓取循环池。 推荐池的查询逻辑应该混合“标签关联度”与“抓取权重较低的随机冷门页”:
-- 推荐模块的伪SQL实现思路:混入一定比例的高分未收录/冷门长尾内容
(
  -- 优先抓取相同Tag的相关页面(保证语义强相关)
  SELECT id, title, slug FROM articles
  WHERE tag_id = 105 AND id != 12345
  ORDER BY views DESC
  LIMIT 4
)
UNION ALL
(
  -- 混入2篇同大分类下、发布时间较久或被爬取频次低的“冷页面”(引导深度抓取)
  SELECT id, title, slug FROM articles
  WHERE category_id = 3 AND id != 12345
  ORDER BY crawl_count ASC, id DESC
  LIMIT 2
);
正文结尾再挂一个“上一篇 / 下一篇”模块。注意,这两个链接必须限制在当前子分类内,不要做全站跨分类的上下篇,否则爬虫在你的网站里跳跃度太大,无法形成特定垂直主题的权重聚集。
3. 分页链接优化:别用纯前端瀑布流坑死爬虫
很多现代网站为了用户体验,列表页全用AJAX + 滚动无限加载。前端工程师觉得挺爽,SEO人员直接原地哭晕。Google虽然能跑一部分无头浏览器渲染,但对于需要触发滚动事件的接口,爬虫通常直接跳过,下面的几万篇内容彻底沉底。
底线规则:页面DOM里必须有标准的href分页锚文本。
<!-- 爬虫能抓的分页结构必须长这样 -->
<div class="pagination">
  <a href="/category/DevOps?page=1" rel="prev">上一页</a>
  <a href="/category/devops?page=1">1</a>
  <span class="current">2</span>
  <a href="/category/devops?page=3">3</a>
  <a href="/category/devops?page=4">4</a>
  <!-- 跨度跳转,给深层页面提供抓取跳板,而不是只能一页一页翻 -->
  <a href="/category/devops?page=50">50</a>
  <a href="/category/devops?page=3" rel="next">下一页</a>
</div>针对大型站点(百万级页面),列表分页超过100页以后,爬虫很少往后翻了。此时可采用反向时间索引归档:
- 按年份/月份归档:
/archive/2023/10/ - 让深层老文章通过归档页直接缩短点击距离,把100步的翻页缩短到2步内。
4. 黄金三角正文内链:自然穿插,杜绝软件强塞
市面上很多站长工具喜欢玩“正文关键词自动批量打标”,只要出现“服务器”三个字就全站强行加超链接。这种机械操作不仅极易触发搜索引擎的算法惩罚,而且爬虫分析正文语义时会直接判定为垃圾链接农场。
正确的操作是在撰写内容时按需埋点,采用“三角闭环”策略:
- A页面(新发布长尾页) -> 链接指向 -> B页面(核心聚合专题页):给主干页面输送权威度。
- B页面(核心聚合专题页) -> 目录收录 -> A页面(新长尾页):借助高权重页面为新页面引蜘蛛。
- C页面(已有稳定排名的老页面) -> 手动追加链接指向 -> A页面(新长尾页):老带新,实现爬虫配额传导。
锚文本写法规范对比:
- 错误写法:了解更多请[点击这里]。(爬虫无法通过锚文本识别目标页面的主题)
- 错误写法:[高防服务器哪家好高防服务器价格高防服务器租用]。(堆砌长尾词,直接判降权)
- 正确写法:在配置反向代理时,可参考我们之前总结的[Nginx负载均衡五种调度算法配置]。(语义严密,锚文本与目标页H1强吻合)
三、 高频关联问题拓展
Q1:单页内链塞多少个最合适?会不会稀释权重?
答:行业通用规则是单个页面内的有效链接数控制在 100 - 200 个以内。超过这个阈值,单个链接分到的抓取权重(PageRank值)就会严重缩水,而且爬虫很可能在解析超长DOM树时超时放弃。
如果你做的是大中型门户站,导航栏通常就占掉了60个链接,那留给正文和相关推荐的坑位也就40-50个,切忌把无意义的页脚标签云(几百个Tag)挂在每个页面底部,那纯属自残。
Q2:内部链接需要加 rel="nofollow" 吗?
答:早年站长喜欢用 nofollow 来做“PageRank雕刻(PageRank Sculpting)”,现在这套早过时了。对于现代搜索引擎,你给内链加 nofollow,权重不是转移给其他链接,而是直接蒸发。
目前内链唯一建议加 nofollow 的场景只有:
- 登录、注册、找回密码页面;
- 购物车、用户个人中心;
- 站内搜索结果页(必须加,防止生成海量低质死循环URL耗死配额);
- 隐私政策、服务条款等无搜索价值的说明页。
Q3:SPA单页应用(Vue/React)如何让爬虫识别内链?
答:必须做SSR(服务端渲染)或静态预渲染(SSG)。
纯客户端路由用的是 history.pushState 或 Hash 模式(/#/detail/1),爬虫抓回来的初始HTML只有一个空壳<div id="app"></div>。
如果重构成SSR成本太高,退而求其次的解决方案是在服务端用 Prerender(如 prerender.io 或无头Puppeteer) 搞一层中间件:检测到请求头里的 User-Agent 是百度、Google、Bing等爬虫时,直接把渲染好的完整HTML输出给它,确保源码里全都是带真实 href 的 <a> 标签。
四、 落地自查清单(Checklist)
完成网站内链结构设计调优后,抓取日志(Access Log)是最直观的检验工具。上线后对照以下清单逐项排查:
- [ ] 看代码:禁用浏览器JavaScript后刷新页面,检查导航、面包屑、正文推荐链接是否全都在,能不能正常点击跳转。
- [ ] 看层级:用Screaming Frog或相关抓取软件扫一遍全站,检查“Crawl Depth(抓取深度)”,超过4层的页面占比必须低于5%。
- [ ] 查孤岛:全站是否存在没有任何内链指向的单页(Orphan Pages),确保所有新发布内容至少有2个以上的站内入口。
- [ ] 看日志:分析Nginx访问日志里的Spider状态码,如果爬虫频繁在某一类带参动态分页上返回200,但对应内容毫无索引价值,果断在
robots.txt把它干掉,把有限的配额省给底层内容页。