
静态资源防盗链逻辑
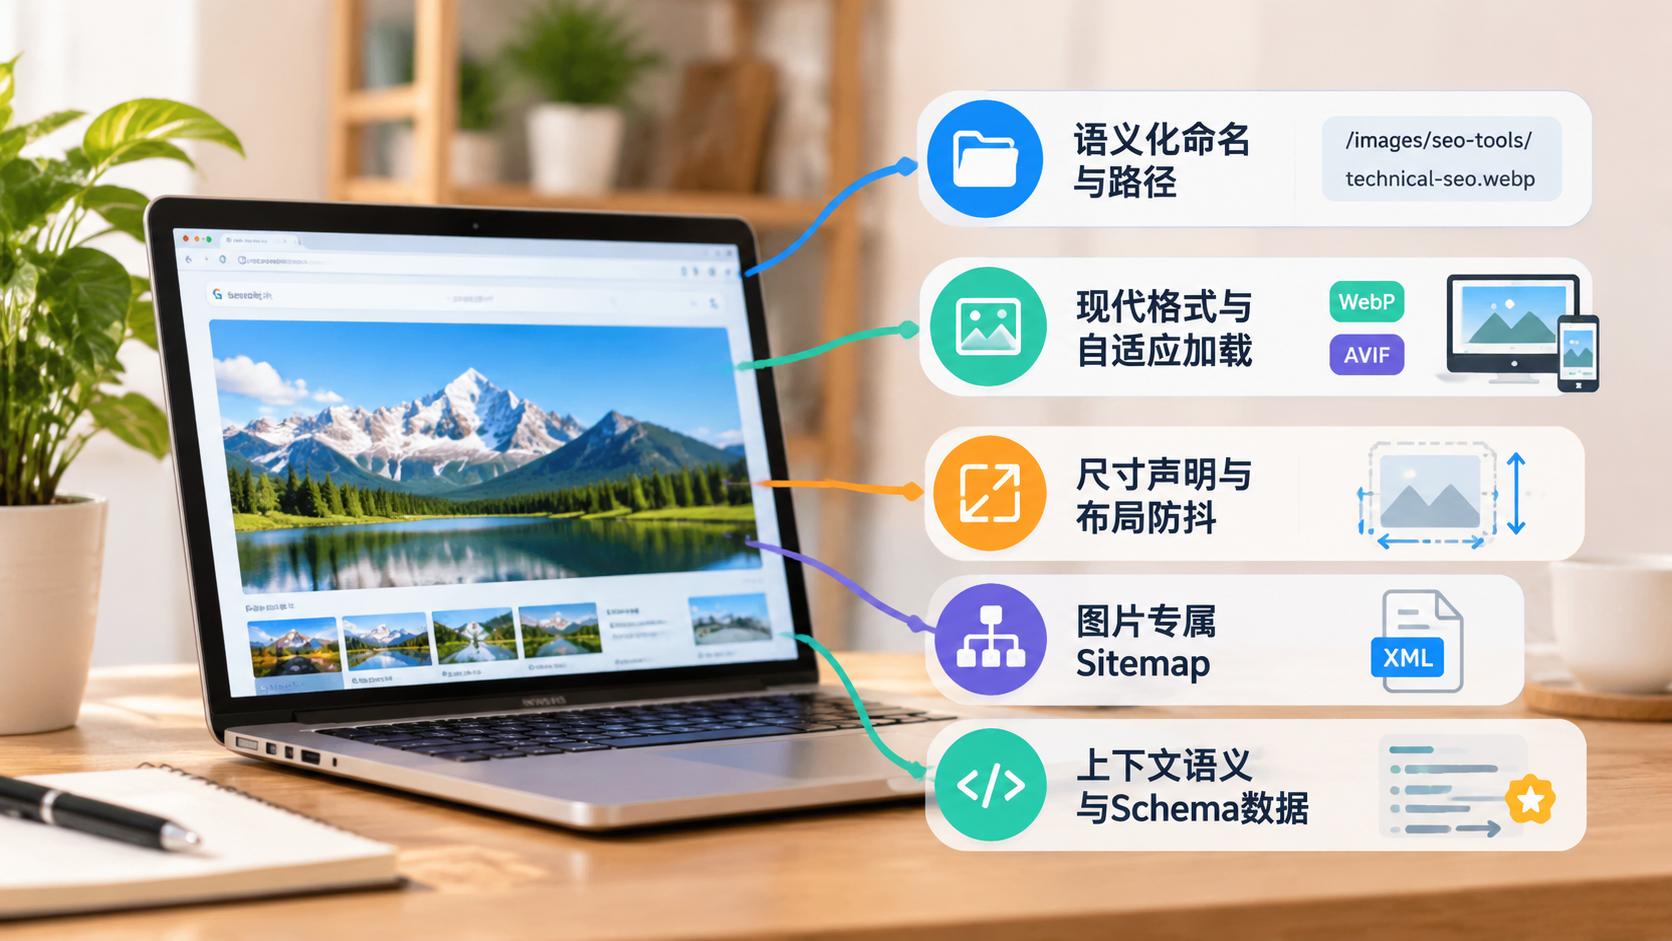
搞网站图片SEO除了Alt标签还需要优化的五个维度,核心结论就一句话:别以为填了Alt属性就万事大吉,搜索引擎看图片早就不单盯一个标签了,真正决定你图片能不能进Google Images前排、能不能给网页加权且不拖垮LCP分数的,是文件语义化命名、现代格式与自适应加载、防抖尺寸硬编码(CLS优化)、专属图片XML站点地图,以及上下文语义与Schema结构化数据这五个硬核维度。
很多做网站的、搞出海独立站的,甚至干了几年SEO的老手,日常传图就是后台一传,文件名还是类似于 IMG_20240321_092118.png 或者一串毫无意义的哈希MD5 e3b0c44298fc1c149afb.webp,然后自我安慰“反正是给机器看的,我填了Alt标签就行”。大错特错!在机器视觉和爬虫眼里,图片资产是一个整体,光靠Alt那是残废版的优化。
一、 核心方案速览
| 优化维度 | 核心解决问题 | 关键操作手段 | 预期收益 |
|---|---|---|---|
| 1. 语义化命名与路径 | 初始相关性识别 | 英文横杠连字符命名,抛弃无意义字符 | 提升抓取权重,进入图片搜索初始召回池 |
| 2. 格式与响应式适配 | 体积与加载性能(LCP) | WebP/AVIF格式转型,使用<picture>和srcset |
体积减少40%~70%,提升网页加载速度分 |
| 3. 尺寸声明与布局防抖 | 视觉稳定性(CLS) | 硬编码width/height配合CSS aspect-ratio |
彻底解决图片加载时的版面抖动(CLS直接归零) |
| 4. 图片专属Sitemap | 深层资源索引率 | 提取全站图片构建<image:image>专属XML并提交 |
解决JS懒加载导致的漏爬,强迫爬虫收录 |
| 5. 上下文与Schema数据 | 语义理解与富媒体展示 | <figure>包裹,嵌入ImageObject结构化代码 |
获得搜索结果Rich Results展示特权 |
二、 实操细节深度拆解
维度一:语义化文件命名与目录规划(别拿MD5忽悠爬虫)
搜索引擎爬虫抓取一张图片时,在下载解析它的像素和Alt之前,第一个读到的就是URL字符串本身。把图片扔进没有深度的无序路径或者用一串乱码当文件名,等于直接放弃了最底层的相关性评分。
- 适用场景:所有静态页面、文章插图、电商产品图。
- 避坑指南:严禁用中文直接作为文件名(服务器URL编码后会变成又长又臭的
%E5%9B%BE%E7%89%87),严禁使用下划线_(Google建议使用短横线-作为单词分隔符),严禁用无意义自增ID。 - 实操规则:
- 错误示范:
/uploads/2024/05/pic_01.jpg、IMG10023.png - 正确示范:
/images/seo-tools/technical-seo-audit-checklist.webp
- 错误示范:
- 落地动作: 如果你是用WordPress,可以通过钩子在上传时把非语义名拦截掉;如果是自己写前后端,务必在后台上传模块加入“重命名规则”。
维度二:现代图片格式与自适应加载(死磕LCP性能指标)
如果你的网页上还充斥着动辄2MB的PNG大图,再好的Alt也救不了你的跳出率。图片加载慢直接拖垮Core Web Vitals中的LCP(最大内容绘制时间),而LCP直接是Google排名算法的重要因子。
- 技术选型:优先使用WebP(目前浏览器兼容度98%以上),超高清大图优先使用AVIF(压缩率比WebP还要高20%~30%,但老旧系统有些许兼容问题,需做Fallback)。
- 避坑指南:直接用
<img>写一个固定的WebP不是最佳做法。桌面端加载2000px的图给手机端看,就是纯纯的流量浪费和降权行为。 - 直接套用代码:使用HTML5的
<picture>标签配合媒体查询,提供兜底方案和自适应分辨率。
<picture>
  <!-- 优先给现代浏览器提供极高压缩比的 AVIF -->
  <source type="image/avif"
          srcset="/img/cloud-server-architecture-400.avif 400w,
                  /img/cloud-server-architecture-800.avif 800w"
          sizes="(max-width: 600px) 400px, 800px">

  <!-- 兼容备选:WebP 格式 -->
  <source type="image/webp"
          srcset="/img/cloud-server-architecture-400.webp 400w,
                  /img/cloud-server-architecture-800.webp 800w"
          sizes="(max-width: 600px) 400px, 800px">

  <!-- 极老旧浏览器兜底,防止开天窗,同时Alt打底 -->
  <img src="/img/cloud-server-architecture-800.jpg"
       https://wl5.net/tag-28.html"  target="_blank">高并发场景下的云服务器分布式架构图"
       loading="lazy"
       decoding="async">
</picture>
注:首屏大图(Hero Image)千万不要加 loading="lazy",加了会严重延后渲染时间,导致LCP爆红,首屏图必须默认直出!
维度三:显式尺寸声明与CLS灭绝计划(干掉页面跳动)
很多前端工程师喜欢在CSS里直接写个 width: 100%; height: auto;,HTML里的width和height属性留空。这种写法在图片还没下载完时,浏览器不知道它的高宽比,只能给它分配0高度;等图片一出来,下面的文字“啪”一下被顶下去,这就是典型的CLS(累计布局偏移)。一旦CLS得分低于0.1,页面的技术评分就会大打折扣。
- 核心原理:在HTML中显式声明原始像素宽高比,让浏览器在未下载图片前就提前锁定布局占位。
- 实操代码: HTML上老老实实把图片的原始宽高写死,样式的适配交给CSS控制:
<!-- HTML层必须写死物理尺寸,浏览器靠它计算高宽比预留占位 -->
<img src="/img/database-indexing-guide.webp"
     width="1200"
     height="675"

     class="responsive-img">
/* CSS层控制响应式,现代浏览器通过HTML宽高比自动维持占位 */
.responsive-img {
width: 100%;
height: auto;
/* 如果是老旧布局,可以用现代css属性 aspect-ratio 双保险 */
aspect-ratio: 16 / 9;
display: block;
}维度四:配置专属图片Sitemap(拯救深层懒加载)
做全站静态化或者做单页面应用(SPA)时,大量的图片都依赖JS懒加载(通过data-src替换)。搜索引擎蜘蛛抓取能力再强,也经常懒得去完整执行你那些复杂的滚动监听JS脚本。结果就是你的页面被收录了,但页面里的图片一张都没进索引库。
- 解决方案:单独生成或者在现有的XML站点地图中补充
<image:image>专属标签,直接“喂饭”给蜘蛛。 - 标准格式模板(直接套用):
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"
        xmlns:image="http://www.google.com/schemas/sitemap-image/1.1">
  <url>
    <loc>https://www.yourdomain.com/blog/linux-performance-tuning</loc>
    <!-- 可以在一个URL节点下塞入多个图片节点 -->
    <image:image>
      <image:loc>https://www.yourdomain.com/images/linux-io-troubleshooting.webp</image:loc>
      <image:title>Linux性能排查IO瓶颈拓扑图</image:title>
      <image:caption>详解iotop与iostat分析磁盘IO等待的具体步骤与图解</image:caption>
    </image:image>
    <image:image>
      <image:loc>https://www.yourdomain.com/images/linux-kernel-diagram.webp</image:loc>
      <image:title>Linux内核参数优化流程</image:title>
    </image:image>
  </url>
</urlset>操作步骤:生成后在Google Search Console或百度搜索资源平台提交该Sitemap。此操作对电商站有奇效,上千款SKU图片的收录速度能翻倍。
维度五:上下文语境强化与Schema结构化数据
搜索引擎不是单看图片,它把图片看作页面内容的一部分。如果你的图片孤零零地插在两个无关的<div>中间,爬虫很难给它赋予权威度。利用语义化标签将文本与图片强制绑定,配合JSON-LD结构化标记,是直接拿下SERP图文混排摘要(Featured Snippet)的杀手锏。
- 页面HTML语义化布局:
<figure>
  <img src="/img/Redis-cluster-architecture.webp"
       width="800"
       height="450"
       https://wl5.net/tag-19.html"  target="_blank">Redis集群分片与主从复制高可用架构">
  <!-- 爬虫会高度抓取figcaption作为图片直接上下文定义 -->
  <figcaption>图1-1:三主三从架构下的Redis Cluster分布式数据同步机制</figcaption>
</figure>- JSON-LD结构化代码(页面Head内植入): 尤其是产品图、菜谱、教程步骤图,必须用Schema告诉搜索引擎“这张图代表什么”。
<script type="application/ld+json">
{
  "@context": "https://schema.org/",
  "@type": "ImageObject",
  "contentUrl": "https://www.yourdomain.com/img/redis-cluster-architecture.webp",
  "license": "https://www.yourdomain.com/license",
  "acquireLicensePage": "https://www.yourdomain.com/how-to-use-images",
  "creditText": "技术实战运维基地",
  "creator": {
    "@type": "Person",
    "name": "运维老胡"
  },
  "description": "详解生产环境下Redis集群高可用配置与容灾方案"
}
</script>
三、 高频关联问题拓展(踩坑排错实录)
坑点 1:加了图片防盗链,结果把搜索引擎蜘蛛也给“防”出去了
很多运维为了省流量,在Nginx或者CDN控制台直接开防盗链(Referer防盗链)。经常有人配置完了发现,图片搜索流量直接跳水。
- 排查思路:爬虫抓取图片时,通常不带Referer,或者带的是搜索引擎自己的域(如
google.com、baidu.com)。 - Nginx正确配置写法:
# 静态资源防盗链逻辑
location ~* \.(jpg|jpeg|png|gif|webp|avif)$ {
    # 必须允许无 Referer (blocked),且加白主流蜘蛛的域名
    valid_referers none blocked server_names
                   *.google.com
                   *.googlebot.com
                   *.baidu.com
                   *.bing.com
                   *.yourdomain.com;
    if ($invalid_referer) {
        return 403;
    }
}
坑点 2:开源框架自带的JS懒加载让蜘蛛抓了个寂寞
不少人还在用好几年前的jQuery Lazyload或者老的Vue指令插件,渲染出来的HTML是:
<img data-src="/real-image.jpg" src="/placeholder.png">。
- 实操避坑:现在的Googlebot和现代爬虫早就支持浏览器原生的Lazyload。直接扔掉任何依赖DOM滚动的JS插件,全部改用原生属性:
<img src="/real-image.jpg" loading="lazy">。原生方案对现代蜘蛛没有任何门槛,不会造成异步加载抓取缺失。
坑点 3:打高强度盲水印/大字水印是否影响收录?
直接说结论:过度加水印不仅拉低用户体验,而且会被视觉算法判定为低质量垃圾资源。 Google的视觉模型能精准识别水印所占的画面比例。边缘处一行小字不影响识别;如果全屏铺满“某某网站版权所有”的倾斜半透明大图,这种图片大概率直接从Google Image的“高清推荐”和顶部流中被剔除。建议只在右下角做轻量化、小字号的品牌标记。
四、 总结
把这五个维度的逻辑打通,你会发现网站图片SEO除了Alt标签还需要优化的五个维度并不是孤立的玄学技巧,而是一套闭环工程:
- 文件名称与路径,从URL层面在被抓取的一瞬间给爬虫明确的“语义初速度”;
- WebP/AVIF及自适应语法,负责在速度和体积层面干掉加载阻塞,保住LCP的核心性能分;
- 宽高硬编码,直接锁定DOM骨架,干翻页面闪烁的CLS评分硬伤;
- 图片XML Sitemap,负责用工业化手段给深层懒加载的图片开辟绿色直通车,不漏一张图;
- 上下文与Schema,把视觉信息和页面核心知识图谱焊死在一起,去抢夺搜索结果里的富媒体卡位。
做完这套动作,再回过头去把Alt标签当作一个“兜底文字说明”自然地填好,你的图片优化才算真正从表面文章进阶到了生产级别的工程化落地。即刻按照文中的代码和配置改写你的站点,收录和性能表现会给出最直观的正反馈。