
百度SEO与Google SEO核心算法逻辑区别拆解:百度与Google SEO算法实操拆解
百度SEO与Google SEO核心算法逻辑区别的本质,就是“强中心化的规则审查与资源倾斜”对撞“去中心化的语义理解与真实体验投票”——做百度你得优先伺候好蜘蛛抓取配额、ICP备案、高频API推送和合规聚合,做Google你必须死磕E-E-A-T(经验、专业、权威、可信)、深度意图覆盖、技术性能指标(Core Web Vitals)与真实反向链接。搞混这套底层逻辑,拿做Google的思路做百度,你会发现收录都成问题;拿做百度的野路子做Google,直接被算法沙盒按在地上摩擦。
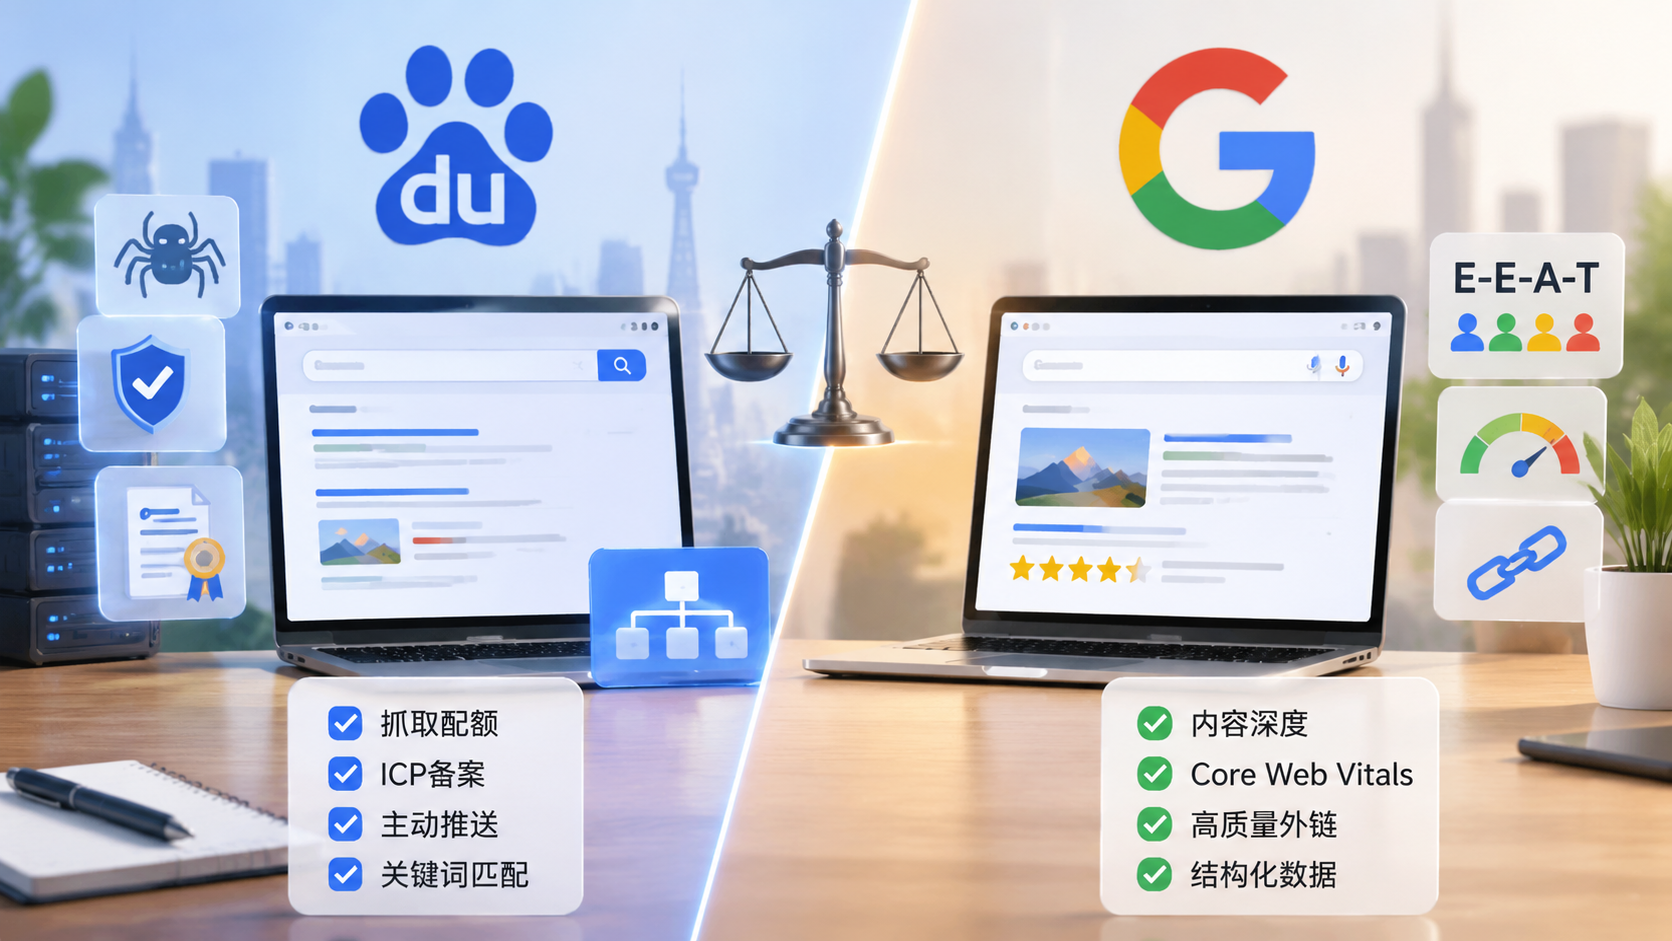
核心方案速览
别听某些“SEO大师”扯什么“搜索引擎底层都一样”的鬼话。在技术选型和运营动作上,两者的执行策略必须物理隔离:
| 维度 | 百度 SEO 核心打法 | Google SEO 核心打法 |
|---|---|---|
| 抓取/渲染 | 必须做服务端渲染(SSR)或预渲染(Prerender),别指望Baiduspider能稳定执行JS | Googlebot能完整渲染现代JS单页,但仍需保证首屏秒开与流式传输 |
| 收录机制 | 被动等待基本等于放弃,全靠API主动推送接口抓取配额,看重域名备案与存活历史 | 靠Sitemap与内部链接自然爬取即可,新站有严格的沙盒期(Sandbox)审查 |
| 语义与内容 | 强依赖Title精准匹配、H标签、TF-IDF分词权重,打击飓风/细雨/清风等规则漏洞 | 深度依赖RankBrain/BERT/MUM,看重搜索意图(Search Intent)覆盖与长尾解答 |
| 外链与信任 | 绿萝算法后外链直接权重缩水,行业大站友链/高权重门户单向锚文本依然管用 | 外链(Backlinks)仍是第一护城河,看重相关性、DOFOLLOW传递、自然锚文本多样性 |
| 结构化数据 | 搜索资源平台特有提交规范,开放生态支持弱,偏向官方小程序/合作卡片 | 严格遵循Schema.org的JSON-LD规范,直接影响Rich Results(富媒体摘要)展现 |
实操细节深度拆解
1. 抓取与技术层:JS渲染与爬虫区别
Google早就是Evergreen爬虫,自带Chromium最新渲染引擎;百度的Baiduspider官方虽然吹能跑JS,但线上实测,超过1.5MB的动态Bundle包,百度蜘蛛大概率超时丢弃,抓出来的快照经常是一片空白。
落地配置:Nginx 分流动态预渲染
如果你的站是Vue/React写的SPA单页应用,针对百度蜘蛛必须在反向代理层截胡,转发给Prerender服务;而对Googlebot,资源吃紧时甚至可以直接放行:
# 区分蜘蛛代理配置
map $http_user_agent $is_spider {
    default 0;
    ~*(Baiduspider|YisouSpider|Sogou) 1; # 百度系爬虫强行走预渲染
    # ~*(Googlebot) 1; # 如果服务器配置高,Googlebot可放行也可预渲染
}

server {
    listen 80;
    server_name example.com;

    location / {
        if ($is_spider = 1) {
            rewrite .* /render?url=https://$host$request_uri break;
            proxy_pass http://127.0.0.1:3000; # 本地无头浏览器渲染服务(Puppeteer/Prerender)
        }
        root /data/www/dist;
        try_files $uri $uri/ /index.html;
    }
}避坑点:针对百度做SSR,切忌搞出“蜘蛛抓取页面”和“用户实际访问页面”核心内容不一致的情况。百度的冰桶算法和欺骗性跳转排查非常机械,一旦匹配到跳转或严重DOM差异,整段IP拉黑。
2. 索引与推送层:主动出击 vs 结构化静候
在收录这道门槛上,百度的爬虫资源是出了名的“抠门”,尤其是非备案域名和新站,不给配额就完全不爬;Google则遵循“只要你有清晰的URL结构和外链,天涯海角我也爬出来”的逻辑。
百度必做:API 实时推送脚本
在内容发布的CMS后台(无论是WordPress还是自研系统),写进发布Hook,一旦产生新页面,必须直接Curl通知百度:
# 百度主动推送实操(Shell/Curl示例)
curl -H 'Content-Type:text/plain' --data-binary @urls.txt "http://data.zz.baidu.com/urls?site=https://example.com&token=你的专属Token"

# 接口返回说明
# {"remain": 49999, "success": 1} 成功则扣减当天配额,失败会返回 error:400 格式错误
Google必做:遵循严格的 JSON-LD 结构化数据
Google极其吃这一套,页面头部塞入符合Schema.org的结构化代码,能让算法省去大量语义分析成本,直接触发搜索结果的FAQ、How-To或产品星级卡片:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "TechArticle",
  "headline": "Linux服务器性能调优实战指南",
  "author": {
    "@type": "Person",
    "name": "运维老炮"
  },
  "datePublished": "2024-03-01T08:00:00+08:00",
  "description": "从内核参数配置到网络连接数优化的实操复盘。"
}
</script>
3. 内容与排名层:精准分词堆砌 vs 意图深度覆盖
- 百度的算法(清风、细雨、惊雷)逻辑特征:核心还是基于关键词字面分词与权重比对。百度的NLP中文理解虽强,但为了算力节约,在检索层依然高度重视
<title>、<meta description>、<h1>、页面首段的文字重合度。如果写一篇“MySQL主从复制配置”,百度希望你的标题必须出现“MySQL主从复制”,甚至在首段出现加粗的关键词。 - Google的算法(Helpful Content Update、BERT、MUM)逻辑特征:极度反感纯机械式洗稿和关键词刻意堆砌。Google的RankBrain关注的是“跳出率与二次检索率”。如果用户搜索“如何排查502错误”,搜完你的页面后,点击进入,停留3分钟,并且没有返回搜索结果页继续点击第二名,Google直接判定你的内容优质并提权。
标题构造落地差异实操:
- 百度向标题写法:
MySQL主从复制配置教程_主从延迟排查与同步报错解决 - [品牌名]- 特点:核心词靠前、长尾词包含、下划线/连字符分割清晰。
- Google向标题写法:
How to Fix MySQL Master-Slave Replication Lag: A Step-by-Step Production Guide- 特点:直接解决痛点、承诺交付价值,强调真实生产环境(E-E-A-T背书)。
4. 权重与外链层:生态站群 vs 自然投票
- 百度SEO的信任链破局:百度的自有产品(百家号、知道、百科、爱采购)占据了前列的大量黄金位。外部站想拿权重,ICP备案是准入门槛,未备案站极难进入核心大词的索引池。在外链建设上,百度早已不给普通Blogroll外链高权重,目前唯一稳定的外链手法是:同行业高权重正规站的单向软文链接或友情链接,严禁使用任何自动化工具狂刷论坛签名、Profile外链(直接触发绿萝算法死缓)。
- Google SEO的外链生态:PageRank依然是底层的基石,虽然算法隐藏了PR数值。Google对垃圾外链(PBN站群、印度三方平台滥发)有专门的SpamBrain模型实时过滤。你做Google的外链,核心是靠Guest Post(客座投稿)、数字公关(Digital PR)、或者死链替换(Broken Link Building),换取上下文相关(In-content)且带有真实推荐性质的外链。
高频关联问题拓展
Q1:同一套源码做多语言站,该用目录形式还是独立域名?
- 针对Google:优先推荐子目录(
example.com/en/和example.com/es/),能集中整站权重,再配合标准的hreflang标签明确告诉Google语言区域划分:<link rel="alternate" hreflang="en" href="https://example.com/en/" /> <link rel="alternate" hreflang="zh-Hans" href="https://example.com/zh/" /> - 针对百度:如果要吃百度流量,请务必将中文版独立使用
.cn或已备案的.com域名,解析到国内节点。如果和外文版混在一个海外服务器的子目录里,百度爬虫受制于国际出口带宽限制,抓取经常超时,收录会慢到让你怀疑人生。
Q2:使用AI生成批量内容,两家搜索引擎的惩罚力度如何?
- 百度的反应:机械化极高,但后知后觉。百度上线了各种针对“低质聚合”的惩罚算法。如果AI生成的内容语义空洞、首尾废话连篇、段落高度模板化,一旦被收录判定为低质,往往不会只下架单篇,而是直接整站降权、收录骤降至0,恢复周期以年计算。
- Google的反应:根据官方的《关于AI生成内容的搜索指南》,Google明确表示不惩罚AI生成的内容,只惩罚为了操控排名而生产的无价值垃圾。在Google上,哪怕是AI生成的,只要结合了真实测试数据、提供了独家代码片段、解决了长尾问题,依然能排在第一;但如果是纯粹跑批洗稿的低质AI内容,在核心算法更新(Core Update)时会被精准斩杀,展现量直接断崖。
Q3:快排(发包/模拟点击)在两家现状如何?
- 百度:惊雷算法更新了数版,但私下里“快排发包”依然在某些灰产和行业词中猖獗。然而,随着百度对点击行为的指纹校验越来越严,目前小团队自建的模拟点击很容易失效并导致域名被K,普通站长碰都不要碰。
- Google:Google拥有全网最强的行为分析和反作弊集群(依赖Chrome浏览器海量指纹与跨设备追踪)。在Google上搞模拟点击,不仅纯属交智商税,甚至连沙盒期都跨不过去就会被标记为异常。
结尾总结
把百度SEO与Google SEO核心算法逻辑区别拆透之后,你会发现:做百度更像是在一个半封闭、中心化、规则重重的体系里玩策略,你必须严格顺应其技术抓取的短板,依靠高频推送、精准元数据、备案资质和强合规性去抢夺存量流量;而做Google,则是在一个去中心化、完全技术驱动、看重全球用户真实反馈的市场里赛跑,你的代码规范性、页面加载性能、E-E-A-T权威度以及解决用户真实痛点的能力,直接决定了你能走多远。
技术实操没有银弹,两手都要抓的团队,务必在架构设计之初就将国内节点与海外节点、SSR动态渲染层、结构化Schema代码解耦,按两套完全不同的标准去交付页面,才能在两个生态中同时拿到结果。