
避开高难度核心词的长尾词库搭建方案:绕开头部大词搞定长尾词库
避开高难度核心词的长尾词库搭建方案,核心就八个字:下沉场景、精准截流。中小团队或新项目如果还去硬刚“CRM系统”、“VPS推荐”、“Python培训”这种被大厂砸钱垄断的大词,纯粹是拿钱打水漂;真正的破局点在于放弃搜索量大但竞争极高的一级大词,直接去挖带明确意图的修饰词、问题词、场景词,用几十个甚至上百个精准长尾词构建金字塔矩阵,换取高转化且稳定的自然流量。
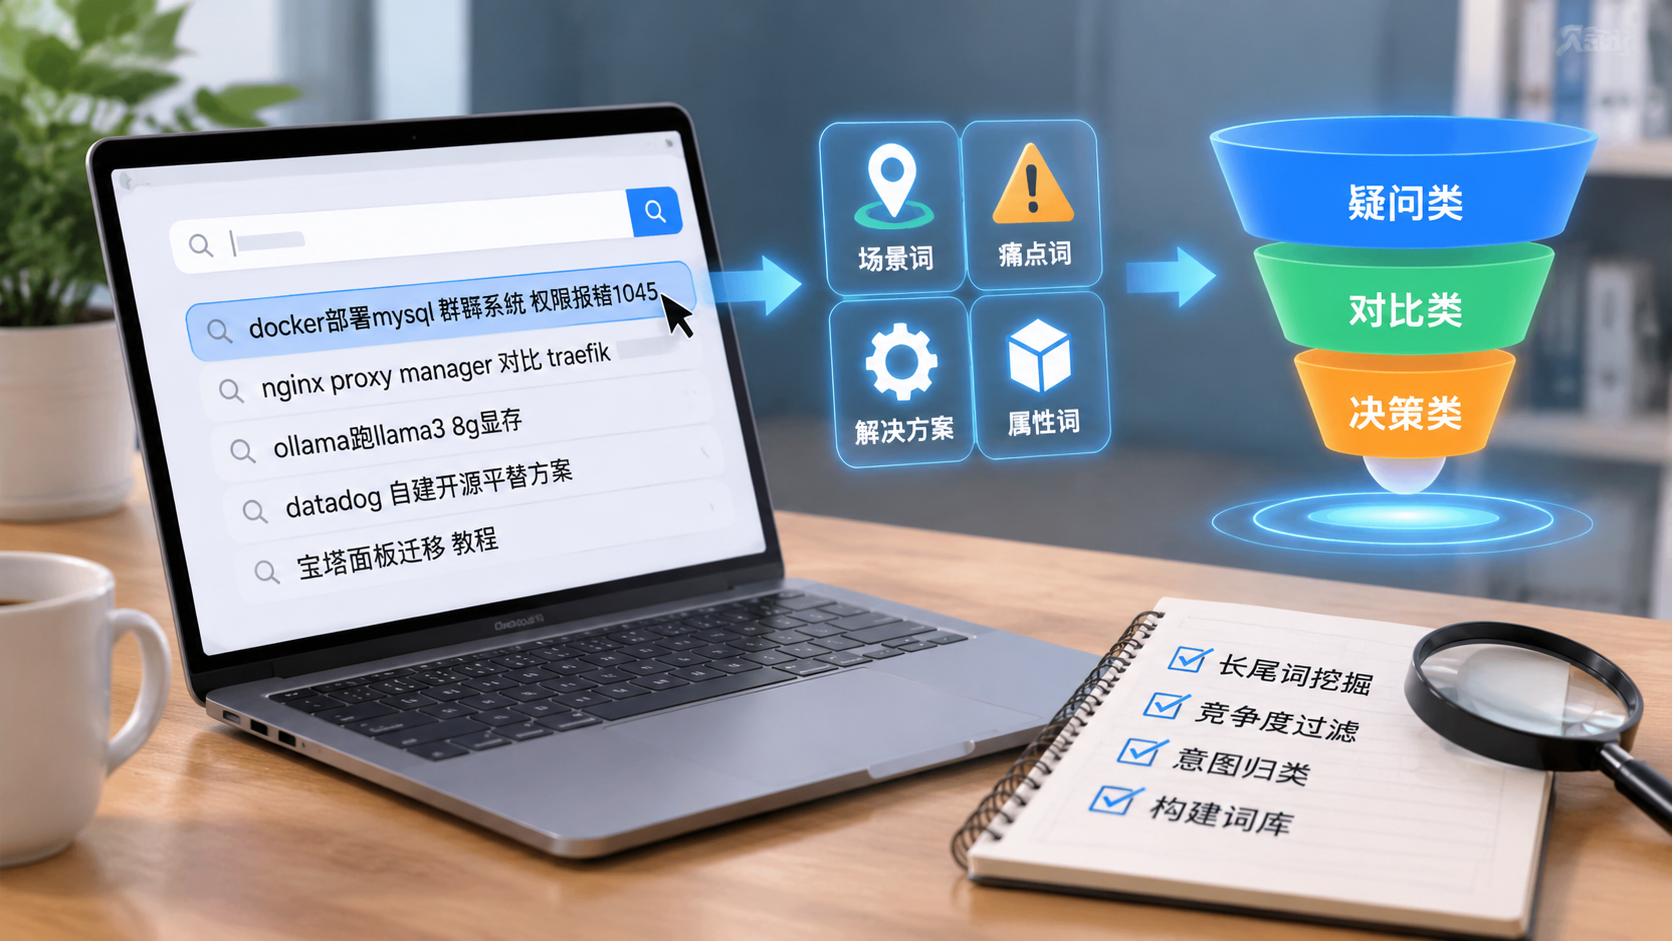
一、 核心方案速览
不要指望随便找个免费SEO工具导几千个词就叫词库,那种大多是僵尸词。可落地的搭建逻辑分为四步:
- 词根四向扩散:放弃核心词本身,拆解为“业务主体 + 使用场景 + 痛点限定 + 解决方案属性”。
- 自动化脚本截流:用轻量级脚本直接跑各大搜索引擎的下拉提示(Suggest API)和相关推荐,抓取真实用户的即时搜索意图。
- 竞争度二次清洗:剔除百度权重8以上、首页全是大厂官网或竞价站的死磕词,保留“论坛、知道、博客、小网站”排在首页的词。
- 意图归类与建库:按照“疑问类(Info)”、“对比类(Investigative)”、“决策类(Transactional)”归类,导入数据库或表格形成生产映射。
二、 实操细节深度拆解
1. 长尾词根拓词公式(直接套用)
别凭空脑暴,长尾词必须严格按照结构组合。这里给一套经过实战检验的拓词公式,直接往里面填你的业务词:
- 场景痛点型:
[核心业务词] + [特定环境/系统] + [报错/失效/卡顿]- 例句:
Docker部署MySQL+群晖系统+权限报错1045
- 例句:
- 成本与平替型:
[竞品词/高价服务] + [开源平替/免费方案/成本核算]- 例句:
Datadog+自建开源平替方案
- 例句:
- 选型对比型:
[小众产品A] + vs/对比 + [小众产品B] + [适用场景]- 例句:
Nginx Proxy Manager+对比+Traefik+轻量个人博客
- 例句:
- 版本/限制型:
[核心工具] + [版本号/硬件配置] + [最低要求/支持列表]- 例句:
Ollama跑Llama3+8G显存+量化配置
- 例句:
避坑点:千万别加毫无商业价值的泛修饰词,比如“最新”、“大全”、“有什么”、“2024最新版”,这种词看着搜的人多,进来的全是只白嫖不点击的垃圾流量。
2. 自动化挖掘长尾词脚本(Python开箱即用)
别去花几千块买臃肿的拓词软件,搜索接口直接调公开的Suggest API最干净。以下脚本直接用Python调用百度和必应的搜索补全接口,深度递归两层挖掘,自带去重:
import requests
import json
from typing import Set

HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

def get_baidu_suggest(keyword: str) -> Set[str]:
    """抓取百度搜索下拉词"""
    url = f"https://suggestion.baidu.com/su?wd={keyword}&sugmode=2&json=1"
    words = set()
    try:
        res = requests.get(url, headers=HEADERS, timeout=5)
        # 百度返回的是gbk编码的伪json,需要清洗
        content = res.content.decode('gbk', errors='ignore')
        start = content.find('(')
        end = content.rfind(')')
        if start != -1 and end != -1:
            data = json.loads(content[start+1:end])
            words.update(data.get("s", []))
    except Exception as e:
        print(f"[-] 抓取 {keyword} 失败: {e}")
    return words

def build_long_tail_pool(seed_words: list, depth: int = 2) -> set:
    """按层级递归拓词"""
    current_pool = set(seed_words)
    all_discovered = set(seed_words)

    for d in range(depth):
        print(f"[*] 正在执行第 {d+1} 层递归挖掘,当前待拓词量: {len(current_pool)}")
        next_pool = set()
        for word in current_pool:
            results = get_baidu_suggest(word)
            new_words = results - all_discovered
            next_pool.update(new_words)
            all_discovered.update(new_words)
        current_pool = next_pool
        if not current_pool:
            break

    return all_discovered

if __name__ == "__main__":
    # 放入你的初始细分词根,绝不要放单一核心大词
    seeds = ["宝塔面板迁移", "群晖内网穿透", "轻量云服务器搭建"]
    pool = build_long_tail_pool(seeds, depth=2)

    print(f"\n[+] 挖掘完成,共获取长尾词: {len(pool)} 个")
    with open("long_tail_keywords.txt", "w", encoding="utf-8") as f:
        for w in sorted(pool):
            f.write(w + "\n")
3. 竞争度过滤:把炮灰词剔出词库
抓出来的词如果首页依然是巨头把持,依然要丢弃。用以下三个指标做快速判定:
- 指标一:SERP前五位站长属性
- 在无痕浏览器里搜这个词。如果前三名全是阿里云、腾讯云、知乎大V、或者带“官网”认证的大站首页,直接弃用。
- 如果前三名出现个人博客、自建站点二级页面、发帖时间是两三年前的CSDN/贴吧帖子,果断入库,这就是你的黄金空间。
- 指标二:搜索结果页URL完全匹配度
- 看前五名搜索结果的标题(Title)。如果他们的Title只是包含了你的部分字词,而不是完全匹配你的长尾词短语,说明百度/谷歌根本没有针对这个具体意图的极佳页面,只要你写一篇精准匹配的内容,排名能迅速爬到前三。
- 指标三:intitle 竞争量查询
- 搜索格式:
intitle:你的长尾词。 - 如果收录结果小于 10,000,属于低竞争度,靠优质内容即可硬吃;如果大于 100,000,果断切更细的词。
- 搜索格式:
4. 搭建四级词库资产表
筛完之后的词,不要散落在TXT里,建立标准SQLite数据库或结构化表格,用四级标签管理:
| 字段名 | 字段内容说明 | 示例 |
|---|---|---|
| Keyword | 实际要优化的长尾词 | 宝塔面板迁移到新服务器MySQL报错1045 |
| Intent_Type | 搜索意图类型 (排障/教程/对比/下载) | 故障排查 (Troubleshooting) |
| SERP_Diff | 竞争评级 (S/A/B/C,只留B和C级低难度词) | C级 (前排多为老旧技术博客) |
| Content_Type | 落地页面形态 (博客文章/独立聚合页/文档) | 实操排障技术手册 (Single Post) |
| Status | 生产状态 (待写/撰写中/已收录/已排名) | 待写 |
三、 高频关联问题拓展
Q1:长尾词搜索量实在太小,甚至各大站长工具显示搜索量为0,值得做吗?
答:千万别被工具的“0搜索量”给骗了。 很多第三方工具的数据来源于商业词库买断或采样,对于大量细分、新出现的长尾问题词,它们抓不到数据就会显示为0。只要这个词在搜索下拉框或相关搜索里出现过,就代表至少有真实用户反复搜过多次才会被引擎算法收录进下拉提示。 打法:不要为单个“0搜索”词单独写3000字长文,而是做“词簇合并”。把3~5个指向同一个痛点、只是语序不同或报错代号微调的长尾词归在一起,写一篇能彻底解决该问题的实操文档,一次性把这几个词全部吃掉。
Q2:好不容易避开了大词,写了长尾词文章,为什么还是只收录没排名?
答:根本原因是页面意图不纯,废话太多。 搜索长尾词进来的用户目的性极强。他搜的是“Nginx 502 Bad Gateway排查步骤”,点进来第一屏如果还在看你介绍“什么是Nginx”、“Nginx的诞生历史”,用户5秒内就会关掉页面,跳出率直接干废排名。 解决办法:
- 首屏直接给答案:第一段写明原因与核心解决配置命令。
- 代码/步骤置顶:先贴能直接解决问题的代码块,下面再讲排查原理。
- 标题精准命中:页面H1标签必须100%覆盖核心长尾词,正文H2匹配衍生副词。
Q3:大量低搜索量的长尾页面,会不会导致整站低质内容过多被降权?
答:会,如果你用模板批量生成没有实质信息的空壳聚合页。 很多站长偷懒,拿到长尾词库后用程序批量采集拼接,生成几万个只有几十个字或者大量死链的伪标签聚合页,不出三个月必被清收录。 合规路径: 每个长尾词落地页必须提供真实的解决方案。宁可词库里只有200个扎扎实实解决问题的长尾页面,也别搞2万个垃圾死链页。只要内容有真实用户停留并发生复制行为(比如复制代码块、翻阅多级列表),搜索引擎就会将其标记为高价值解决页,反而会大幅拉高整站权重。
四、 结尾总结
避开高难度核心词的长尾词库搭建方案,本质上是一场田忌赛马式的降维打击。在存量竞争时代,盲目迷信核心大词只会让你陷入无休止的外链与竞价泥潭。通过拆解业务场景、用脚本抓取刚需下拉、用SERP分析剔除巨头壁垒,最终沉淀出一套能持续带来高转化线索的四级长尾词库,才是技术人和中小站长最稳妥、性价比最高的冷启动打法。建好词库后,立刻执行“一个页面吃透一个意图”的产出节奏,把数据拿到手里,比任何高大上的理论都管用。
相关文章
- 新站上线前三个月SEO具体操作流程:新站前3个月SEO实操路线图
- 没预算的情况下外贸独立站SEO怎么冷启动:零预算外贸独立站SEO冷启动
- 避开高难度核心词的长尾词库搭建方案:绕开头部大词搞定长尾词库
- 谷歌Core Web Vitals指标不及格的服务器优化教程:搞定谷歌CWV的服务器优化实操
- 伪原创失效后纯人工SEO高质量文案写作技巧:伪原创失效后的SEO写作法
- 2024年获取高质量外链的实操渠道汇总:2024搞定高质量外链实操指南
- 工业B2B外贸网站排名长期停滞的排查思路:工业B2B外贸站排名停滞排查
- 除了Semrush和Ahrefs之外的免费SEO工具清单:真正能打的免费SEO工具清单
- 网站被谷歌降权导致收录断崖式下跌的补救措施:谷歌降权收录断崖下跌急救手册
- Shopify独立站分类页面SEO布局与转化率优化:Shopify分类页SEO与转化实战