
技术文案成语误用怎么排查:技术文案成语误用排查实操
技术文案成语误用怎么排查,最直接高效的方案就是搭建“本地词库脚本初筛 + 大模型上下文复核 + 人工红线兜底”的三级流水线,别靠人眼一行行硬啃,直接把校验脚本塞进 Git 钩子或 CI 流水线里,五分钟就能把全库文档扫个底朝天。
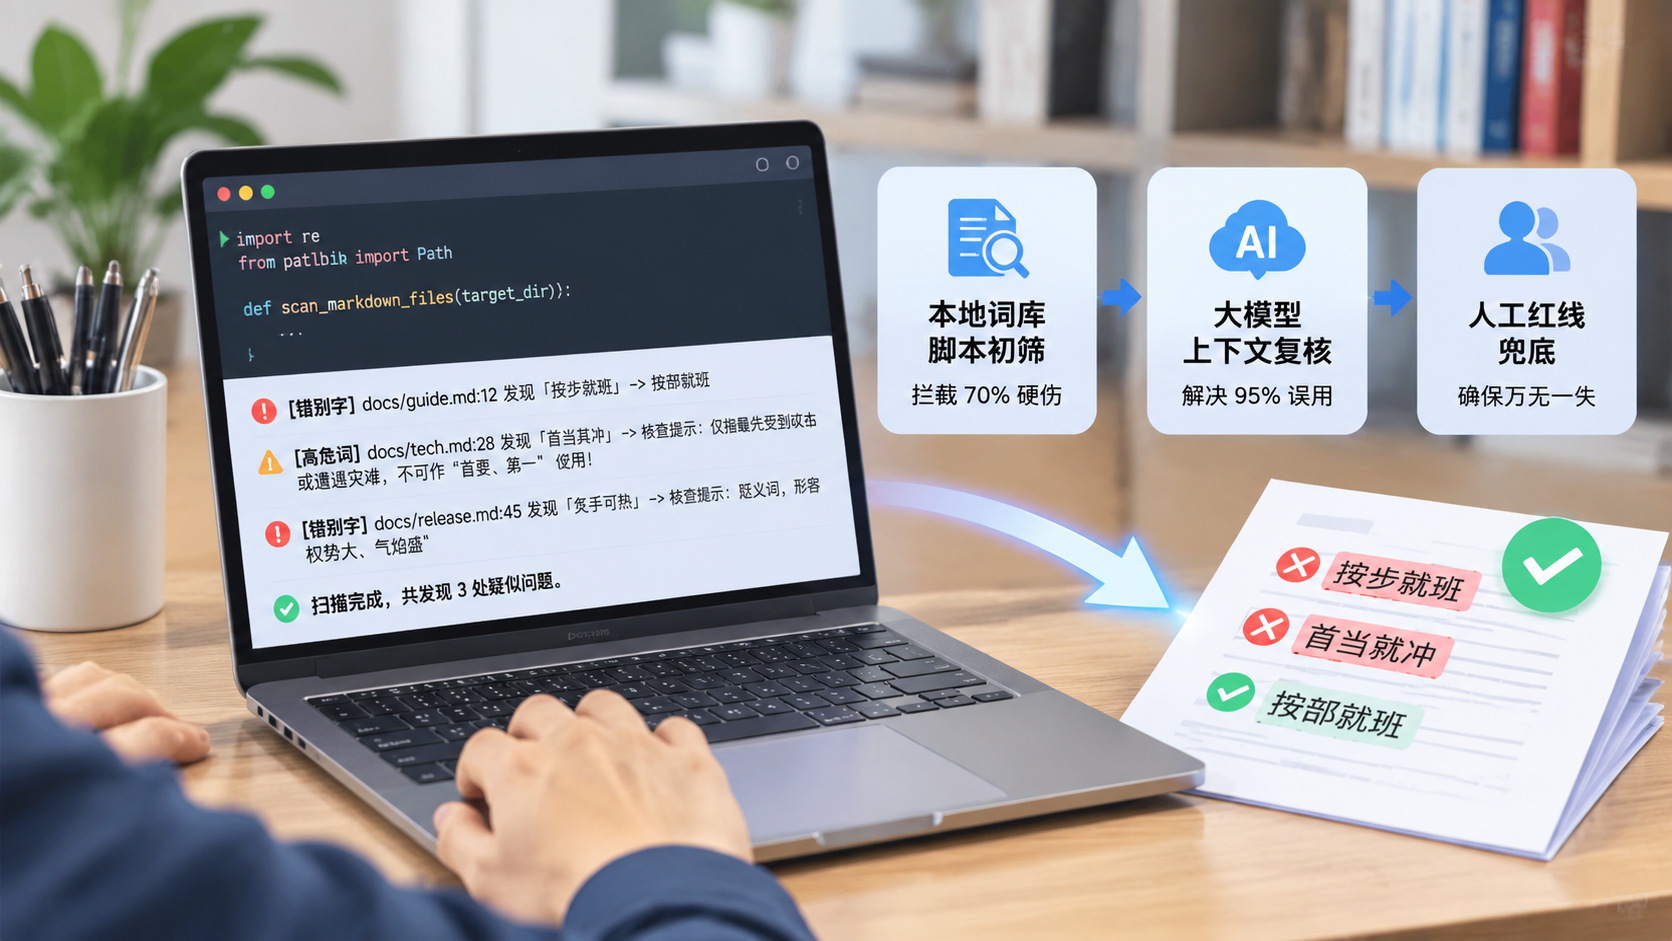
写技术博客、发版日志(Release Notes)或者产品白皮书,最怕的不是技术原理讲不透,而是作者硬凹文采,或者直接把 AI 吐出来的稿子原封不动贴上去,结果整出一堆“性能优化首当其冲要改索引”、“这款开源组件目前炙手可热”、“经过压测,系统表现差强人意(本意想夸不错)”之类的硬伤。外行看着糊涂,内行看了直接笑掉大牙。下面直接上可落地的排查方案和代码。
核心方案速览
想低成本解决技术文档里的成语翻车问题,按成本和精准度分三步走,直接按团队现状套用:
- 静态脚本初筛(拦截 70% 硬伤):用 Python 脚本配合正则与“高危错别字/高频误用成语词典”,在本地提交代码前自动扫一遍
.md或.txt文件,直接标出拼写错误(如“按部就班”写成“按步就班”)和高危词(如“首当其冲”、“差强人意”)。 - 大模型语义复核(解决 95% 语境误用):静态词典判断不了语境对不对,必须把命中的段落丢给大模型 API,用设定好校验规则的 System Prompt 做语义打标,精准揪出褒贬颠倒、主客体错位的问题。
- 发版红线与平替规范(治本防复发):立下规矩,技术文案能用大白话讲清楚的绝不用成语;高频踩坑的成语直接列成团队红黑榜,在文档模板里提前打好预防针。
实操细节深度拆解
一、本地静态词库扫描脚本(直接跑)
很多成语误用其实集中在少数二三十个高频词上,外加各种同音错别字。先用脚本把这些“重灾区”和错别字拦下来,零 API 成本,毫秒级出结果。
下面是一个可直接运行的 Python 脚本,支持递归扫描指定目录下的 Markdown 文档,定位到具体文件名、行号并给出排查提示。
import re
from pathlib import Path

# 1. 错别字成语黑名单(直接判死刑)
TYPO_IDIOMS = {
    "按步就班": "正确写法:按部就班",
    "迫不急待": "正确写法:迫不及待",
    "默守成规": "正确写法:墨守成规",
    "一如即往": "正确写法:一如既往",
    "再接再励": "正确写法:再接再厉",
    "穿流不息": "正确写法:川流不息",
    "不可思意": "正确写法:不可思议",
    "名符其实": "正确写法:名副其实",
    "走头无路": "正确写法:走投无路",
    "眼花缭乱": "注意检查是否误写为眼花撩乱",
    "眼花撩乱": "正确写法:眼花缭乱",
}

# 2. 技术文案高危误用成语(标黄预警,人工或LLM复核语境)
HIGH_RISK_IDIOMS = {
    "首当其冲": "仅指最先受到攻击或遭遇灾难(如:流量洪峰来袭,网关首当其冲),不可作“首要、第一”使用!",
    "差强人意": "意思是“勉强让人满意”(偏褒义),不是“很差、不尽如人意”!",
    "炙手可热": "贬义词,形容权势大、气焰盛(常含傲慢意),夸开源项目或技术栈火爆请改用“备受关注/广泛应用”。",
    "美轮美奂": "仅用于形容建筑物高大华丽,不可用来形容代码架构、UI界面或数据大盘。",
    "不以为然": "意为“不认为是对的(表示反对)”,若想表达“没放在心上/不在乎”,请用“不以为意”。",
    "空穴来风": "原意指“消息传闻并非毫无根据”,现代误用常当作“毫无根据”,建议直接写“毫无依据”。",
    "罄竹难书": "极度贬义,形容罪行极多,切勿在公开复盘或调侃 Bug 多时使用。",
    "万人空巷": "形容庆祝或欢迎的盛况,别用来形容“系统崩溃导致大家都不在线”。",
    "明日黄花": "指过时的事物,别写成“昨日黄花”。",
}

def scan_markdown_files(target_dir: str):
    base_path = Path(target_dir)
    if not base_path.exists():
        print(f"路径不存在: {target_dir}")
        return

    issue_count = 0
    # 排除代码块,避免误报代码注释或变量名(简单过滤```包裹的内容)
    code_block_pattern = re.compile(r"```.*?```", re.DOTALL)

    for md_file in base_path.rglob("*.md"):
        content = md_file.read_text(encoding="utf-8")
        # 保留行号映射:将代码块替换为空行,防止行号错乱
        cleaned_content = code_block_pattern.sub(
            lambda m: "\n" * m.group(0).count("\n"), content
        )
        lines = cleaned_content.splitlines()

        for line_num, line in enumerate(lines, start=1):
            # 跳过纯链接或图片行
            if line.strip().startswith(("![", "http://", "https://")):
                continue

            for typo, fix in TYPO_IDIOMS.items():
                if typo in line:
                    issue_count += 1
                    print(f"[错别字] {md_file}:{line_num} 发现「{typo}」 -> {fix}")

            for idiom, warn in HIGH_RISK_IDIOMS.items():
                if idiom in line:
                    issue_count += 1
                    print(f"[高危词] {md_file}:{line_num} 发现「{idiom}」 -> 核查提示:{warn}")

    print(f"\n扫描完成,共发现 {issue_count} 处疑似问题。")

if __name__ == "__main__":
    # 替换成你的文档目录
scan_markdown_files("./docs")实操避坑点:
- 一定要剔除代码块:技术文档里经常夹杂代码注释、报错日志甚至测试用例,如果不过滤
```代码块,脚本很容易把测试数据里的文本当成正文误报。上面的代码特意做了换行符占位替换,既过滤了代码块,又保证了行号精准对齐。 - 别把所有四字词都加进词库:技术文档里充斥着“异步回调”、“全量同步”、“负载均衡”这种四字技术术语,盲目做四字分词匹配只会产生海量垃圾告警,最后没人愿意看。
二、接入大模型做上下文语义校验
静态词库只能抓已知的高危词。如果作者用了一个生僻成语,或者把一个普通成语用错了主语(比如“这个接口文档写得无微不至”——“无微不至”一般修饰人对人的关怀,形容文档就别扭),就得靠大模型来抓语义逻辑。
千万别直接把整篇 5000 字的文档全丢给大模型,不仅费 Token,长上下文下大模型的注意力还会下降,漏掉中间段落的错别字。正确做法是:先按段落切分(过滤掉短标题和纯代码段),只把包含中文长句的段落并发丢给轻量级模型(如 DeepSeek-V3、Qwen-Plus 或 GPT-4o-mini)。
核心校验脚本与 Prompt 如下,直接替换 API Key 就能跑:
import json
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("LLM_API_KEY", "你的API_KEY"),
    base_url=os.getenv("LLM_BASE_URL", "https://api.deepseek.com/v1") # 兼容OpenAI格式
)

SYSTEM_PROMPT = """
你是一名严苛的技术文档主编,专门排查技术文案中的【成语误用】与【四字词搭配不当】。
请仔细审查用户输入的技术文档段落,遵循以下规则:
1. 重点检查是否存在:错别字成语、褒贬误用(如用“炙手可热”夸技术)、主客体错位(如用“美轮美奂”形容UI)、语义矛盾(如用“差强人意”表示不满意)、生硬堆砌。
2. 忽略正常的技术四字术语(如“高可用性”、“负载均衡”、“断网重连”)。
3. 必须以纯 JSON 数组格式输出问题列表,不要输出任何 Markdown 标记或多余解释。如果没有问题,输出空数组 []。

JSON 格式示例:
[
  {
    "original": "含误用成语的原句片段",
    "idiom": "误用的成语",
    "reason": "简短说明为什么错",
    "suggestion": "建议替换为更准确的现代白话或正确成语"
  }
]
"""

def check_paragraph_with_llm(paragraph: str) -> list:
    if len(paragraph.strip()) < 15:
        return []
    try:
        resp = client.chat.completions.create(
            model="deepseek-chat",
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": paragraph}
            ],
            temperature=0.1, # 温度设低,保证结果稳定
        )
        raw_text = resp.choices[0].message.content.strip()
        # 兼容模型偶尔带出 ```json 的情况
        raw_text = raw_text.removeprefix("```json").removesuffix("```").strip()
        return json.loads(raw_text)
    except Exception as e:
        print(f"校验异常: {e}")
        return []

# 测试用例
sample_text = """
本次 2.0 版本重构可谓费尽心血,新上线的监控大盘美轮美奂。
面对即将到来的双十一大促,数据库的读写分离首当其冲要完成改造。
虽然压测 QPS 只达到了预期的一半,整体表现差强人意,但我们还是按步就班推进了上线。
"""

for idx, para in enumerate(sample_text.strip().split("\n"), 1):
    issues = check_paragraph_with_llm(para)
    if issues:
        print(f"第 {idx} 段发现问题:")
print(json.dumps(issues, ensure_ascii=False, indent=2))实操避坑点:
temperature必须压低到 0.1 以下:如果不压低温度,模型会过度发挥,把正常的“总而言之”、“显而易见”也强行挑刺说成生硬堆砌,导致误报率飙升。- 限制输出格式并做容错清洗:哪怕你在 Prompt 里写死了“不要输出 Markdown 标记”,部分模型依然会习惯性加上
```json。代码里一定要像上面那样加上removeprefix/removesuffix或正则提取[...],否则一跑批量任务就会JSONDecodeError崩溃。
三、技术场景高频翻车成语改造对照
工具查出问题后,怎么改才地道?记住一个原则:技术文档的第一诉求是无歧义,而不是文采。能用白话讲清因果的,坚决把成语删掉。
下面整理了真实团队里踩坑最多次的典型案例,可直接贴到团队 Wiki 里当规范:
- 误用案例 1(首当其冲)
- 错误写法:“要解决慢查询,首当其冲的是给核心表加上联合索引。”
- 问题在哪:把“首当其冲”当成了“首要、第一件要做的事”。它的原意是最先受到攻击或遭遇灾祸。
- 直接平替:“要解决慢查询,最优先的是给核心表加上联合索引。”(正确用法:“机房断电后,无容灾备份的老旧集群首当其冲受到影响。”)
- 误用案例 2(差强人意)
- 错误写法:“新版客户端冷启动耗时 4 秒,用户体验差强人意,下个迭代必须优化。”
- 问题在哪:以为带个“差”字就是“很差”。实际上“差”在这里读 chā,意思是“稍微、大致”,“差强人意”是指大体上还能让人满意。
- 直接平替:“用户体验不尽如人意”或直接写“用户体验较差”。
- 误用案例 3(炙手可热)
- 错误写法:“Rust 是目前系统编程领域炙手可热的语言。”
- 问题在哪:这个词带贬义,形容人权势熏天、气焰嚣张,谁靠近谁烫手,用来夸技术生态火爆非常违和。
- 直接平替:“Rust 是目前系统编程领域备受瞩目 / 热度极高的语言。”
- 误用案例 4(不以为然 vs 不以为意)
- 错误写法:“研发同学对这条 Low 级别告警不以为然,结果半夜触发了雪崩。”
- 问题在哪:“不以为然”是认为不对(持否定态度);想表达“没放在心上、不当回事”,应该用“不以为意”。
- 直接平替:改用“不以为意”,或者直接写成“没有引起重视”。
- 误用案例 5(美轮美奂 / 汗牛充栋)
- 错误写法:“前端团队用 ECharts 打造的拓扑图美轮美奂”;“GitHub 上相关的轮子汗牛充栋”。
- 问题在哪:“美轮美奂”专指高大华丽的建筑物;“汗牛充栋”专指书籍非常多。别乱跨界嫁接。
- 直接平替:“拓扑图清晰直观 / 视觉效果极佳”;“GitHub 上相关的轮子非常多 / 层出不穷”。
四、把排查脚本塞进 Git Pre-commit 钩子
脚本写好了没人主动跑等于白搭。直接把第一步的静态扫描脚本挂到文档仓库的 .git/hooks/pre-commit 里,每次 git commit 时自动触发:
#!/bin/bash
# 保存为 .git/hooks/pre-commit 并赋予执行权限: chmod +x .git/hooks/pre-commit

# 仅提取本次暂存区里新增或修改的 .md 文件
STAGED_MD_FILES=$(git diff --cached --name-only --diff-filter=ACM | grep -E '\.md$')

if [ -z "$STAGED_MD_FILES" ]; then
    exit 0
fi

echo "正在排查技术文案成语与错别字..."

# 调用检查脚本(建议把脚本改造成接收文件列表参数)
python3 ./scripts/check_idioms.py $STAGED_MD_FILES

# 如果不想在紧急发布时彻底卡死提交,可以先设为仅告警(exit 0)
# 团队规范成熟后,再改为检测到 [错别字] 就 exit 1 阻断提交
exit 0经验之谈:刚推行时千万别一上来就用 exit 1 强行阻断提交。尤其是线上故障发公告或者紧急发版写 Release Notes 的时候,脚本如果误报卡住提交流程,研发同学一定会直接 git commit --no-verify 绕过,甚至找你扯皮把钩子删了。先设为告警提示(exit 0),或者只在 CI/CD 的 PR(Pull Request)阶段做 Comment 评论提醒,运行两周把词库误报调教干净了,再切到强制拦截。
高频关联问题拓展
1. AI 辅助写出来的技术文章成语翻车率极高,怎么源头控制?
现在很多运营和研发喜欢用大模型润色技术文章,而大模型极其喜欢在段落衔接处疯狂输出“无独有偶”、“相辅相成”、“如虎添翼”、“毋庸置疑”、“画龙点睛”这类空洞成语,读起来一股浓浓的“AI 腔”,有时候还会强行捏造搭配。
解决办法:在生成文章的 Prompt 里直接加上负面约束(Negative Constraints),把问题掐死在源头:
“写作风格要求:保持资深工程师的口吻,直白干脆。严格禁止使用任何四字成语、文言虚词以及‘综上所述’、‘毋庸置疑’、‘如虎添翼’等套话。所有逻辑转折请使用现代白话连词(如:‘但问题是’、‘之所以这样’、‘直接导致’)。”
2. 团队里有人觉得“意思到了就行,纠结成语干嘛”,怎么推动?
内部周报、临时排查笔记确实不用上纲上线,随便写。但一旦涉及对外发布的博客、客户看的白皮书、API 对接文档、官方公告,错用成语会直接拉低技术品牌的专业度。试想一下,一个做高可用数据库的厂商,在官网技术架构文章里写“我们的架构差强人意”,客户技术总监看了会怎么想?把排查工具的适用范围明确划在“对外输出文档库”上,既不烦研发日常写笔记,又能保住对外门面,推起来阻力最小。
3. 除了成语,技术文案还有哪些顺带一起查的硬伤?
既然都搭了流水线,没必要只查成语,建议顺手把下面三类技术文案通病一起集成进去:
- 中英文混排无空格、全半角标点乱用:直接集成开源的
autocorrect工具(支持 CLI 和 GitHub Action),一行命令自动修掉使用Redis缓存这种粘连排版。 - 专有名词大小写写错:比如把
GitHub写成Github,MySQL写成Mysql,JavaScript写成Javascript。在静态脚本的字典里顺手加上CASE_SENSITIVE_TERMS校验即可。 - 高频技术错别字:比如“登录”和“登陆”(系统登录用“登录”,台风才“登陆”)、“账号”和“帐号”、“阈值”写成“阀值”(技术圈重灾区,十篇里有三篇写错)。这些直接塞进前面 Python 脚本的
TYPO_IDIOMS字典里,一次扫描全搞定。
结尾总结
回到开头的问题,技术文案成语误用怎么排查,核心逻辑就是把“人肉校对”变成“工程化拦截”:日常靠静态词典脚本在 Git 提交前兜住错别字和高危雷区,复杂长文靠低温度配置的大模型 API 批量做语境核查,源头上则通过 Prompt 约束和团队白话写作规范减少成语的无效堆砌。工具跑起来不过几十行代码的事,把这套小流水线搭进你们的文档仓库,以后发技术文章再也不用提心吊胆了。