
技术文档易错词语有哪些:技术文档易错词语避坑清单
要搞清楚技术文档易错词语有哪些,别去翻语文词典,直接盯死同音硬伤词、概念偷换词、大小写畸形词、模糊甩锅词这四大重灾区,再给文档仓库挂一套“禁用词映射表 + CI 自动拦截脚本”,就能直接干掉 90% 的低级返工。
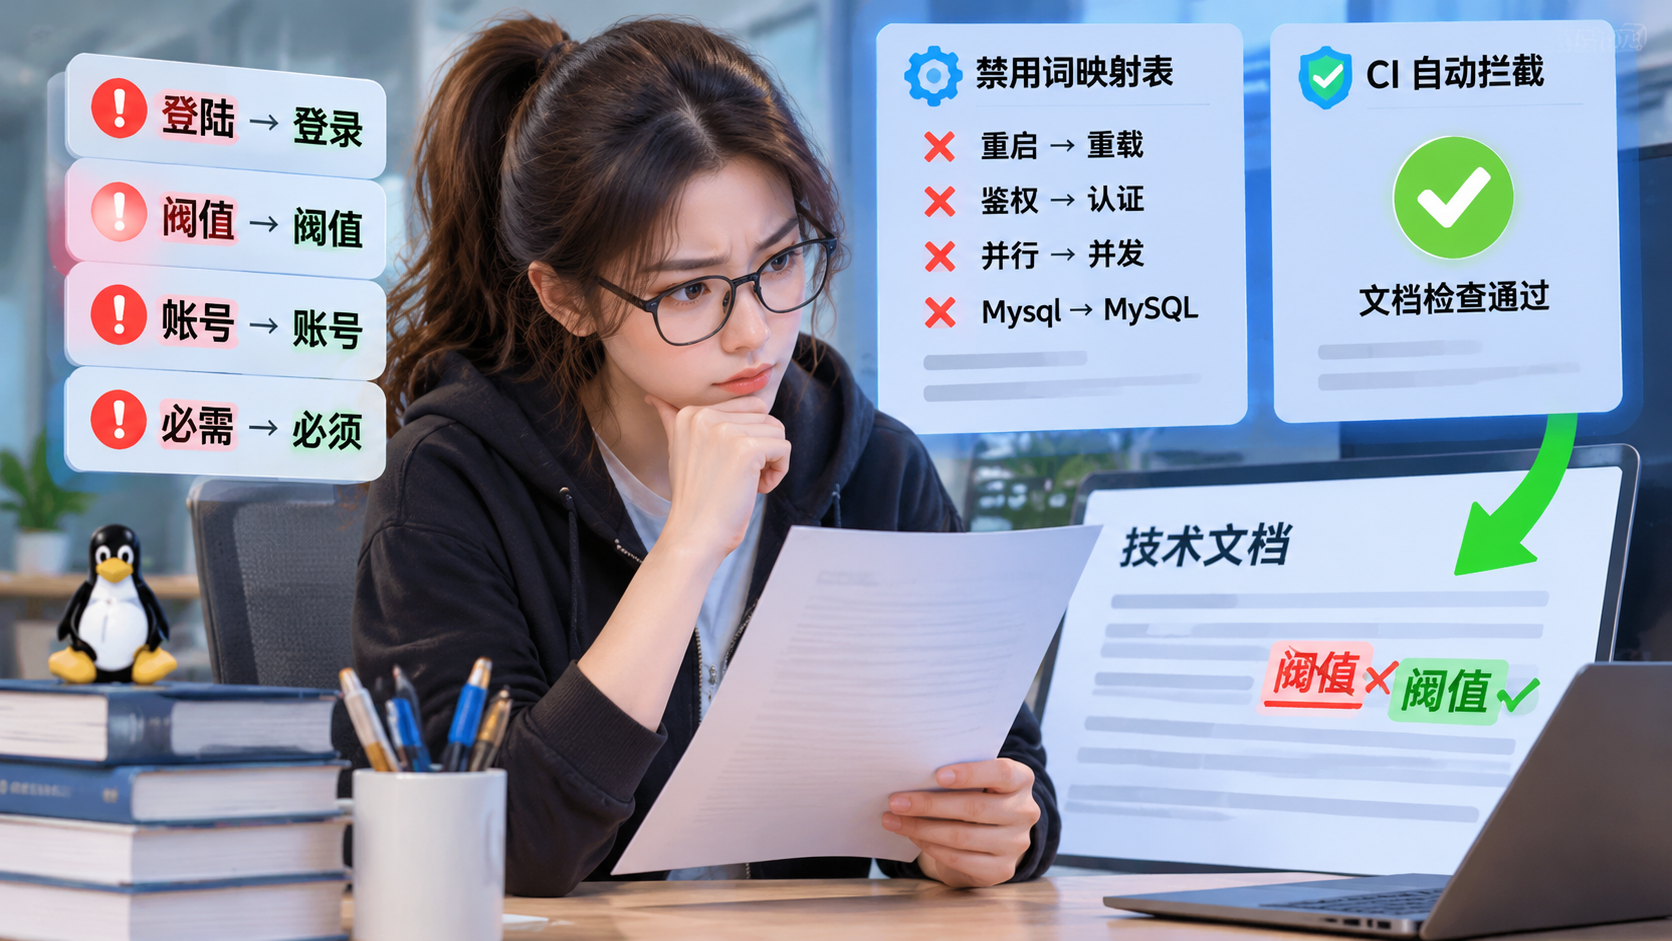
干运维和开发这么多年,我见过最离谱的线上乌龙不是代码写崩了,而是交接文档里把 nginx -s reload 写成“重启 Nginx”,把 Prometheus 报警“阈值”写成“阀值”,把接口文档里的“鉴权”和“认证”混为一谈。写文档的人随手一敲,看文档的人照着踩坑,最后联调扯皮半天,全耗在这些词上。
核心方案速览:别靠人肉盯,用“清单+门禁”解决
靠团队成员自觉去记技术文档易错词语是不现实的,Review 时人工盯文字也极其耗费精力。最落地的做法就三步:
- 划定高频黑名单:把最容易误导人、最丢人的错词按“错词 -> 正确词”做成固定映射表,重点卡死中文同音错字和专有名词大小写。
- 代码化拦截低级错误:把映射表塞进
Vale规则或自写 Python 预检脚本,接入 Gitpre-commit或 CI 流水线,提 PR 时自动扫描.md文件(注意必须跳过代码块,避免误杀命令行)。 - 人工只审概念与逻辑:机器把字面硬伤拦住后,评审人只需要检查“并发/并行”、“重置/重启”、“空值定义”这些机器看不懂的技术概念错误。
实操细节深度拆解:四大易错词重灾区与拦截模板
1. 同音与形近硬伤词(出现频率最高)
这类词不会立刻搞挂服务器,但极度拉低团队专业度,尤其是对外输出的 API 文档和 SDK 手册,客户扫一眼看到一堆错别字,对产品稳定性的信任度直接打对折。
- 登录 vs 登陆
- 适用场景:涉及账号验证、SSH 连接、后台进入,一律用登录;只有“登陆某地区市场”、“台风登陆”才用后者。
- 例句套用:
- ❌ 错误:
用户首次登陆系统后,需修改默认密码。 - ✅ 正确:
用户首次登录系统后,需修改默认密码。
- 阈值 vs 阀值
- 避坑点:这是运维圈重灾区,一半人嘴上念“fá zhí”,顺手就打成“阀值”。实际上只有阈值(yù zhí)表示临界值,“阀”是阀门,根本没有“阀值”这个词。
- 例句套用:
- ❌ 错误:
当 CPU 使用率超过 85% 阀值时触发告警。 - ✅ 正确:
当 CPU 使用率超过 85% 阈值时触发告警。
- 账号/账单 vs 帐号/帐单
- 实操规范:早年很多老文档用“帐”,现在国家语委规范统一用贝字旁的账(涉及钱、记录、户头全用账)。团队文档里别一会儿“账号”一会儿“帐号”,全文搜索困难户就是这么来的。
- 必须 vs 必需
- 区分技巧:“必须”后面跟动作(必须重启、必须配置);“必需”后面跟名词/物品(必需参数、必需依赖)。
- 例句套用:
- ❌ 错误:
token 为必须参数,缺失时必需返回 401。 - ✅ 正确:
token 为必需参数,缺失时必须返回 401。
- 截至 vs 截止
- 避坑点:“截至”必须跟具体时间点(如“截至 2025 年 10 月”);“截止”表示到某个时间停止,不能直接加时间宾语,要么说“截止到 10 月 1 日”,要么说“报名于 10 月 1 日截止”。
- 其他常见错对对照:校验(非“较验”)、兼容(非“兼融”)、原型(设计图用“原型”,非“原形”)、其他(建议全团队统一用“其他”,弃用“其它”)、启用(开启功能/服务用“启用”,非“起用”)、卸载(软件移除用“卸载”,非“卸装”)。
2. 技术概念偷换词(最容易引发线上事故)
字写对了但词用错了,危害比错别字大十倍。这类技术文档易错词语机器很难直接判别,必须在写 SOP(标准操作流程)和架构文档时逐字抠清楚。
- 重启(Restart) vs 重载(Reload) vs 重置(Reset)
- 踩坑经验:以前带过一个新人写网关变更文档,明明只需要
nginx -s reload平滑加载配置,他在文档里写“执行以下命令重启 Nginx 服务”。半夜值班同学不敢擅自改命令但按字面理解停了进程再拉起,直接导致长连接全断。“重置”更危险,意味着清空状态回到出厂默认,绝不能和“重启”混用。 - 规范写法:明确写出动作后果,例如:
执行 nginx -s reload 平滑重载配置(不中断现有连接)。
- 踩坑经验:以前带过一个新人写网关变更文档,明明只需要
- 认证(Authentication) vs 授权/鉴权(Authorization)
- 适用场景:接口文档里别统称“权限验证”。认证解决“你是谁”(校验账号密码、Token 签名);授权解决“你能干什么”(校验 RBAC 角色、读写范围)。
- 例句套用:
- ❌ 错误:
本接口需携带 API Key 进行权限验证,失败返回 401 或 403。 - ✅ 正确:
请求需携带 API Key 完成身份认证(失败返回 401),并校验当前 Key 是否具备该资源的读写授权(失败返回 403)。
- 并发(Concurrency) vs 并行(Parallelism)
- 避坑点:单核 CPU 跑协程调度叫并发,多核同时跑才叫并行。别在介绍单线程异步框架(比如 Node.js 或早期 Redis)时写“高并行处理能力”,外行看着没啥,内行直接觉得你基础不牢。
- 空值表述混乱(null / "" / undefined / 无)
- 实操细节:写 JSON 接口文档时,“为空”是最烂的描述。前端传
""、传null、还是干脆不传这个 Key?后端处理逻辑完全不同。 - 规范写法:直接写死边界,如
字段值为 null 或未传递该字段时,使用默认值 10;若传递空字符串 "" 则触发参数校验报错。
- 实操细节:写 JSON 接口文档时,“为空”是最烂的描述。前端传
3. 英文缩写与中英混排翻车词
技术圈对专有名词的大小写极其敏感,写错不仅显得业余,有时还会误导使用者在区分大小写的 Linux 环境下敲错命令。
- 高频大小写错词清单:
Mysql/mysql→ MySQL(命令行里敲mysql是命令,正文提数据库产品必须写MySQL)Json/json→ JSONGithub→ GitHub;Gitlab→ GitLabJavascript→ JavaScript;Typescript→ TypeScriptNodejs→ Node.jsIOS→ iOS(全大写的 IOS 是思科路由器操作系统,苹果手机系统首字母必须小写!)Url/Api/Sdk/Id→ URL / API / SDK / ID
- 复数与标点乱象:
- 别在中文句子里硬给英文缩写加复数
s,比如多个 APIs、返回所有 IDs,直接写多个 API、所有 ID即可。 - 英文单词和中文之间是否加空格、全角半角括号混用,别靠手工敲,直接用开源工具
AutoCorrect一键格式化。
- 别在中文句子里硬给英文缩写加复数
4. 模糊甩锅词与 AI 腔废话
自己没测清楚边界,或者抄了大模型生成的废话,就会在文档里留下一堆“正确但毫无用处”的词:
- 甩锅模糊词:“可能”、“大概”、“正常情况下”、“尽量”、“最好不要”、“理论上支持”、“很快”。
- 改写模板:
- ❌ 错误:
建议尽量调大超时时间,否则可能会失败。 - ✅ 正确:
建议将 timeout 参数设为 30s 以上;在 100MB 以上大文件上传场景下,低于 15s 会触发 504 超时。
- 时效黑洞词:“最新版本”、“当前版本”、“即将支持”。
- 避坑点:文档是静态的,一年后别人看“当前版本”鬼知道是哪个版本。必须替换为具体版本号,如
自 v2.4.0 起支持、在 v1.x 版本中已废弃。
- 避坑点:文档是静态的,一年后别人看“当前版本”鬼知道是哪个版本。必须替换为具体版本号,如
- AI 黑话垃圾词:“赋能”、“抓手”、“鲁棒性”(直接说容错能力或稳定性不行吗?)、“值得注意的是”、“综上所述”。写技术文档要的是可复现的步骤,不是写行业研报。
5. 直接套用的自动化拦截脚本(跳过代码块版)
光说不练没用,下面给你两套能直接落地的配置。
方案 A:零依赖 Python 预检脚本(适合直接丢进 .git/hooks/pre-commit 或 GitLab CI)
这个脚本专门解决一个痛点:只检查正文,自动过滤掉 Markdown 里的多行代码块和行内代码,防止把命令里的 mysql、id、json 误报成错词。
#!/usr/bin/env python3
import re
import sys
from pathlib import Path

# 定义:错词正则 -> (推荐替换词, 说明)
RULES = {
    r"登陆": ("登录", "系统认证/进入后台请用'登录'"),
    r"阀值": ("阈值", "临界值应为'阈值(yù zhí)'"),
    r"帐号": ("账号", "统一使用贝字旁'账'"),
    r"帐单": ("账单", "统一使用贝字旁'账'"),
    r"较验": ("校验", "应为'校验'"),
    r"兼融": ("兼容", "应为'兼容'"),
    r"其它": ("其他", "建议全库统一使用'其他'"),
    r"卸装": ("卸载", "软件移除请用'卸载'"),
    r"\b(Mysql|mysql)\b": ("MySQL", "专有名词大小写规范"),
    r"\b(Github|github)\b": ("GitHub", "专有名词大小写规范"),
    r"\b(Json|json)\b": ("JSON", "专有名词大小写规范"),
    r"\bIOS\b": ("iOS", "苹果系统为 iOS,全大写为思科系统"),
    r"(?<!\S)(可能|大概|理论上|尽量|最好不要)(?!\S)": ("具体条件/数值", "避免模糊甩锅表述,请写明明确条件"),
}

def strip_code_blocks(content: str) -> list[tuple[int, str]]:
    """逐行清理多行代码块和行内代码,保留原始行号"""
    cleaned_lines = []
    in_fenced_block = False
    for idx, line in enumerate(content.splitlines(), start=1):
        stripped = line.strip()
        if stripped.startswith("```"):
            in_fenced_block = not in_fenced_block
            continue
        if in_fenced_block:
            continue
        # 剔除行内代码 `...` 和 Markdown 链接 URL 部分
        line_no_code = re.sub(r"`[^`]+`", "", line)
        line_no_url = re.sub(r"\]\([^)]+\)", "]()", line_no_code)
        cleaned_lines.append((idx, line_no_url))
    return cleaned_lines

def check_file(filepath: Path) -> int:
    errors = 0
    text = filepath.read_text(encoding="utf-8")
    for line_no, line in strip_code_blocks(text):
        for pattern, (suggestion, reason) in RULES.items():
            for match in re.finditer(pattern, line):
                print(
                    f"[ERROR] {filepath}:{line_no} 命中 '{match.group(0)}' "
                    f"-> 建议改为 '{suggestion}' ({reason})"
                )
                errors += 1
    return errors

if __name__ == "__main__":
    # 支持传入指定文件,不传则扫描当前目录所有 md 文件
    targets = [Path(p) for p in sys.argv[1:]] if len(sys.argv) > 1 else list(Path(".").rglob("*.md"))
    total_errors = 0
    for file in targets:
        if file.suffix.lower() == ".md" and file.exists():
            total_errors += check_file(file)

    if total_errors > 0:
        print(f"\n共发现 {total_errors} 处技术文档易错词,请修正后再提交。")
        sys.exit(1)
    print("文档词汇检查通过。")
方案 B:专业文档团队用 Vale Linter 规则(TechTerms.yml)
如果团队已经用上了 Vale 做文档工程化检查,直接新建一个规则文件 styles/Base/TechTerms.yml,放入以下配置即可接管替换检查:
extends: substitution
message: "建议替换为 '%s'(当前误用:'%s')"
level: error
ignorecase: false
swap:
  登陆: 登录
  阀值: 阈值
  帐号: 账号
  较验: 校验
  Github: GitHub
  Mysql: MySQL
  Json: JSON
  IOS: iOS
高频关联问题拓展
1. 团队推行词表检查时,大家嫌烦、绕过提交怎么办?
避坑点在于别搞“文字狱”。千万别一上来就把 warning 全设成 error 阻断提交。正确做法是分级管控:
- Error 级(直接卡死 CI):仅限绝对错误的硬伤(如
阀值、登陆、帐号、IOS、品牌名拼错)。 - Warning 级(只提醒不卡死):如模糊词(“可能”、“尽量”)、中英文空格排版问题,交给 PR 机器人评论区自动留言,不影响紧急修复合入。
2. 现在大家都在用 AI 辅助写文档,怎么防止大模型批量制造易错词?
大模型写中文技术文档最喜欢犯两个毛病:一是疯狂输出“赋能、鲁棒性、值得注意的是”这类空话;二是瞎编参数默认行为或者把专有名词大小写搞混。
直接在团队的文档生成 Prompt 模板末尾强制加上这段约束,能省掉一半改稿时间:
【写作强约束】
1. 禁止使用以下模糊与空洞词汇:可能、大概、理论上、尽量、鲁棒性、赋能、抓手、值得注意的是、综上所述。
2. 严格区分概念:认证(Authentication)与授权(Authorization)、重启(Restart)与重载(Reload)、并发与并行,禁止混用。
3. 严格遵守拼写:登录(非登陆)、阈值(非阀值)、账号(非帐号)、MySQL、JSON、GitHub、iOS。
4. 涉及版本号时必须给出占位符(如 vX.Y.Z),禁止使用“最新版本”、“当前版本”。
3. 老项目几百篇历史文档全是坑,怎么低成本清洗?
别傻乎乎地从头到尾全人工重读一遍,性价比极低。按这个优先级洗:
- 先用工具无脑过一遍排版:装一个
autocorrectCLI 工具,执行autocorrect --fix ./docs,先把中英文混排空格、全角标点一次性洗干净。 - 用上面那套 Python 脚本跑一遍全库:先把确定的硬伤错别字(阈值、登录、账号)批量定位替换掉。
- 只人工精修高流量文档:去文档站后台或者工单系统里拉一下近 3 个月阅读量 Top 20 和被客户/同事吐槽最多的文档(通常是 QuickStart、部署手册、鉴权说明),重点人工排查“重启/重载”、“空值定义”、“模糊词”这类逻辑硬伤,其余归档老文档直接标上
Deprecated即可。
总结
整理清楚技术文档易错词语有哪些只是第一步,真正拉开团队工程素养差距的,是把这份避坑意识变成流水线里的硬门槛。字词硬伤交给 Python 脚本和 Vale 自动拦截,概念边界和命令后果靠模板强约束,把写文档当成写代码一样做 Lint 和 Review,才能彻底终结“文档写了等于没写、越看越迷糊”的扯皮循环。