
AI营销怎么提升点击率:从动态物料生成到投放分流实操方案
要解决AI营销怎么提升点击率这个问题,最直接的办法不是去网上抄几条所谓万能提示词,而是立刻停掉“单Prompt盲抽文案”的作坊做法,改用“用户痛点结构化拆解 + 约束型批量出稿 + 多臂老虎机动态分流”这套自动化流水线。点击率低,绝大多数时候不是模型不够聪明,而是你喂给它的上下文太泛、产出的物料充满“AI塑料味”,且后端缺乏基于真实点击反馈的自动淘汰机制。
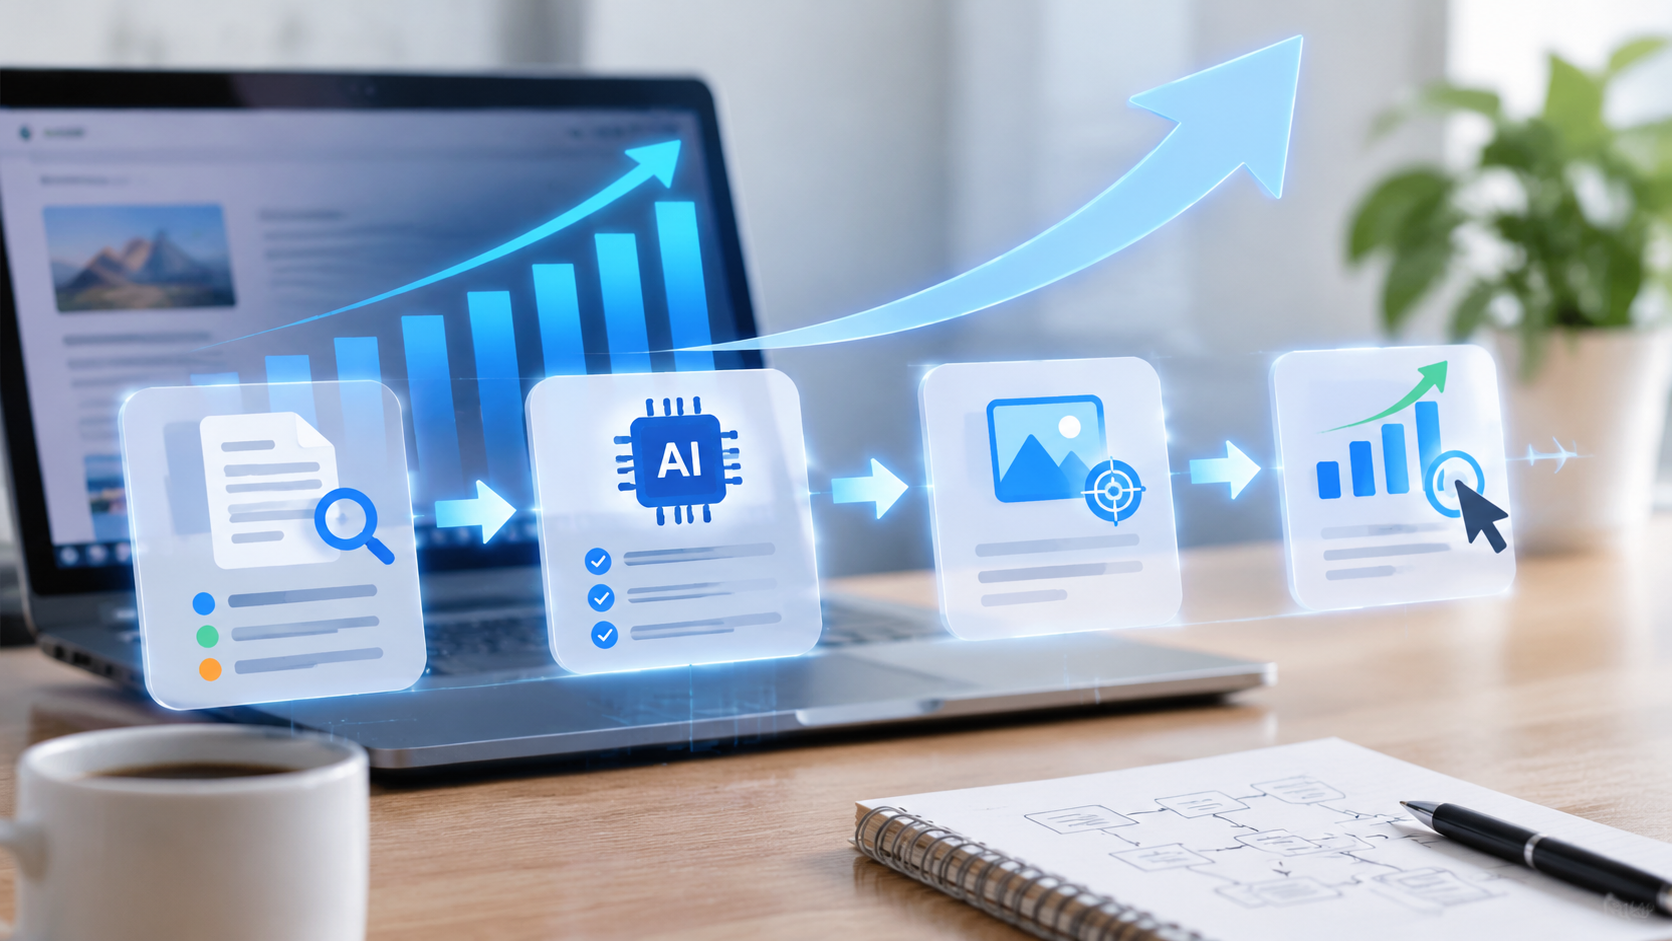
下面直接上干货,把这套能直接落地的实操方案拆给你看。
核心方案速览
现在市面上很多所谓的AI营销玩法,本质上就是把ChatGPT当成老虎机:输入一句“帮我写十个高点击率的推广标题”,然后在一堆“赋能、重塑、开启新纪元”的废话里矮子拔将军。这种物料放到信息流、邮件标题或搜索结果页里,用户一眼就能识别出是机器群发,直接划走。
想让AI真正拉高点击率(CTR),整条链路必须拆成四个刚性环节:
- 输入层洗料:把产品说明书和客服工单洗成“具体使用场景 + 损失厌恶/即时收益 + 可验证细节”的JSON结构,不让模型自由发挥。
- 生成层加锁:通过System Prompt强制禁用AI高频废话词,用固定句式批量产出不同情绪切面的变体,并用脚本做字符截断和违禁词过滤。
- 视觉层对齐:标题钩子确定后,反向生成匹配首图构图的提示词,刻意去除“AI精致感”,往原生实拍或强对比信息图靠拢。
- 投放层自动分流:不用人工盯着后台报表手动关停低效计划,直接上轻量级的多臂老虎机(Thompson Sampling)逻辑,把流量实时往点击表现好的变体上倾斜。
实操细节深度拆解
一、 卖点原子化:别把垃圾上下文喂给大模型
直接把官网介绍丢给AI写标题,结果一定是大而空的形容词。用户点不点你的链接,取决于那半秒钟内有没有看到跟自己当下处境强相关的具体利益或痛点。
操作步骤与可直接套用的Prompt: 先去收集真实素材(客服聊天记录、商品差评区、站内搜索词、竞品评论区吐槽),然后用下面这段Prompt把非结构化文本洗成“卖点原子库”:
你是一个拥有十年一线投放经验的转化文案拆解师。请阅读以下【原始产品信息与用户反馈】,从中提取可用于提升点击率的“原子化钩子”。

要求:
1. 严禁出现任何空泛形容词(如:强大、领先、优质、一站式、高效)。
2. 必须严格按照 JSON 数组格式输出,每个元素包含三个字段:
   - scene(具体到某个动作或故障发生的瞬间)
   - pain_or_gain(不解决会有什么具体麻烦,或解决后能省下什么具体动作)
   - proof_element(产品参数、机制或具体对比项,必须是原文中有的,严禁编造)

【原始信息】:
{在这里粘贴你的产品文档、工单记录或用户评价}- 适用场景:冷启动期、产品功能复杂不知如何找切入点、或者老产品素材创意枯竭时。
- 避坑点:千万不要让AI自己脑补产品参数或优惠力度。我之前在给一个SaaS客户跑自动化物料时,没加约束,模型顺手编了个“免费试用”写进广告标题,结果落地页根本没有免费版,点击率倒是短暂冲上去了,但后台全是无效注册和投诉,账户直接被平台风控警告。
二、 约束型批量生成与去“AI味”自动化脚本
拿到JSON格式的卖点原子后,接下来要批量生产物料。人工一条条改写太慢,而且不同平台(如搜索广告、信息流首图文案、EDM邮件标题)对字数限制极其敏感,超出字数被折叠,点击率直接腰斩。
1. 约束型生成Prompt模板:
基于以下【原子化钩子JSON】,为我针对不同心理动机各生成 3 条点击诱因标题,总字数严格控制在 18 个汉字以内(含标点)。

必须遵守的硬性规则:
1. 绝对禁用词:赋能、重塑、颠覆、天花板、一站式、不容错过、开启、重磅、揭秘。
2. 切入角度拆分为三类:
   - 【报错/避坑型】:直接点出用户正在踩的坑或报错场景。
   - 【反常识对比型】:用极低成本动作对比常规繁琐动作。
   - 【直接交付型】:明确告知点击后能直接拿到什么现成工具/模板/结果。
3. 语气像同事在微信里给你发消息,不要像官方新闻稿。

【原子化钩子JSON】:
{粘贴上一步输出的JSON}
2. 批量调用与自动清洗Python脚本: 光靠Prompt约束,大模型偶尔还是会抽风超字数或者漏出违禁词。做技术出身的,直接上脚本做后置硬拦截最稳妥。下面是一个可直接跑通的轻量脚本(兼容OpenAI接口协议的各类模型):
import re
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.openai.com/v1")

# 维护一个黑名单:包含AI废话词和平台高危词
BANNED_WORDS = [
    "赋能", "重塑", "颠覆", "天花板", "一站式",
    "不容错过", "开启新", "第一", "绝对", "根治"
]

def generate_and_filter_titles(prompt_text, max_len=20):
    response = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": "你是一个只输出纯净结果列表的文案生成器,每行一条,不要输出序号和多余解释。"},
            {"role": "user", "content": prompt_text}
        ],
        temperature=0.8
    )

    raw_lines = response.choices[0].message.content.strip().split("\n")
    valid_titles = []

    for line in raw_lines:
        clean_line = re.sub(r'^[\d\.\-\*\s]+', '', line).strip()
        if not clean_line:
            continue
        # 硬性长度校验,防止移动端被截断
        if len(clean_line) > max_len:
            continue
        # 黑名单词过滤
        if any(word in clean_line for word in BANNED_WORDS):
            continue
        valid_titles.append(clean_line)

    return valid_titles

if __name__ == "__main__":
    sample_prompt = "针对‘服务器内存泄漏排查慢’这个场景,写5条18字以内的技术文章点击标题,口语化一点。"
    results = generate_and_filter_titles(sample_prompt, max_len=18)
    for idx, t in enumerate(results, 1):
print(f"备选{idx}: {t}")- 适用场景:需要同时测试多套标题变体的信息流广告、EDM邮件主题行、公众号/自媒体分发标题、SEO Title/Meta Description批量优化。
- 避坑点:注意移动端截断阈值。很多运营写标题习惯把核心词放在后半句,前面先铺垫半天,结果在手机端信息流里后半句变成
...,用户根本不知道你在说什么,自然不会点。脚本里的max_len必须按投放渠道的最低显示上限来卡。
三、 视觉与文案协同:干掉信息流里的“广告盲视”
如果是带图场景(比如小红书封面、信息流广告图、B站/YouTube缩略图),光改文案没用,用户视线是先扫图再扫字。现在满大街都是Midjourney生成的赛博朋克风、完美光影假人图,用户的眼睛已经进化出自动屏蔽这种图的能力了(Banner Blindness)。
实操解法:图文钩子绑定 + 降维“真实感”提示词
不要让生图模型去画“一个开心使用软件的职场精英”,这种图点击率极低。要让图文形成“冲突感”或“现场感”:
- 文案写的是:“Excel卡死丢了半天数据?这招自动备份救命”
- 首图Prompt结构(可直接套用到 Flux / Midjourney / SD):
POV shot of a messy office desk, a laptop screen showing a frozen spreadsheet with an error popup window, slightly out of focus background, natural indoor fluorescent lighting, shot on iPhone, candid raw photo aesthetic, slight motion blur, space reserved on the top left corner for bold text overlay --no studio lighting, 3d render, glossy, stock photo- 适用场景:社交媒体封面、信息流图文/短视频首帧、电商主图测试。
- 避坑点:预留文字安全区(Negative Space)和平台UI遮挡区。很多用AI生出来的图构图满得要死,后期运营把大字往上一贴,正好糊在主体脸上,或者发布后刚好被平台右下角的点赞/头像图标挡住核心卖点字样。生成图像时务必明确留白区域,或直接把文字层级和背景拆开合成。
四、 动态分流:用多臂老虎机算法替代人工拍脑袋
物料生成了一堆,怎么知道哪条点击率最高?传统A/B测试的做法是平均分流跑一阵子,然后人工导出报表看CTR,再手动关掉差的。这中间浪费了大量曝光在垃圾物料上。
在自有站点弹窗、邮件分发、自建落地页Banner或支持API动态调价/换料的渠道中,最实用的做法是接入汤普森采样(Thompson Sampling)。它的核心逻辑很直白:每条物料都有一个成功概率分布,每次有新流量进来时,从各个物料当前的Beta分布里随机抽一个值,谁高就展示谁。点击率越高的物料,后续分到的流量会自动滚雪球般放大,同时又给新物料保留了极小比例的探索机会。
可直接嵌入后端服务的Python调度核心代码(纯标准库,零额外依赖):
import random

class CreativeRouter:
    def __init__(self, creative_ids, min_explore_impressions=50):
        # 存储每个创意的曝光数和点击数
        self.stats = {cid: {"impressions": 0, "clicks": 0} for cid in creative_ids}
        self.min_explore = min_explore_impressions

    def select_creative(self):
        # 冷启动保护:如果有创意还没达到最低探索曝光量,优先轮询展示,防止早期运气误差
        under_explored = [
            cid for cid, data in self.stats.items()
            if data["impressions"] < self.min_explore
        ]
        if under_explored:
            return random.choice(under_explored)

        # 汤普森采样阶段:根据 Beta(alpha, beta) 分布抽样
        best_cid = None
        max_sample = -1.0
        for cid, data in self.stats.items():
            alpha = data["clicks"] + 1
            beta = max(data["impressions"] - data["clicks"], 0) + 1
            sampled_ctr = random.betavariate(alpha, beta)
            if sampled_ctr > max_sample:
                max_sample = sampled_ctr
                best_cid = cid
        return best_cid

    def record_feedback(self, cid, is_clicked=False):
        if cid in self.stats:
            self.stats[cid]["impressions"] += 1
            if is_clicked:
                self.stats[cid]["clicks"] += 1

# 模拟调用流程
if __name__ == "__main__":
    router = CreativeRouter(["title_A", "title_B", "title_C"], min_explore_impressions=10)
    # 每次用户请求时获取应展示的标题ID
    chosen_id = router.select_creative()
    print(f"本次分配创意: {chosen_id}")
    # 前端埋点回传曝光/点击事件
router.record_feedback(chosen_id, is_clicked=True)- 适用场景:自建站Banner位轮播、弹窗文案动态测试、内部推送系统AB分流、广告API自动化托管后台。
- 避坑点:一定要加
min_explore_impressions冷启动兜底。如果不设最低探索曝光阈值,假设创意A在前几次曝光里凑巧被点了一下,而创意B前几次没人点,算法可能会在极早期就把创意B直接“判死刑”,导致你错失真正优质的长期素材。
高频关联问题拓展
1. 点击率拉高了,但落地页跳出率暴涨、根本不转化怎么办?
这是跑AI营销最容易踩的深坑:为了追求高点击率,把模型调教成了“标题党制造机”。 用户被刺激性的标题骗进来,落地页首屏找不到对应承诺,三秒内直接关闭。不仅浪费预算,还会把平台的质量度权重彻底拉垮。
解决办法:在物料上线前,加一道“图文与落地页一致性校验”流程。把生成好的标题和落地页首屏HTML文本同时喂给大模型打分:
请对比以下【推广标题】与【落地页首屏文本】,判断用户点击标题进入落地页后,是否在3秒内能看到预期内容。
如果不一致或标题存在夸大承诺,直接输出“不通过”并指出脱节点;完全承接则输出“通过”。

推广标题:{标题}
落地页首屏文本:{提取出的H1和首段文字}
2. 广告平台或邮件服务商频繁拒审、进垃圾箱怎么破?
很多团队用AI批量生成文案后直接上量,结果因为触碰隐晦的医疗、金融、夸大承诺词或者高频重复句式,被系统直接拦截。
解决办法:除了前面代码里的 BANNED_WORDS 硬过滤外,针对EDM或私域推送,不要让所有用户收到完全一模一样的文本。可以利用大模型在核心语义不变的前提下,生成多套同义替换模板(Spintax变体),在发送队列里随机轮换打散指纹特征,同时把高敏词替换成行业中性描述。
3. 刚起步的小团队,没有历史数据喂给AI怎么冷启动?
别对着空白文档干想。直接去抓同行的数据:
- SEO/搜索场景:用工具扒下核心词排名前十的竞品Title和Description,让AI分析它们共有的句式结构(比如都在强调“免费下载”还是“源码直出”),先模仿结构再做差异化微调。
- 社媒/电商场景:把竞品爆款视频的评论区、商品问答区爬下来几十条高频提问,直接丢进前面第一步的“卖点原子化Prompt”里。用户的真实疑问,永远是点击率最高的标题来源。
结尾总结
把整套流程跑通之后你会发现,AI营销怎么提升点击率的答案从来不是某句神秘的“咒语”。AI真正厉害的地方,在于它把过去需要一周才能走完的“洞察痛点 -> 写出多组差异化假设 -> 物料配图 -> 小流量测出优胜组”这个闭环,压缩到了极短的工程周期里。
记住一个核心原则:用结构化输入锁死模型幻觉,用代码脚本干掉AI废话和超长截断,用汤普森采样把流量自动喂给数据赢家,最后用落地页一致性校验兜住转化底线。 把这套工作流搭起来,你的点击率优化才算真正脱离玄学,变成可控的工程动作。