
AI怎么做用户画像营销:从数据清洗到自动触达的实战拆解
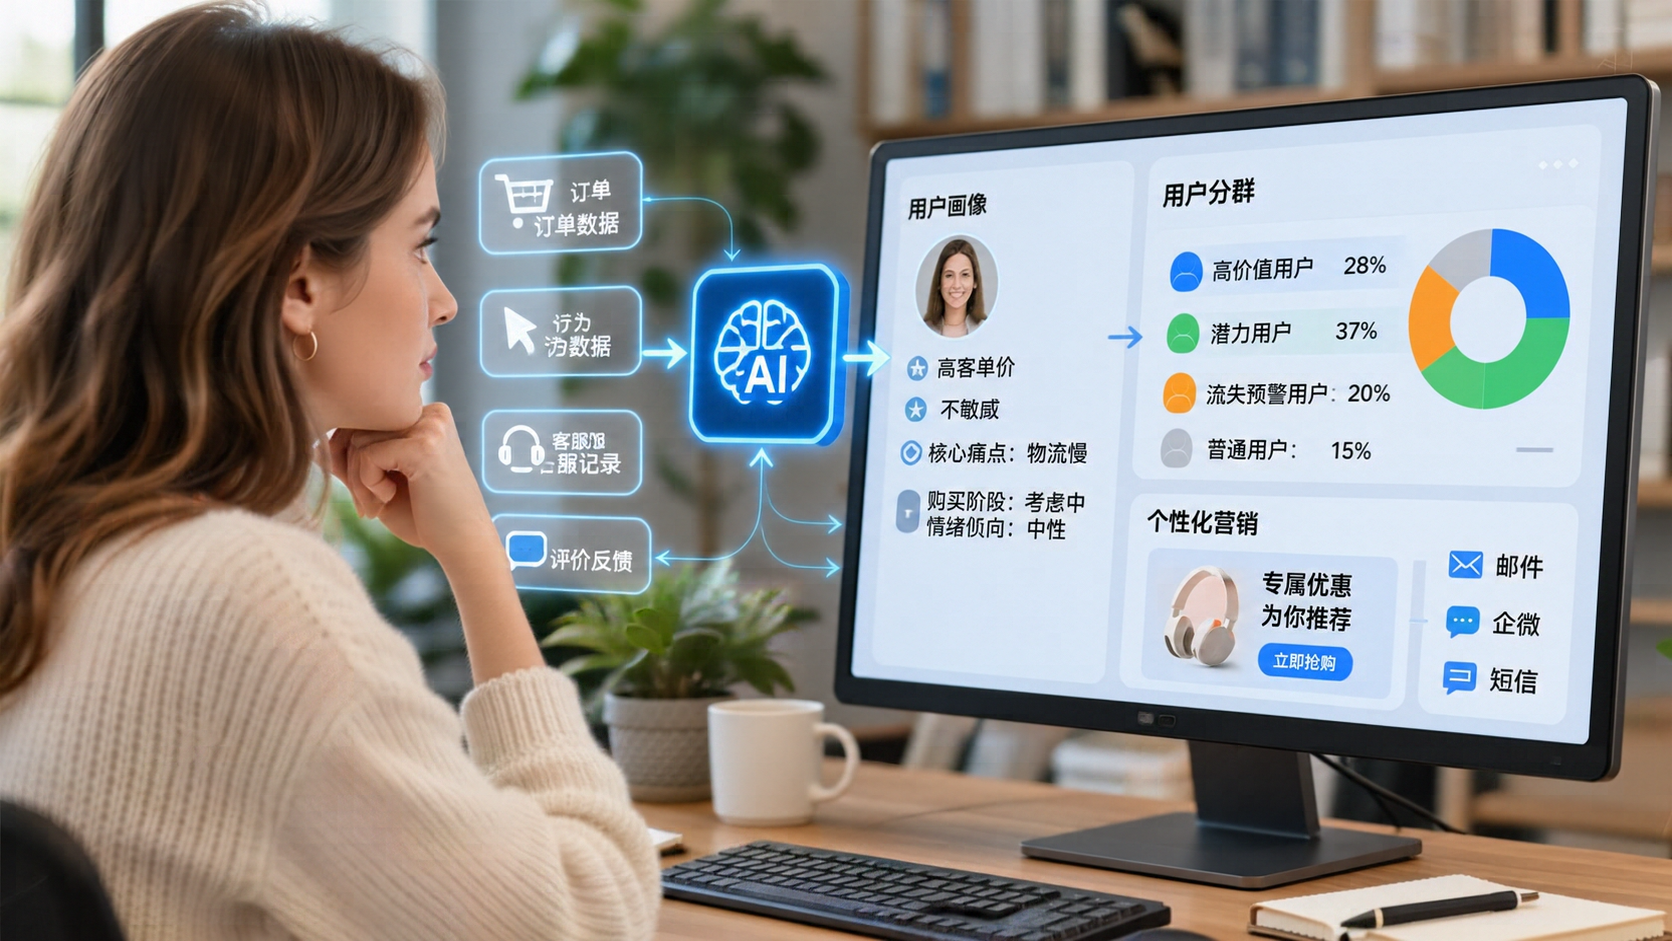
AI怎么做用户画像营销? 说白了,核心逻辑就一句话:别指望大模型直接帮你“猜”出客户喜欢什么,真正能落地的做法是“SQL/Python搞定硬指标底座 + 大模型批量清洗非结构化文本打标签 + 业务系统串联自动化千人千面触达”。
干这行久了你会发现,市面上不少卖几十万的所谓“智能CDP营销系统”,后台无非就是给你画几个花里胡哨的雷达图,最后运营导出来还是群发同一套短信模板。真想靠AI把用户画像做实、把转化抠出来,完全不需要买天价SaaS,自己用脚本接通大模型API,把散落在数据库、工单和客服聊天记录里的信息榨干,就能直接跑通闭环。
核心方案速览:跑通AI画像营销的四步流水线
在实际业务里,无论是做独立站、国内电商还是B2B软件服务,落地一套好用的AI用户画像系统,架构上就分四层,缺一不可:
- 数据汇聚与脱敏层:把订单表、行为埋点、客服聊天记录、评价反馈聚到一起,先把手机号、姓名等敏感信息全部替换成内部
user_id。 - 双引擎打标层(核心):
- 硬标签(消费频次、客单价、最近登录天数):直接用 SQL 或 Python 算,绝对不要交给AI算。
- 软标签(价格敏感度、核心痛点、购买决策阶段、情绪倾向):把非结构化文本丢给大模型,强约束输出标准化 JSON 标签。
- 动态分群与策略层:把“硬标签 + 软标签”组合起来(例如:
高客单价 + 价格不敏感 + 抱怨物流慢),绑定对应的营销动作。 - 个性化生成与触达层:用结构化 Prompt 让 AI 根据单人画像生成针对性文案,通过 Webhook 推给企微、邮件或短信通道,并做 A/B 对照测试验证效果。
实操细节深度拆解:代码、Prompt与踩坑点
一、 先把硬指标算准,别拿大炮打蚊子
很多团队一上来就想把几十万条订单流水直接塞给大模型分析“谁是高价值客户”,结果就是接口报错、Token 烧光,算出来的总数还经常幻觉出错。算数和统计永远是 SQL 和 Python 的强项。
- 适用场景:任何有交易记录、登录日志或浏览记录的业务系统。
- 避坑点:字段口径必须统一(比如订单金额是算实付还是应付,是否剔除退款单),否则后面的 AI 标签全建立在脏数据上。
下面是一段直接能用的 SQL 模板(以 MySQL 为例),用来提取基础的 RFM 指标和活跃状态,作为用户画像的底座:
SELECT
    user_id,
    -- 最近一次消费距今的天数 (Recency)
    DATEDIFF(CURDATE(), MAX(pay_time)) AS recency_days,
    -- 统计周期内的有效消费次数 (Frequency)
    COUNT(DISTINCT order_id) AS order_count,
    -- 累计实付金额 (Monetary)
    SUM(actual_pay_amount) AS total_spent,
    -- 客单价
    ROUND(SUM(actual_pay_amount) / COUNT(DISTINCT order_id), 2) AS avg_order_value,
    -- 简单的规则标签:是否属于沉默高潜客户
    CASE
        WHEN DATEDIFF(CURDATE(), MAX(pay_time)) > 60 AND SUM(actual_pay_amount) > 1000 THEN '高价值流失预警'
        WHEN COUNT(DISTINCT order_id) >= 3 THEN '复购老客'
        ELSE '普通用户'
    END AS base_segment
FROM orders
WHERE order_status = 'COMPLETED' -- 剔除未支付和已全额退款订单
  AND pay_time >= DATE_SUB(CURDATE(), INTERVAL 1 YEAR)
GROUP BY user_id;
二、 用大模型榨干“非结构化文本”里的软标签
传统用户画像最大的痛点,是知道客户“买了什么、花了多少钱”,但不知道他“为什么买、卡在哪里犹豫、讨厌什么”。这些信息全藏在客服对话、售后工单、商品评价和调研问卷里。以前靠人工翻,根本看不过来,这就是 AI 最值钱的切入点。
- 适用场景:电商/SaaS 客服聊天记录归档、用户差评分析、销售跟进记录整理。
- 踩坑经验:
- 必须强约束枚举值。如果你不限定标签选项,AI 今天给你输出“有点贵”,明天输出“价格敏感”,后天输出“嫌预算高”,数据库里根本没法按标签筛选人群。
- 温度参数(
temperature)必须调低,建议设在0.1到0.2之间,保证输出稳定。 - 强制开启 JSON 输出模式,方便脚本直接解析入库。
下面是一段可直接运行的 Python 实操脚本(兼容 OpenAI 接口规范的模型均可使用,如 DeepSeek、通义千问或 OpenAI):
import json
from openai import OpenAI

# 初始化客户端(替换为你自己的 API Key 和 Base URL)
client = OpenAI(
    api_key="your_api_key_here",
    base_url="https://api.deepseek.com/v1" # 示例地址,可按需替换
)

def extract_user_tags(user_id: str, raw_texts: str) -> dict:
    system_prompt = """
    你是一个资深的用户运营数据分析师。请根据提供的用户历史客服对话或评价文本,提取结构化的用户画像标签。
    必须严格输出合法的 JSON 格式,不要包含任何额外的解释说明。

    字段及可选枚举值规定如下(若文本中无法判断,请填 "未知"):
    - price_sensitivity: ["高敏感", "中等", "不敏感", "未知"]
    - core_pain_point: ["功能/质量问题", "操作复杂度", "售后响应慢", "价格/性价比", "物流时效", "无明显痛点", "未知"]
    - decision_role: ["个人终端用户", "企业决策者", "企业执行采购", "帮他人代买", "未知"]
    - sentiment_trend: ["正向满意", "中性客观", "负面投诉", "流失风险高"]
    - summary_note: 用不超过20个字概括该用户最在意的点。
    """

    user_prompt = f"用户ID(已脱敏):{user_id}\n历史文本记录:\n{raw_texts}"

    response = client.chat.completions.create(
        model="deepseek-chat", # 按实际使用的模型名称替换
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": user_prompt}
        ],
        temperature=0.1,
        response_format={"type": "json_object"}
    )

    try:
        result = json.loads(response.choices[0].message.content)
        result["user_id"] = user_id
        return result
    except json.JSONDecodeError:
        return {"user_id": user_id, "error": "JSON解析失败"}

# 实操测试示例
sample_chat = """
用户:你们这个专业版一年续费怎么涨价了?去年才不是这个价。
客服:亲,今年升级了自动化报表功能呢。
用户:那些花哨功能我团队根本用不上,我就要基础导出数据稳定点就行,上次导出还卡顿了两次,要是没优惠我就不续了,换别家试试。
"""

tags = extract_user_tags("U_9527", sample_chat)
print(json.dumps(tags, ensure_ascii=False, indent=2))
跑完这段脚本,原本一团乱麻的聊天记录,直接变成了干净的 JSON 字段:price_sensitivity: "高敏感"、core_pain_point: "功能/质量问题"、decision_role: "企业执行采购"、sentiment_trend: "流失风险高"。把它写回数据库,跟前面的 SQL 硬指标表做个 JOIN,一个立体的活人画像就出来了。
三、 画像落地到“千人千面”触达(附直接可用的Prompt)
标签打完了,如果不变成前端的触达动作,那就是自嗨。很多运营用 AI 写营销文案被用户疯狂拉黑,是因为直接扔一句“帮我写个促销短信”,结果 AI 吐出来全是“尊敬的VIP用户您好!值此佳节来临之际,为您献上尊享好礼……”,一股浓浓的群发垃圾短信味。
- 适用场景:私域企微1v1激活、高价值流失老客召回、外贸/独立站弃购挽回邮件。
- 避坑点:严禁 AI 使用敬语套话,必须把具体的标签和业务钩子塞进 Prompt,同时用 Few-shot(少样本示例)固定说话语气。
可以直接套用的文案生成 Prompt 模板:
# 角色设定
你是公司的资深客户成功顾问,正在通过企业微信给老客户发一条私信。说话要像真实的业务对接人,简短、口语化、不卑不亢,直击痛点。

# 绝对禁令
1. 严禁出现“尊敬的”、“亲爱的”、“值此之际”、“重磅来袭”、“感恩回馈”等群发广告词。
2. 严禁使用感叹号超过1个,不要发任何表情包。
3. 字数严格控制在 80 字以内。

# 当前客户画像数据
- 称呼:张总(若无姓氏则不加称呼)
- 基础分层:高价值流失预警(上次续费距今已超60天)
- 价格敏感度:高敏感
- 核心痛点:抱怨上次导出数据卡顿,且觉得新升级的高级功能用不上
- 营销钩子(本次可提供的权益):老客户专属基础版续费8折券,且新版本刚修复了大文件导出内存溢出问题。

# 参考语气示例(模仿这种节奏)
"王哥,看你上个月问过批量导出卡顿的事,技术这边上周刚把底层引擎重做了,现在几万条数据秒出。另外老客续基础版我这边给你留了个八折名额,不用多花钱买那些高阶功能,这两天要用的话我把链接发你?"

# 任务
结合【当前客户画像数据】和【营销钩子】,严格模仿【参考语气示例】的风格,生成一条可直接发送的企微触达消息。
你看对比效果:普通群发是“续费立减,快来抢购”;而结合画像生成的文案,直接点破了客户上次遇到的卡顿问题,顺带告诉他“不用为不需要的功能买单”,再给个专属折扣。这种消息发过去,打开率和回复率完全不在一个量级。
高频关联问题拓展:实操中一定会遇到的三个坑
1. 冷启动期用户量太少、没历史聊天记录怎么办?
刚起盘的新项目或者新站点,数据库里空空如也,AI 巧妇难为无米之炊。 实操解法:别在内部硬憋,去抓外部公开的“行业原型画像”。把竞品评价区(淘宝/京东/Amazon/G2/小红书评论区)的几千条真实评价爬下来,用上面的打标脚本跑一遍,你就能快速摸清目标人群都在骂什么、在意什么。先按这批共性痛点定好初始标签体系和落地页文案,等自己跑出第一批种子用户后,再逐步替换成自有数据。
2. 把客户数据传给大模型API,会不会有隐私合规风险?
这个问题在国内做合规和出海做 GDPR(欧盟通用数据保护条例)时极其致命。绝对不能把客户的真实姓名、手机号、身份证号、详细住址直接拼进 Prompt 传给第三方公有云模型!
实操解法:在送入大模型之前的预处理脚本里,先过一遍正则脱敏。把手机号、邮箱、微信ID全部替换成 [PHONE]、[EMAIL],姓名换成 [NAME],数据库只传一个无意义的随机 UUID。模型打完标签返回 JSON 后,再在本地内网环境里用 UUID 映射回真实用户。如果公司预算充足且数据极其敏感,直接用开源模型(比如 Qwen 或 Llama 系列)在本地 GPU 服务器私有化部署推理服务,数据完全不出内网。
3. 怎么科学评估AI画像营销到底有没有用?(避免团队自嗨)
千万别信某些工具后台自己算出来的“AI匹配精准度”,那东西怎么算全靠写代码的人拍脑袋。 实操解法:老老实实上 A/B Test 对照组。把同一批满足条件的用户(比如“高价值流失预警”)随机均分成 A、B 两组:
- A组(对照组):发运营以前写的通用召回文案。
- B组(实验组):发 AI 结合软硬标签生成的个性化文案。 跑完一轮触达后,别光看虚头巴脑的“打开率”,死盯三个硬指标:有效回复率、最终下单转化率、用户拉黑/退订率。只有 B 组转化明显跑赢 A 组,且拉黑率没有飙升,这套链路才算真正跑通了;如果转化没差甚至还不如人工通发,说明你的标签维度选错了,或者 Prompt 写得太假,赶紧回头改 Prompt 和筛选规则。
结尾总结
聊到底,AI怎么做用户画像营销,从来不是买一套多贵的智能软件就能躺赢的事。大模型解决的只是以前“人眼看不过来非结构化信息”和“手工写千人千面文案成本太高”这两个瓶颈。
真正决定这套系统能不能赚钱的,依然是老生常谈的基本功:底层订单和行为数据够不够干净、业务标签的枚举设计合不合理、触达的时机和话术克不克制。建议大家别一上来就想搭什么大而全的全自动营销中台,先把最近几个月的客服聊天记录或者差评导出来,用上面给的 Python 脚本跑一遍标签,挑一批流失老客做一次小规模的 A/B 触达测试。链路跑通了、看到真实回报了,再把自动化工作流接上去,这才是技术人员和务实运营该走的路子。