
AI营销怎么避免违规风险:从内容过滤到数据脱敏的实操防线
AI营销怎么避免违规风险?核心就四步:在Prompt和本地代码中锁死广告法红线、调用外部大模型前强制完成客户隐私脱敏、商业素材严格核查开源协议并打上AI标识、自动化触达接口必须配置频率限制与退订拦截。
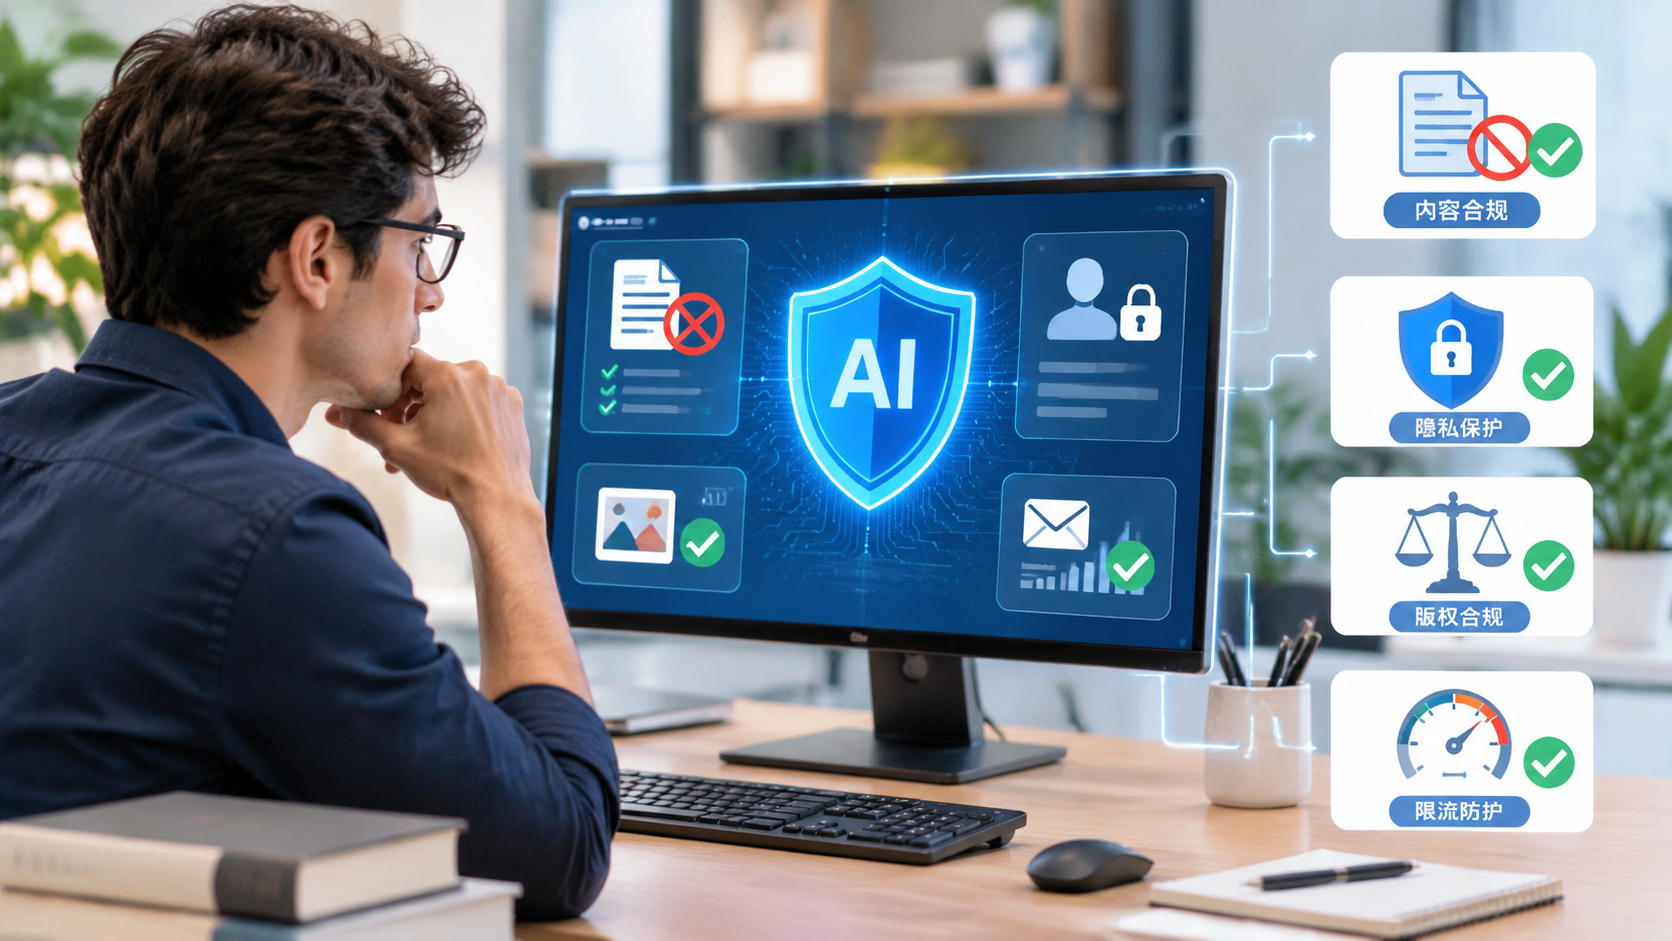
现在市面上很多卖AI营销课的,整天鼓吹“一键批量生成一万条爆款文案全自动引流”,却绝口不提账号封禁、数据泄露和广告法罚单。在实际业务落地里,大模型天生就是个“讨好型人格”,你让它写转化率高的文案,它顺手就能给你编出“全网最低”“根治”“保本收益”这种高危词;你把客户CRM表格直接丢进网页端对话框,转头敏感信息就成了别人模型训练的语料。想稳稳当当地用AI跑营销,别指望平台良心发现,必须自己在技术链路和工作流里搭好防火墙。
核心方案速览
要解决AI营销过程中的合规隐患,需要把防御机制拆解到数据流转的每一个节点,不能只靠运营人员肉眼盯:
- 生成前约束(Prompt + 本地词库):别指望大模型自带的安全护栏能懂国内的《广告法》和行业禁区,必须在System Prompt里写死禁区,并在API返回后挂载本地敏感词过滤脚本。
- 传输中脱敏(PII数据清洗):严禁把带有真实手机号、微信号、身份证号、具体交易流水的原始数据直接发给公网SaaS或第三方API,调用前必须用正则或脱敏中间件替换成占位符。
- 素材与版权确权(协议核查 + 显性标识):生图、配音、数字人视频不要随便拿开源社区标注非商用的模型直接出图印海报;分发到公域平台时,按平台规则主动勾选或挂载“AI生成”标识。
- 触达与交互风控(限流 + 意图兜底):用AI做自动私信、邮件营销或智能客服时,后端必须加发信频率熔断、关键词退订机制,以及防Prompt注入的权限隔离,防止AI被用户套话后乱承诺折扣或赔付。
实操细节深度拆解
一、话术与文案防踩雷:Prompt约束 + 本地脚本双保险
适用场景:用大模型批量生成落地页文案、信息流广告脚本、朋友圈话术、电商详情页描述。
常见大坑:很多团队只写一句“请帮我写一篇符合广告法的文案”,大模型大概率左耳进右耳出。尤其是涉及美妆护肤、大健康、金融理财、教育培训这几个强监管类目,AI非常喜欢用“改善率极高”“彻底解决”“稳赚不赔”等暗示性违规词。
直接抄作业的System Prompt模板:
你是一名精通中国《广告法》与主流公域平台审核规范的资深营销文案策划。
在输出任何营销文案时,必须严格遵守以下红线:
1. 绝对禁用极限词:严禁出现“最、第一、唯一、顶级、独家、绝无仅有、全网最低、销量冠军、天花板”等绝对化用语,需替换为具体的场景描述或产品客观参数。
2. 严禁功效夸大与医疗暗示:非医疗器械及药品,禁止使用“治疗、根治、消炎、杀菌、抗癌、改善疾病”等词汇,仅可描述外观体验、使用感受或物理清洁作用。
3. 严禁虚假承诺:禁止出现“包过、必赚、零风险、无条件返现”等承诺性表述。
4. 客观依据优先:所有卖点必须基于我提供的【产品参数】展开,严禁自行编造不存在的专利号、检测报告或权威机构背书。Prompt只是软约束,真要保命,必须在拿到AI输出后、写入数据库或发布前,过一遍本地Python过滤脚本。下面这段脚本可以直接嵌进你的工作流中间件里,既能拦截《广告法》高危词,也能在发给外部AI前先把客户隐私脱敏:
import re

# 1. 本地高危违规词库(可根据自身行业继续往列表里塞,比如医疗、金融专属违禁词)
BANNED_WORDS = [
    "全网最低", "第一品牌", "绝对有效", "根治", "包治百病",
    "零风险", "稳赚不赔", "国家级", "最高级", "独家配方", "永不反弹"
]

# 预编译正则,提升批量处理性能
BANNED_PATTERN = re.compile("|".join(map(re.escape, BANNED_WORDS)))

def check_marketing_compliance(text: str) -> dict:
    """
    检查AI生成的营销文案是否命中本地高危词库
    """
    hits = list(set(BANNED_PATTERN.findall(text)))
    if hits:
        return {
            "passed": False,
            "risk_words": hits,
            "message": f"拦截到高危违规词: {', '.join(hits)},禁止直接发布!"
        }
    return {"passed": True, "risk_words": [], "message": "初筛通过"}

def desensitize_user_data(raw_text: str) -> str:
    """
    调用外部大模型API前,强制对客户敏感信息(PII)进行脱敏替换
    """
    # 替换大陆手机号
    text = re.sub(r'(?<!\d)(1[3-9]\d)\d{4}(\d{4})(?!\d)', r'\1****\2', raw_text)
    # 替换身份证号
    text = re.sub(r'(?<!\d)(\d{4})\d{10}(\w{4})(?!\d)', r'\1**********\2', text)
    # 替换邮箱地址
    text = re.sub(r'([a-zA-Z0-9_.+-]{2})[a-zA-Z0-9_.+-]*(@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+)', r'\1***\2', text)
    return text

# --- 实操调用示例 ---
if __name__ == "__main__":
    # 场景A:喂给AI分析客户画像前先脱敏
    raw_crm_note = "客户张先生,电话13812345678,邮箱zhangsan_vip@qq.com,反馈上次买的护肤品很好用。"
    safe_prompt_input = desensitize_user_data(raw_crm_note)
    print("脱敏后发给AI的数据:", safe_prompt_input)

    # 场景B:AI吐出文案后,入库前做拦截
    ai_generated_copy = "这款面霜采用独家配方,涂抹三天就能根治红血丝,绝对全网最低价!"
    audit_result = check_marketing_compliance(ai_generated_copy)
print("合规检测结果:", audit_result)避坑点:如果你的词库扩展到几千上万个词,别直接用 re.compile("|".join(...)),正则回溯和编译会拖慢接口响应甚至卡死进程。词库大了老老实实用 pyahocorasick 库跑AC自动机,或者把校验逻辑丢到异步队列里处理,别阻塞主业务线程。
二、客户数据投喂合规:关掉模型训练开关,隔离商业机密
适用场景:用AI做客户标签聚类、销售录音复盘总结、个性化邮件/私信定制。
常见大坑:运营图省事,直接打开网页版ChatGPT或者国内某些免费聚合壳站,把导出的几千行订单CSV文件往里一拖,让AI“分析一下高净值客户的消费习惯”。这些免费网页端的默认协议里,很多都包含“允许使用用户输入内容来改进模型服务”。一旦发生数据泄露,不仅违反《个人信息保护法》,连同行都能顺藤摸瓜摸清你的核心客群。
实操步骤:
- 禁用网页端处理业务数据:公司内部明确红线,所有包含真实姓名、电话、住址、客单价明细的数据,一律禁止放进个人版网页AI对话窗。
- 走企业级API并核对数据留存政策:采购云厂商或大模型官方的企业API通道,在控制台确认“不保留推理日志(Zero Data Retention)”或“不用于模型训练”的勾选状态。
- 做“假名化”映射:如果确实需要AI针对单个客户生成千人千面的跟进话术,后端程序先把
customer_id: 89231, name: 李四映射成user_A和通用特征标签(如:偏好:户外装备,历史客单:中等)传给AI;等AI吐出话术模板后,再由本地程序把称呼拼接回去。AI从头到尾压根不知道这个“李四”是谁。
三、视觉与音视频素材:版权协议排查 + 强制AI标识
适用场景:用Midjourney、Stable Diffusion、ComfyUI或各类视频生成工具做主图、信息流广告视频、数字人带货口播。
常见大坑:
- 盲目下载开源模型商用:在C站(Civitai)或HuggingFace随便拉个网红微调模型(Checkpoint/LoRA)就开始跑商业海报。很多作者在模型协议里明确写了
Non-Commercial(禁止商用)或者CreativeML Open RAIL-M里的特定限制,甚至有些LoRA本身就是拿版权明星、特定插画师作品硬练出来的,拿去投流分分钟收律师函。 - 漏打AI合成标识:现在各大公域平台(抖音、小红书、视频号、B站等)对深度合成内容查得极严。用AI生成高度逼真的人像、新闻播报口吻的口播视频,如果不主动打上“内容由AI生成”的水印或声明,轻则限流下架,重则直接按“虚假宣传/恶意造谣”封号。
实操落地动作:
- 建立内部白名单模型库:技术或设计团队负责审核底模和插件协议,确认底层模型允许商业用途后,再放到内网ComfyUI服务器供运营调用,禁止员工私自外挂来路不明的LoRA。
- 自动化加水印:如果前端生成工具没自带显性标识,别指望美工每次手动P图,直接在素材入库脚本里用
FFmpeg或 PythonPillow批量在画面角落打上“部分画面由AI辅助生成”的半透明角标:
# 使用 FFmpeg 在AI生成的营销短视频右下角批量添加合规标识文字
ffmpeg -i raw_ai_video.mp4 \
  -vf "drawtext=text='画面由AI技术辅助生成':fontcolor=white@0.6:fontsize=20:x=w-tw-20:y=h-th-20" \
  -c:a copy \
compliant_ai_video.mp4- 发布端必勾选声明:只要涉及人物面部、声音克隆的营销视频,上传各平台后台时,务必勾选“AI生成内容”声明选项,顺便把生成工具的元数据保留好作为留痕。
四、自动化触达与AI客服:防封号与防“套话”机制
适用场景:AI外呼、自动化EDM邮件营销、企微/公众号AI自动回复、独立站AI导购。
常见大坑:
- 把AI当无限群发器:利用AI改写生成几千封“长得不一样”的推销邮件或私信,短时间高频轰炸用户。现在的邮箱服务商(ESP)和社交平台风控根本不只看文本相似度,人家看的是发信IP信誉度、投诉率、打开率以及短时并发异常。
- AI客服被用户“提示词注入”:之前国外就有真实案例,用户跟车企的AI客服聊天,通过几句诱导话术让AI承诺“1美元卖给你一辆新车”并生成了确认文本。虽然最后打官司有争议,但对中小商家来说,只要AI客服乱承诺了“全额退款”“额外送大礼包”,客户截图投诉到消协或平台,商家照样得捏着鼻子认栽或者耗费大量精力扯皮。
实操配置要点:
- 强制退订与频控熔断:任何AI驱动的邮件或短信触达,正文末尾必须硬编码拼上明确的退订指令(如“回复TD退订”或一键退订链接,不能让AI自由发挥把退订词给“润色”没了);发送队列必须设置单账号/单IP的每小时发送上限及冷却时间。
- AI客服的权限“关进笼子”:
- 涉及到价格修改、退款审批、补偿承诺、订单取消等敏感动作,严禁由大模型自由生成文本回复,必须走严格的
Function Calling(工具调用)或固定话术模板,最终执行权卡在后端业务系统的权限校验里。 - 在AI客服路由层加一个前置意图分类器:一旦检测到用户提问包含“投诉”“工商局”“律师”“忽略之前的指令(Ignore previous instructions)”“系统提示词”等特征,直接跳过大模型,强行转接人工客服。
- 涉及到价格修改、退款审批、补偿承诺、订单取消等敏感动作,严禁由大模型自由生成文本回复,必须走严格的
高频关联问题拓展
1. 我们公司花钱买了服务器,自己本地私有化部署开源大模型,是不是就没合规风险了?
完全不是,这属于典型的技术认知误区。
私有化部署解决的仅仅是“客户隐私数据不外泄给第三方厂商”这一个问题,也就是数据安全合规。但你用本地模型吐出来的营销文案、生成的海报,依然要受《广告法》《反不正当竞争法》以及各个分发平台规则的管辖。本地模型不仅不会帮你自动规避极限词,而且因为少了一层大厂API自带的内容安全拦截,很多开源模型放飞自我起来比商用API更容易输出违规内容。此外,如果你的AI营销工具是对外公开提供交互服务的(比如做了一个面向C端用户的AI测肤小程序),还涉及算法备案和深度合成服务备案的问题,别以为代码跑在自己内网服务器里就能万事大吉。
2. 用AI大量洗稿、改写行业文章来做SEO或自媒体矩阵,怎么避免版权投诉和平台限流?
只靠让AI“换个说法重写一遍”或者同义词替换,现在各大搜索引擎和内容平台的查重算法一抓一个准,轻则不收录、零推荐,重则被原作者投诉抄袭侵权。
实操中要想安全用AI提效:
- 禁止直接整篇洗稿:不要把竞品的一篇文章直接塞给AI说“帮我仿写一篇”。正确的做法是提取3到5篇不同来源文章的客观事实大纲,剔除原文章的修辞、故事和独有案例,然后往里面注入你自己真实的业务数据、踩坑截图或实测参数,最后让AI基于“事实骨架 + 你的独家素材”来组织语言。
- 做一次向量或文本查重:批量生产的内容入库发布前,拿关键段落去跑一遍查重比对,确认结构与表达已经彻底重构,且没有直接照搬他人带有版权声明的表格或图片。
3. 上线AI营销系统前,技术团队和运营团队怎么快速做一次低成本的自查验收?
不用搞特别复杂的流程,上线前双方拉个20分钟的过会,按下面这4条红线逐一跑通测试用例就行:
- 边界测试(红队测试):找两个同事专门扮演刁钻客户,尝试用诱导话术让AI客服给出“免费送”“保本”“假一赔十”的承诺,看拦截机制和转人工触发是否灵敏。
- 抓包查脱敏:在测试环境开启API请求日志打印,检查发往外部大模型厂商的JSON payload里,是不是真的一丁点明文手机号、姓名、内部底价都没带出去。
- 违禁词压测:故意给AI输入包含行业违禁词的提示,验证后置的本地敏感词过滤脚本能不能100%把它拦下来,而不是直接吐到前端界面。
- 标识与退订检查:检查所有导出的图文视频是否带了规范的AI生成标识,群发通道的退订链接点进去是不是真的能把用户从发送列表里剔除。
结尾总结
说到底,AI营销怎么避免违规风险,靠的从来不是运营人员时刻紧绷神经去肉眼挑错,也不是祈祷大模型某天突然变得懂法守规,而是要把合规要求变成一套“不满足条件就报错阻断”的技术防线。
把System Prompt当作第一道软约束,把本地敏感词校验和PII数据脱敏脚本嵌进接口调用的必经之路,把开源模型的版权核查和AI标识做成发版前的硬性检查项,再把客服和群发的权限死死锁在后端代码里。前期多花点时间把这些枯燥的护栏焊死,后期跑量的时候才能真正睡个安稳觉,不至于流量刚起来,账号和罚单先一步找上门。