
如何准确判断关键词竞争难度:绕开软件虚高评分的实操排查法
如何准确判断关键词竞争难度,最直接的结论就是彻底抛弃第三方工具给出的单个“难度评分”,直接动手拆解搜索引擎结果页前十名的真实构成与薄弱环节。市面上绝大多数SEO工具或词库软件算出来的KD值(Keyword Difficulty),底层逻辑无非是统计排名前十页面的外链数量和域名权重。但在真实业务场景里,外链多不代表内容贴合需求,权重高也不代表不能被精准长尾击穿。真正决定一个词能不能做、值不值得投入精力,看的是搜索意图是否被垄断、前排页面有没有“软柿子”,以及你的内容形式能不能碾压现有结果。
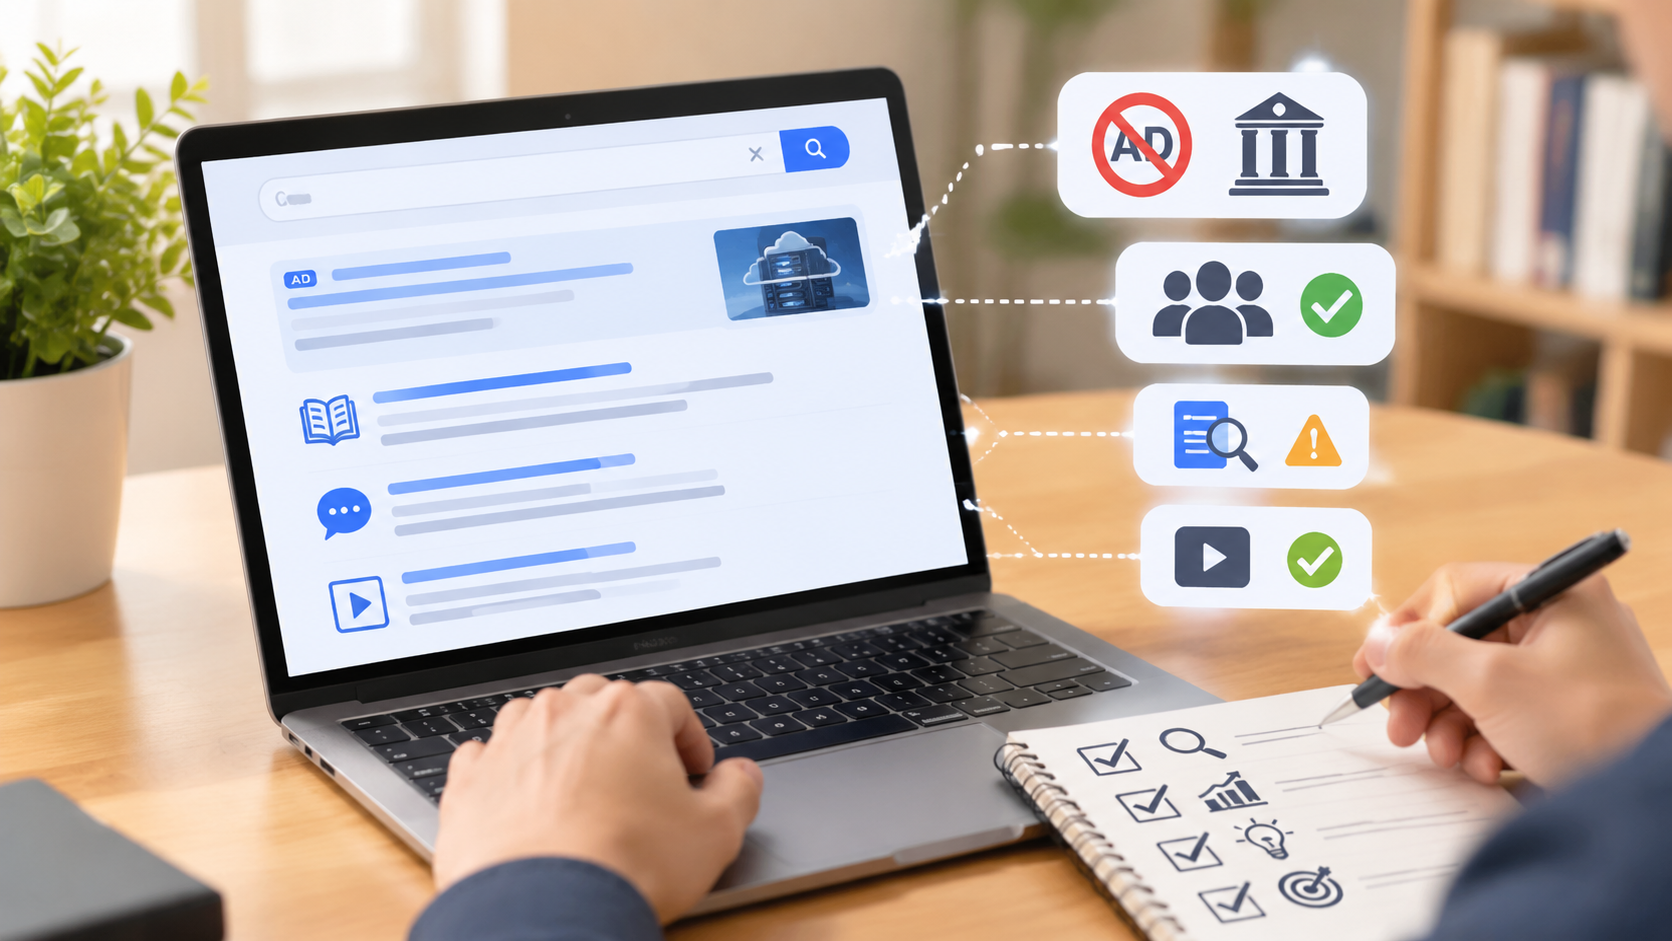
核心方案速览
在实际项目排查中,想要不踩坑,直接按以下四步走,比盯着软件仪表盘发呆管用得多:
- 排雷商业与平台垄断词:先看搜索结果第一屏是不是被竞价广告、官方百科、地图、软件下载卡片或AI直接回答塞满。自然结果被挤到首屏之外的词,竞争难度和投入产出比直接失衡,优先放弃。
- 用高级指令摸清真实对手数量:不要看搜索引擎显示的“找到相关结果数千万条”,那个数字毫无参考价值。用
intitle:指令去查真正刻意针对这个词做过标题优化的页面有多少。 - 抓出前十名里的“软柿子”:看自然排名前十里,有多少是论坛贴吧、知乎问答、CSDN随笔、内页甚至标题根本没完整包含关键词的页面。只要存在这类页面,说明这个词存在明显的内容供给缺口。
- 核对自身资源与内容形态匹配度:看前排清一色是工具站、视频、下载包还是长图文。如果你只有图文博客,硬刚全是交互式在线工具的结果页,哪怕工具显示竞争度极低也做不上去。
实操细节深度拆解
1. 用高级搜索指令剔除“伪竞争对手”
很多运营刚上手时,习惯直接搜一下关键词,看到相关结果动辄几百万条就吓退了,或者反过来看到工具标注“竞争度低”就一头扎进去,结果发现根本做不动。要做到如何准确判断关键词竞争难度,第一步是学会用搜索指令过滤掉那些只是正文里顺带提了一嘴的无关页面。
可直接套用的指令模板:
# 1. 查看标题中明确包含完整关键词的网页数量(最核心的直接竞争对手)
intitle:"nginx 502 bad gateway 排查"

# 2. 查看标题包含所有关键词分词(不要求连续)的网页
allintitle:nginx 502 排查

# 3. 排查特定高权重平台是否已经把控该词(以知乎或CSDN为例)
site:zhihu.com "nginx 502"- 适用场景:批量筛选长尾需求词、技术排错词、垂直行业细分词时,用来快速确认市场上到底有没有人在认真卷这个词。
- 实操判读:以
"云服务器租用"和"docker 容器无法访问宿主机端口"为例。前者用intitle:一搜,满屏都是各大云厂商官网首页和大型IDC代理站,这种词个人站或小团队碰都不用碰;后者如果发现intitle:结果只有寥寥几页,且大多是零散的报错日志粘贴,没有结构化的排错方案,这就是极佳的切入点。 - 避坑点:千万不要只看
intitle:结果数少就盲目乐观。有些词没人做标题优化,是因为根本没有商业或流量价值,或者属于“品牌词/官网词”(比如搜某个特定软件名,虽然没人专门写文章做它的intitle,但官网首页和百科就能死死锁住前三名,你依然打不过)。
2. 拆解前十名结果中的“薄弱信号”
搜索引擎的算法逻辑很简单:当找不到完全匹配且高质量的网页时,它只能退而求其次,把大平台的问答帖、或者标题擦边的老文章推到前面凑数。我们要找的,就是这些用来凑数的“软柿子”。
在人工浏览前十名结果时,重点记录以下四类高价值信号:
- UGC内容与社区帖扎堆:如果前五名里出现了贴吧、知乎、Reddit、Quora、个人博客园随笔,且回答只有三言两语、排版混乱。这说明搜索引擎在这个词上“没得选”,只要你写一篇结构清晰、配图完整、解决痛点的独立专题页,很容易把这些零散帖子挤下去。
- 页面层级全是深层内页而非首页:如果前排大多是
domain.com/blog/2021/10/article-123这种深层文章页,说明对手也是靠单篇内容在承接流量;反之,如果前十名里有一半以上是domain.com这种独立域名首页,说明有一群站长专门建了垂直站来死磕这个词,竞争非常惨烈。 - 标题与搜索词“半匹配”或“跑偏”:比如你搜
"mac 局域网共享 windows 文件夹权限设置",前排结果标题却是"mac 如何连接 windows 电脑"或"win10 共享设置教程",并没有针对“权限设置”展开。这种意图错位就是你的机会。 - 内容年代久远且失效:技术类、软件工具类、政策流程类关键词特别常见这种情况。前排文章还在讲早已淘汰的旧版本界面或已失效的命令行参数,你只要基于最新环境实操重做一遍,用户的停留时间和点击率会帮你快速完成替代。
3. 浏览器控制台一键提取前十名特征脚本
每次查几十个词,靠肉眼一个个点开看域名、看层级、比对标题非常耗费精力。我自己在做前期词库清洗时,习惯直接在搜索结果页按 F12 打开浏览器控制台(Console),运行一段轻量级的JS脚本,瞬间把当前页面的核心竞争特征做成表格拉出来。
可直接粘贴运行的浏览器控制台脚本:
// 使用方法:在搜索引擎结果页按 F12 -> 切到 Console -> 粘贴回车 -> 输入关键词
(() => {
  const kw = prompt("输入你要检测的核心关键词:", "").trim().toLowerCase();
  if (!kw) return;

  // 适配主流搜索结果的标题节点(若页面改版失效,右键审查标题元素替换选择器即可)
  const nodes = document.querySelectorAll('h3, .t a, h2 a');
  const ugcHosts = [
    'zhihu.com', 'csdn.net', 'jianshu.com', 'tieba.baidu.com',
    'cnblogs.com', 'reddit.com', 'quora.com', 'stackoverflow.com', 'bilibili.com'
  ];
  const results = [];
  const seenUrls = new Set();

  nodes.forEach((el) => {
    const link = el.closest('a') || el;
    // 兼容百度跳转链接:优先读取父容器上的真实落地页属性 mu
    const container = el.closest('[mu]');
    const rawHref = (container && container.getAttribute('mu')) || link.href || '';
    const title = el.innerText.trim();

    if (!rawHref.startsWith('http') || !title || seenUrls.has(rawHref)) return;
    seenUrls.add(rawHref);

    try {
      const urlObj = new URL(rawHref);
      const isHome = urlObj.pathname === '/' || urlObj.pathname === '';
      const isUGC = ugcHosts.some(host => urlObj.hostname.includes(host));
      const isExactTitle = title.toLowerCase().includes(kw);

      results.push({
        '标题截取': title.slice(0, 28) + (title.length > 28 ? '...' : ''),
        '目标域名': urlObj.hostname,
        '页面类型': isHome ? '主域名首页(硬骨头)' : '内页',
        '标题完整包含': isExactTitle ? '是' : '否(有优化空间)',
        '社区UGC': isUGC ? '是(突破口)' : '否'
      });
    } catch (e) {}
  });

  console.table(results.slice(0, 12));
})();- 适用场景:针对筛选出来的候选关键词,在发布内容或立项建站前进行批量人工复核。
- 避坑点:搜索引擎前端DOM结构经常微调,且不同引擎(如百度与Google)对广告位、百家号/聚合卡片的包装不同,脚本里顺带把
mu属性兼容进去了,避免百度跳转链接www.baidu.com/link?url=...干扰域名判断。但具体有没有“真干货”,还是得自己点开排名前三的文章扫一眼正文长度和实操深度,别完全偷懒。
4. 用表格公式量化评估,替代黑盒KD分
如果是团队协作,或者你需要向老板/客户汇报为什么选A词而不选B词,光靠嘴说“我觉得这个词好做”没有说服力。建议直接在Excel或飞书表格里建一套透明的评估公式,把刚才排查出来的客观事实填进去,自动算出可执行的难度结论。
表头设计与可直接复制的公式:
假设你在表格中设置以下列(从第2行开始填数据):
A2:目标关键词B2:前10名中“主域名首页”数量(填入 0-10 的整数)C2:前10名中“社区UGC/论坛”数量(填入 0-10 的整数)D2:前10名中“标题未完整匹配”数量(填入 0-10 的整数)E2:首屏商业广告及官方聚合卡片霸屏等级(填入0=无干扰,1=少量干扰,2=首屏全被占满)
在 F2 单元格填入综合难度评估公式:
=IF(E2=2, "直接放弃(流量被截留)", IF((B2*2 - C2*1.5 - D2*1 + E2*3) <= 2, "低难度-优先抢占", IF((B2*2 - C2*1.5 - D2*1 + E2*3) <= 7, "中难度-需做深度内容", "高难度-新站慎入")))- 逻辑解释:主域名首页越多,权重壁垒越高,做加法加重难度;UGC论坛和未优化标题越多,说明内容缺口越大,做减法降低难度;首屏如果直接被广告或官方产品卡片占满,无论后面自然排名的网站有多弱,用户根本滑不到你这里,直接一票否决。
- 避坑点:这套公式最容易忽略的是“品牌归属”。如果某个词前10名全是内页,算出来是“低难度”,但点进去一看全都是同一个巨头官网的子页面(比如搜某软件的特定功能参数,前十全是官方帮助文档),这种情况不要套公式,直接认清现实:你写得再好也很难比官方手册更让用户信任。
高频关联问题拓展
1. 前十名全是知乎、CSDN或Reddit,到底算好做还是难做?
这是新手最容易迷糊的地方,答案取决于用户的真实搜索意图。
- 好做的情况(功能/教程/方案类):用户搜
"python 批量合并多个excel表格代码",结果前面全是不完整的论坛提问帖,或者需要付费积分下载的零散代码块。这时候你做一个干净、无需登录就能直接复制代码并附带报错说明的独立页面,体验完胜论坛,非常容易突围。 - 难做的情况(主观评价/避坑/口碑类):用户搜
"某某型号路由器怎么样 真实体验"、"某家培训机构靠谱吗"。这类词用户天生就不信任单个企业站或独立博客的自卖自夸,他们就是想看一群真实网友在社区里吵架和吐槽。搜索引擎非常清楚这种意图,会把高权重社区死死按在前面,你单独建站写测评很难排上去。
2. 新站/低权重域名,和老站在判断难度时标准一样吗?
完全不一样,不能混为一谈。老站有基础收录速度和历史信任度,哪怕遇到中难度词,靠高质量长文和内链权重传递也能搏一搏。但如果你手里是一个刚上线不久的新站,或者发在刚注册不久的专栏账号上,哪怕按照上面方法判断出是“中低难度”,只要前十名清一色是行业老牌垂直站的内页,新站依然要经历漫长的考核期。 新站实操策略:只挑那些前十名里连一个完整覆盖该需求的长文都没有的词(哪怕它搜索量看起来很低),用极致细分的实操内容先把第一波精准点击拿到手,等站点积累起基础的搜索信任度,再去碰中难度词。
3. 遇到搜索引擎顶部直接给出AI摘要或计算器答案怎么办?
现在很多搜索结果顶部直接弹出了AI摘要框、汇率换算器、天气面板或者代码片段框。面对这类关键词,判断标准不能只看“能不能排到自然结果第一”,而要看“用户看完顶部答案后还会不会往下点”。
- 如果是
"json格式化"、"时间戳转换"这种工具需求,或者"linux 查看端口占用命令"这种一句话就能解决的简单指令,用户在顶部框看一眼或者直接用掉就关掉页面了,即便你拿到了自然排名第一,点击率也会非常惨淡。 - 相反,如果问题涉及多步骤排查、复杂选型对比、或者需要下载完整工程模板(AI给的几句话根本解决不了实际报错),用户依然会往下点击深度文章。排查时务必亲自模拟一遍真实用户:如果连你自己搜完都懒得往下滑,这个词的难度哪怕为零,也没有做的必要。
总结
到底该如何准确判断关键词竞争难度,核心永远不在于软件给你打了几分,而在于你是否真的站在搜索引擎结果页前,看清了对手的成色与用户的真实退路。把 intitle: 指令、前十名薄弱特征排查以及量化筛选表结合起来用,先过滤掉被广告、官方卡片和真实口碑社区垄断的伪机会词,再集中火力去打那些“内容老旧、意图跑偏、全靠论坛凑数”的缺口词,才能把每一份内容制作和服务器运维的成本都花在刀刃上。