
长尾关键词批量挖掘方法:脚本抓取与词根组合实操方案
搞定长尾关键词批量挖掘方法最省事且靠谱的路子,就是“核心词根笛卡尔积组合 + 搜索下拉框接口自动化抓取 + 脚本去重清洗”,直接绕开那些动辄按条收费、数据陈旧的第三方鸡肋工具。市面上很多所谓的“百万词库包”,里面塞满了过时的垃圾词和无效字符,买回来照样得花大把时间清洗,不如自己花半小时搭一套自动化脚本,针对性挖出来的词不仅精准,而且全是当下用户真实在搜的需求。
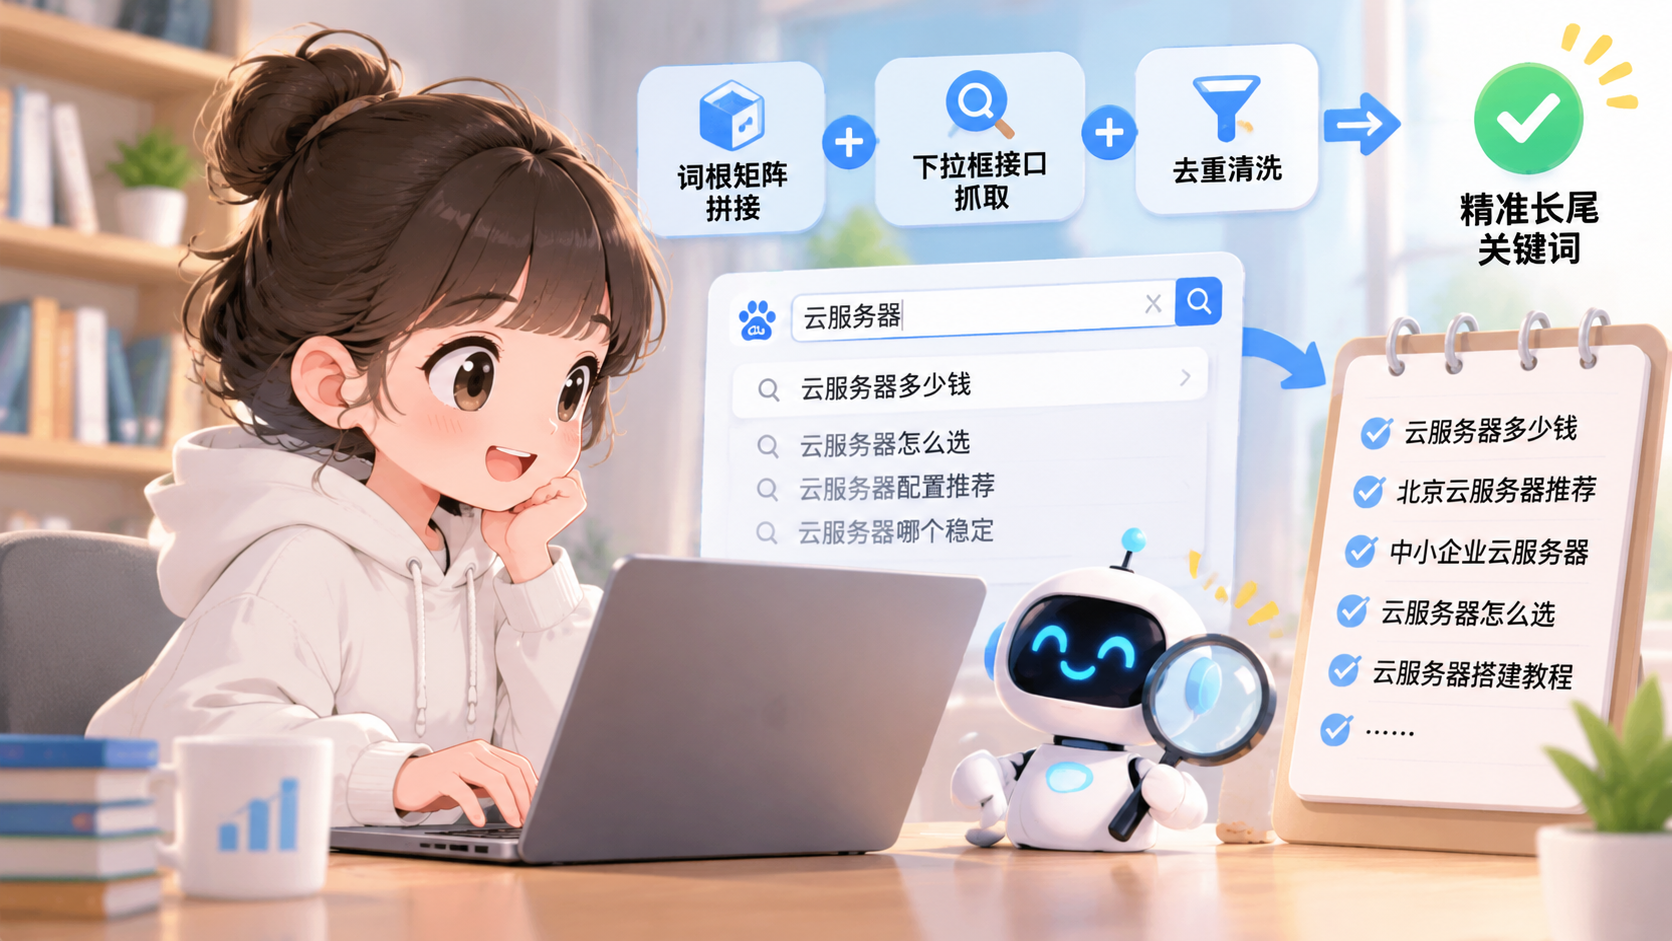
下面直接上干货,这套方案不管是做网站内容矩阵、电商选品铺词,还是做自媒体选题库,都能直接套用落地。
核心方案速览
在实际干活时,不要死磕某一种渠道,根据自己的业务阶段选对路子效率最高:
- 词根矩阵拼接法:适合产品线明确、业务属性固定的场景(比如本地服务、B2B设备、SaaS功能模块),用脚本把“地区/人群 + 核心词 + 痛点/疑问后缀”批量排列组合,快速构建基础词盘。
- 搜索下拉框接口抓取法:利用百度、必应、小红书或淘宝等平台的搜索建议(Suggest)接口,模拟用户输入“核心词 + a~z / 常见疑问词”,批量扒取平台实时吐出的真实用户长尾需求。
- 竞品站点与问答社区逆向法:直接扒取同行网站的
sitemap.xml标题,或者抓行业论坛、知乎、电商评论区的高频痛点句式,提取出标准工具根本测不到的长尾长句。 - 大模型(LLM)语义清洗与聚类:用脚本调用大模型 API,批处理剔除无效品牌词、色情赌博或破解类废词,并按搜索意图自动分组,解决人工在 Excel 里看瞎眼的痛点。
实操细节深度拆解
1. 词根矩阵拼接:用 Python 替代 Excel 拖拽
很多人还在 Excel 里用 & 符号手动拼接关键词,几百个词就卡得不行。直接用 Python 的 itertools.product 做笛卡尔积,一秒钟就能生成结构规整的词根组合。
适用场景:冷启动期快速搭建业务核心词库,或者做多地区、多型号覆盖。
import itertools

# 1. 定义业务维度的词根(根据实际业务替换)
prefixes = ["", "中小企业", "北京", "上海", "个人"]
cores = ["云服务器", "对象存储", "轻量应用服务器"]
suffixes = ["多少钱", "怎么选", "配置推荐", "哪个稳定", "续费贵吗", "搭建教程"]

# 2. 笛卡尔积组合并去除多余空格
raw_keywords = []
for p, c, s in itertools.product(prefixes, cores, suffixes):
    # 拼接并清理首尾空格
    kw = f"{p}{c}{s}".strip()
    raw_keywords.append(kw)

# 3. 写入本地文本文件
with open("base_keywords.txt", "w", encoding="utf-8") as f:
    for kw in set(raw_keywords):
        f.write(kw + "\n")

print(f"生成完毕,共输出 {len(set(raw_keywords))} 个组合词")避坑点:不要无脑堆砌四五个维度去做全排列!比如把“时间+地区+人群+型号+疑问”全乘起来,很容易产出“2026北京个人中小企业轻量服务器多少钱哪家好”这种人类根本不会搜的鬼畜长句。每次拼接控制在2到3个核心维度以内,宁缺毋滥。
2. 下拉框接口深度递归抓取
拼出来的词很多是拍脑袋想的,到底有没有人搜,得去搜索平台的下拉框里验证和拓展。平台下拉框吐出来的词,代表近期有真实搜索行为支撑。手动一个字一个字敲太慢,我们直接抓接口,并且用“核心词 + 空格 + 字母a-z / 常用疑问词”的方式进行深度裂变。
适用场景:需要大量真实、鲜活、贴近用户口语表达的长尾词。
下面给出一个可直接运行的百度 PC 端下拉框抓取脚本(使用其公开的 JSON 接口,比早期解析 HTML 或 JSONP 稳定得多):
import requests
import time
import random
import string

def get_baidu_suggestions(query):
    url = "https://www.baidu.com/sugrec"
    params = {
        "pre": "1",
        "p": "3",
        "ie": "utf-8",
        "json": "1",
        "prod": "pc",
        "wd": query
    }
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }
    try:
        resp = requests.get(url, params=params, headers=headers, timeout=5)
        data = resp.json()
        # 提取下拉词列表
        if "g" in data:
            return [item["q"] for item in data["g"]]
    except Exception as e:
        print(f"抓取 [{query}] 失败: {e}")
    return []

# 准备种子词和拓展后缀
seed_words = ["Docker部署", "内网穿透"]
# 利用 a-z 字母和中文常见痛点词做前缀/后缀扩展
expanders = list(string.ascii_lowercase) + ["怎么", "为什么", "报错", "推荐", "教程", "免费", "替代"]

results = set()

for seed in seed_words:
    # 先抓一遍原词本身
    for w in get_baidu_suggestions(seed):
        results.add(w)

    # 再抓核心词 + 拓展词根
    for exp in expanders:
        query_str = f"{seed} {exp}"
        suggestions = get_baidu_suggestions(query_str)
        for s in suggestions:
            results.add(s)
        # 必须加随机休眠,防封IP
        time.sleep(random.uniform(0.6, 1.5))

with open("suggest_keywords.txt", "w", encoding="utf-8") as f:
    for kw in sorted(results):
        f.write(kw + "\n")

print(f"抓取完成,共获取去重后长尾词 {len(results)} 个")实操细节与避坑点:
- 别把并发开太高:很多人一上来就开几十个线程狂扫接口,跑不到两分钟 IP 就被拉进黑名单或者弹验证码了。单线程加
0.6-1.5秒随机延时,挂在后台或者小鸡(VPS)上慢慢跑是最稳的;真要跑上万个种子词,记得接代理 IP 池。 - 跨平台换接口:做小红书、抖音或者电商运营的,不要只抓搜索引擎。用浏览器按
F12打开 Network 面板,在目标平台搜索框敲几个字,过滤XHR/Fetch请求,就能直接把它的 Suggest 接口地址和请求头扒出来,把上面代码里的url和 JSON 解析字段改一下就能直接用。
3. 竞品站点 Sitemap 逆向提取
如果你在冷门 B2B 行业,搜索下拉框根本没几个词,最直接的办法是去抄已经跑出流量的同行。同行花精力做出来的专题页、聚合页标题,本身就是经过筛选的高价值长尾词库。
适用场景:行业冷门、下拉框数据稀疏,或想快速摸清竞争对手的内容布局底细。
# 第一步:用 curl 把对方网站的 sitemap 索引抓下来看看(假设没有屏蔽常见 UA)
curl -s -A "Mozilla/5.0" https://example.com/sitemap.xml | grep -oE "<loc>[^<]+</loc>" | sed 's/<[^>]*>//g' > urls.txt
拿到 urls.txt 后,如果对方 URL 路径是语义化的(例如 /blog/how-to-fix-nginx-502),直接把横杠替换成空格就是现成的英文长尾词;如果是中文站且 URL 是数字 ID(如 /article/1024.html),就写个简单的 Python 脚本批量请求这些 URL,用正则或 BeautifulSoup 提取 <title> 和 <h1> 标签,再把标题里的品牌后缀(比如 - XX科技官网)批量替换删掉,一份现成的同行长尾词表就到手了。
避坑点:抓同行站之前先看一眼对方的 robots.txt 和访问频率限制,别把人家小站给爬挂了,容易吃律师函或者被对方反向屏蔽;另外只提炼词根和需求结构,千万别直接照搬对方的页面内容。
4. 利用大模型(LLM)批处理清洗与意图归类
抓回来几万条词,里面肯定混着大量垃圾,比如你卖企业级付费软件,词库里肯定混着“某某软件破解版”、“某某软件免费下载网盘”。靠写死正则去过滤永远漏网之鱼太多,这时候接一个高性价比的大模型 API(或者本地跑个轻量级开源模型),让它按批次帮你做废词剔除和意图打标。
可直接套用的批处理 Prompt 模板:
你是一个资深数据分析与内容运营专家。请处理以下待筛选的关键词列表(每行一个)。
任务要求:
1. 剔除所有包含“破解、免费版、盗版、网盘下载、招聘、官网电话”等无商业转化价值或违规意图的词汇。
2. 对保留下来的关键词,按搜索意图打上标签:【教程实操】、【故障排查】、【产品对比】、【价格采购】。
3. 严格按照 JSON 数组格式输出,不要包含任何多余的解释性废话。格式:[{"keyword": "词", "intent": "标签"}]

待处理列表:
{每次传入30~50个词}避坑点:单次丢给模型的词不要超过 50 个!一次性塞 500 个词进去,大模型必然出现“偷懒”截断、漏词或者 JSON 格式输出错乱的情况。用 Python 的切片循环每次喂 30 条,配合 try-except 校验 JSON 格式,稳得一塌糊涂。
高频关联问题拓展
1. 挖出一大堆长尾词,怎么快速判断到底有没有人搜、值不值得做?
千万别迷信第三方工具给出的“精确搜索指数”! 那些所谓日均搜索量 10、50 的数字,很多都是平台靠模型估算甚至瞎编的。在实际落地中,判断一个长尾词有没有价值,看三个硬指标就够了:
- 看下拉框和相关搜索:能出现在下拉框前几位的,说明近期肯定有真实活人搜过;完全没在任何平台下拉框出现过、纯靠词根硬拼出来的词,优先度往后排。
- 看搜索结果页(SERP)的竞争度:把词丢进搜索引擎,看看排在前面的是不是都是大站的主页或精准专题页。如果前排混杂着知乎水贴、贴吧老帖、或者 PDF 文库页面,说明这个词根本没人正经写内容优化,属于典型的蓝海捡漏词,闭眼直接做。
- 看商业广告数量:搜一下这个词,如果页面顶部挂着好几条竞价广告,说明这个词能直接变现,哪怕搜索频次低,只要转化客单价高,照样值得死磕。
2. 词库里大量同义词和语序颠倒词怎么合并?(防内容内耗)
比如“云服务器怎么重装系统”和“重装云服务器系统的方法”,如果当成两个独立词去写两篇文章,最后会导致自己站内的两个页面互相抢流量,谁也跑不起来。
在工程上,做长尾关键词批量挖掘方法的最后一步,必须用脚本做分词聚合去重。安装 jieba 分词库,把词拆碎并排序重组,或者直接计算两个词的集合交集率(Jaccard 相似度):
import jieba

def normalize_kw(kw):
    # 分词后剔除无意义停用词,按字母/拼音顺序重新排列
    stop_words = {"怎么", "如何", "的", "方法", "教程", "什么", "是"}
    words = [w for w in jieba.cut(kw) if w not in stop_words and w.strip()]
    return "".join(sorted(words))

kw1 = "云服务器怎么重装系统"
kw2 = "重装云服务器系统的方法"

print(normalize_kw(kw1))  # 输出:系统云服务器重装
print(normalize_kw(kw2))  # 输出:系统云服务器重装
跑一遍这个逻辑,所有语序颠倒、虚词不同的长尾词就会算出完全一样的指纹 Key。你在表格里直接按这个指纹 Key 分组去重,留一个读起来最顺口的作为主词,剩下的全归为它的辅助同义词,塞进同一篇内容的 H2/H3 小标题里消化掉。
3. 下拉框完全抓不到词的极冷门垂直行业怎么办?
做工业阀门、特种化工原料、或者极其垂直的 B2B SaaS 系统的朋友经常会遇到这个问题:核心词丢进百度或谷歌下拉框,干干净净一条建议都没有。
这时候别死磕搜索接口了,直接换源头:
- 去内部找:找客服、售后、销售要近半年的微信聊天记录、工单系统导出表格和电话录音转文字稿。客户在电话里问的每一句大白话(比如“你们这个泵在零下二十度会不会冻裂”),都是现成的、极高转化的长尾关键词。
- 去垂直社区找:去行业贴吧、专业论坛、甚至淘宝/1688 竞品商品的“问大家”和“中差评”里爬数据。买家吐槽什么、担心什么,把这些痛点句式提取出来,稍微润色成标准问句,就是你的专属长尾词库。
结尾总结
把长尾关键词批量挖掘方法跑顺了,本质上就是建立一套可复用的数据流:业务词根定方向 -> 自动化接口扩词量 -> 竞品与客服录音补盲区 -> 脚本分词去重加模型洗数据。
最后唠叨一句踩坑经验:千万不要陷入“囤词综合征”。很多人脚本跑得飞起,硬盘里存了几个 G 的 Excel 词表,结果一条内容都没落地,过半年再看,业务变了、产品迭代了,那堆词全成了电子垃圾。小步快跑,一次只针对一个核心产品或业务线挖出几百个高纯度长尾词,立刻匹配内容或着陆页发出去验证反馈,这才是技术工具赋能业务的正经用法。