
AI营销会替代人工运营吗?别被焦虑割韭菜,看一线人机协同方案
AI营销会替代人工运营吗?直接把结论拍在这里:不会完全替代,但一定会清退掉只会机械搬运、套模板凑字数、按部就班发帖的初级执行岗。
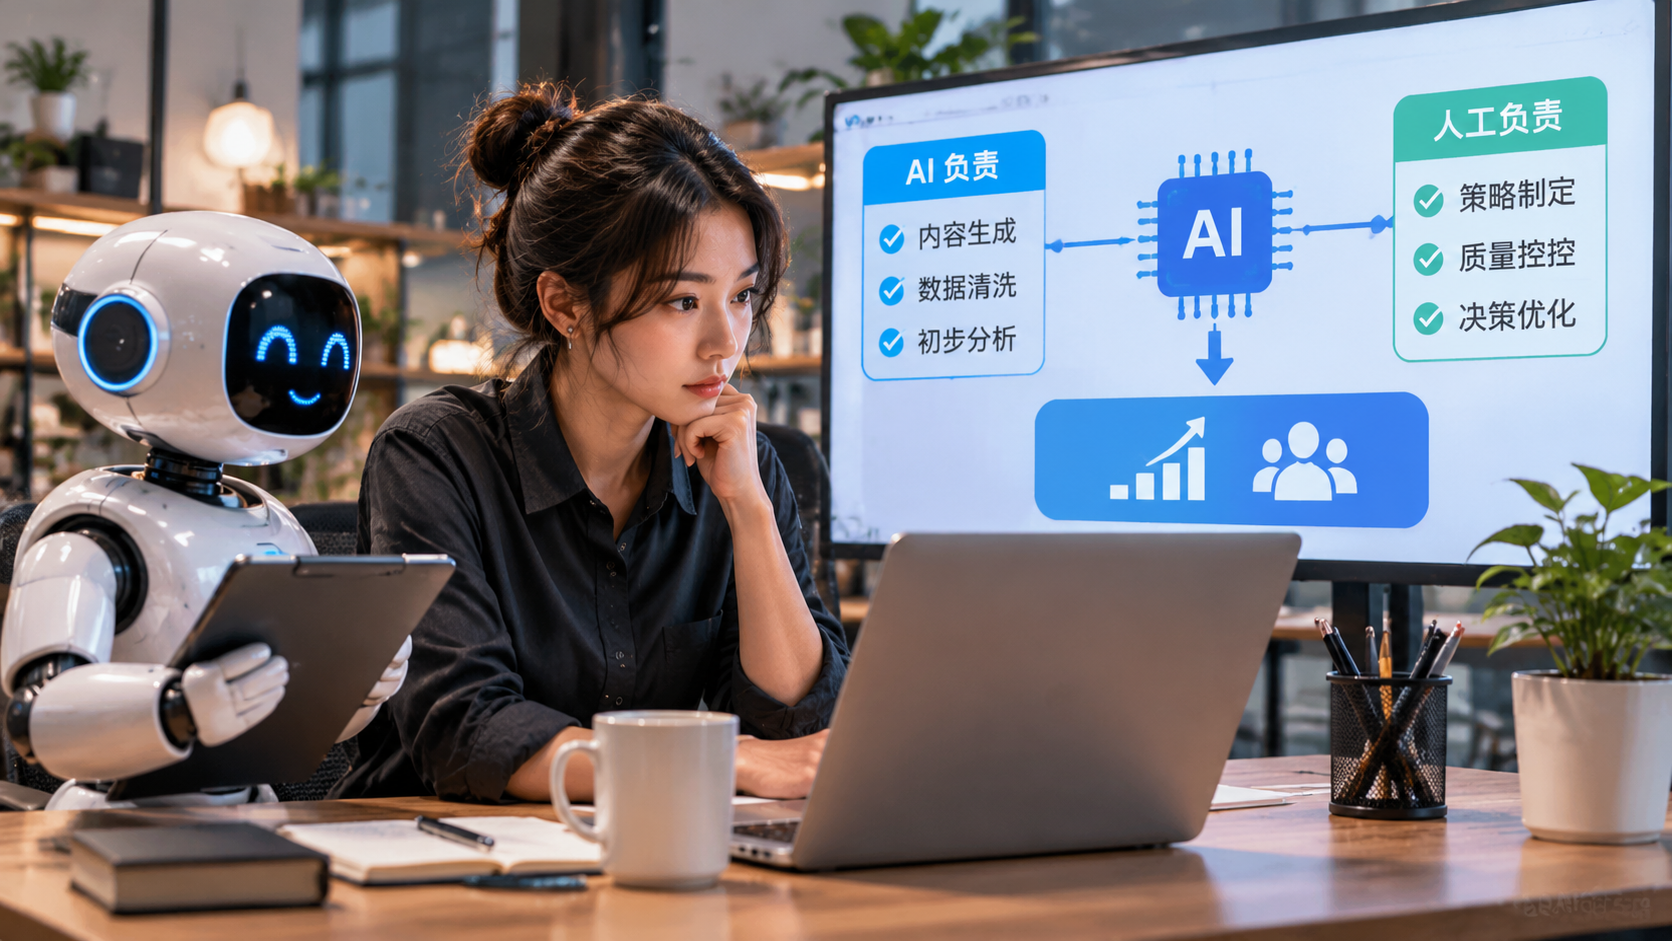
市面上那些天天吹“一套AI系统顶十个运营团队”、“全自动无人值守爆单”的,基本都是卖课或者卖套壳SaaS的在制造焦虑。在一线真正跑过业务的人都清楚,AI目前能接管的只是“确定性高、容错率高、重复劳动密集”的环节;一旦涉及到真实的用户情绪博弈、产品卖点重构、合规红线把控以及投放预算的动态止损,把方向盘全交给模型就是找死。
与其在网上争论会不会失业,不如直接把工作流拆开重装,把AI当成不知疲倦的初级执行外包,自己退到“策略制定+系统搭建+质量卡点”的位置上。
核心方案速览:人机分工的落地架构
想让AI在营销链路里真正产生正向产出,而不是制造一堆“一眼假”的电子垃圾,必须先把权责边界划死。一套能跑通的实战分工方案如下:
- AI负责(高并发、粗加工、结构化清洗):
- 基于真实业务语料生成多版本Hook(开头钩子)和渠道适配文案。
- 批量清洗评论区、客服聊天记录,提取高频痛点与情绪倾向。
- 对已有长内容进行格式重构(如把长评测拆成短图文大纲、邮件标题变体)。
- 人工负责(定调子、做判断、兜底线):
- 梳理真实的用户画像和转化路径,决定“对谁说、在哪说、推什么利益点”。
- 审核事实准确性、价格权益、广告法违禁词及品牌调性,把控发布前最后一道门。
- 结合后台真实转化数据做归因分析,决定砍掉哪条线、加注哪个方向。
- 协同落地三步走:
- 第一步:沉淀私有业务语料库,告别“一句空话让AI瞎编”。
- 第二步:用Prompt模板+轻量脚本/无代码工具把重复动作批处理化。
- 第三步:建立硬性的机器规则校验与人工抽检卡点。
实操细节深度拆解:可直接抄作业的落地步骤
1. 去“AI味”的内容批产:Prompt别再写得像小学生
很多运营试过用AI写推广文案,结果吐出来全是“在这个快节奏的时代”、“总而言之”、“让我们一起开启新篇章”。这种废话连篇的文案发出去,用户划走不说,平台算法也很容易识别为低质同质化内容。
核心解决思路:不要让AI凭空创作,而是“喂真实素材 + 给明确框架 + 加硬性负面清单”。
适用场景:同一款产品或活动,需要快速产出不同切入点的社媒图文初稿或信息流广告测试文案。
可直接套用的Prompt模板:
# 角色设定
你是一名有多年实战经验的增长文案编辑,说话直接、接地气,擅长用具体场景痛点打动人,反感假大空的形容词。

# 输入素材(务必严格基于以下事实,严禁自行编造参数和案例)
- 目标人群:近期有设备运维压力、经常半夜处理告警的中小企业IT负责人
- 核心痛点:传统监控报警延迟、误报多、半夜被叫醒但定位不到具体故障进程
- 产品动作:接入轻量探针,支持微信/钉钉秒级推送精准的进程堆栈信息
- 转化钩子:支持免费部署测试版,不限基础节点

# 输出要求
请分别从以下3个角度,各写1条朋友圈/社群短推广文案(单条字数控制在150字以内):
1. 痛点共情型:直接还原一个半夜被误报吵醒的崩溃场景。
2. 对比反差型:对比“装之前翻日志查半天”和“装之后直接看堆栈”的差异。
3. 利益直给型:不废话,直接讲清楚谁适合用、现在能白嫖什么。

# 硬性禁忌(出现以下任意一点直接重写)
- 严禁出现“在这个……的时代”、“赋能”、“助力”、“闭环”、“颠覆”、“总而言之”、“不仅如此”等AI高频套话。
- 严禁使用感叹号堆砌,每条文案最多允许出现1个感叹号。
- 严禁编造任何未在输入素材中提及的性能指标或客户名称。避坑指南:
- 绝对不要用大模型做“零上下文创作”。最稳妥的素材来源,是你家销冠跟客户的聊天记录、工单系统的真实报错描述、或者竞品评论区里的差评截图转文字。把这些原话塞进输入素材里,AI吐出来的文案才会长出“人肉感”。
- 参数微调习惯:写发散型标题钩子时,可以把接口的
temperature调到0.7左右;如果是严格按产品说明书改写文案,直接压到0.2或0.3,防止模型顺嘴胡说八道。
2. 用户反馈与评论区批处理:用Python脚本替代人工肉眼翻
运营每天要面对大量渠道评论、问卷简答题或客服导出表,人工一条条看太耗精力,不看又不知道用户到底在骂什么、想要什么。这里千万不要直接把几百行Excel截图扔进网页对话框——不仅容易漏行,还经常出现模型“偷懒”只总结前二十条的情况。
核心解决思路:用Python读CSV,调用兼容OpenAI协议的大模型API逐条打标,强制输出JSON格式,最后写回表格让运营直接筛选透视。
适用场景:活动复盘、竞品评论扒取分析、信息流广告搜索词/表单留言清洗。
可直接运行的Python参考代码:
import csv
import json
import time
from openai import OpenAI

# 初始化客户端(以兼容OpenAI格式的国内/本地或官方API为例)
client = OpenAI(
    api_key="你的API_KEY",
    base_url="https://api.deepseek.com/v1"  # 可替换为实际使用的接口地址
)

SYSTEM_PROMPT = """
你是一个严谨的运营数据分析助手。请阅读用户的评论或反馈,提取核心信息,并严格按照以下JSON格式返回,不要输出任何Markdown代码块标记以外的多余文字:
{
  "sentiment": "正面/负面/中性",
  "intent": "询价/功能咨询/吐槽Bug/售后投诉/无意义水贴",
  "core_pain_point": "用10个字以内概括具体诉求或槽点,无则填无"
}
"""

def analyze_comment(text: str) -> dict:
    try:
        response = client.chat.completions.create(
            model="deepseek-chat",
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": f"待分析内容:{text}"}
            ],
            temperature=0.1,  # 分类任务务必把随机性压到最低
            response_format={"type": "json_object"}
        )
        return json.loads(response.choices[0].message.content)
    except Exception as e:
        print(f"单条处理异常: {e}")
        return {"sentiment": "异常", "intent": "异常", "core_pain_point": str(e)}

def batch_process(input_csv: str, output_csv: str):
    with open(input_csv, mode="r", encoding="utf-8-sig") as infile, \
         open(output_csv, mode="w", encoding="utf-8-sig", newline="") as outfile:

        reader = csv.DictReader(infile)
        fieldnames = reader.fieldnames + ["sentiment", "intent", "core_pain_point"]
        writer = csv.DictWriter(outfile, fieldnames=fieldnames)
        writer.writeheader()

        for idx, row in enumerate(reader, 1):
            comment = row.get("content", "").strip()
            if not comment:
                continue

            result = analyze_comment(comment)
            row["sentiment"] = result.get("sentiment", "")
            row["intent"] = result.get("intent", "")
            row["core_pain_point"] = result.get("core_pain_point", "")
            writer.writerow(row)

            print(f"已处理第 {idx} 条 -> {row['intent']}")
            time.sleep(0.3)  # 防止触发并发限流

if __name__ == "__main__":
    # 确保同目录下有 comments.csv,且包含名为 content 的列
batch_process("comments.csv", "comments_tagged.csv")避坑指南:
- 永远别让大模型直接算账和统计总数!模型擅长语义归类(比如判断这句话是不是在吐槽价格贵),但不擅长数学统计。正确做法是:脚本打完标签写回CSV后,你自己在Excel里用数据透视表或者用
pandas统计各类别的数量和占比。让模型直接输出“吐槽占比多少”,它大概率会在那里一本正经地编数字。 - 清洗脏数据前置:跑API之前,先用简单规则把纯表情、少于几个字的“已阅”、“打卡”过滤掉,别把Token费浪费在垃圾字符上。
3. 上线前的“保命卡点”:自动化初筛 + 人工终审
用AI提效最怕翻车。之前见过不少团队搞“AI自动回复评论”或者“AI自动发公众号/社媒”,结果某天模型抽风,在促销活动里给用户承诺了根本不存在的赠品,或者文案里带出了违禁极限词,直接吃平台处罚甚至客诉赔钱。
核心解决思路:机器能查的用正则/脚本先挡一遍,涉及钱、法、品牌调性的必须卡死人工确认。
可直接落地的上线前检查SOP(建议写入团队规范或集成到发布脚本):
-
违禁词本地正则硬过滤(自动化): 不要依赖大模型自己“注意广告法”,大模型记不住所有平台的动态敏感词库。用几行代码做个本地前置拦截:
import re BANNED_WORDS = ["最便宜", "第一", "全网最低", "根治", "绝对", "稳赚", "包过"] pattern = re.compile("|".join(map(re.escape, BANNED_WORDS))) def check_compliance(draft_text: str): hits = pattern.findall(draft_text) if hits: raise ValueError(f"触发违禁词拦截,请人工修改:{set(hits)}") return True - 核心利益点人工核对(人工卡点):
- 核对价格数字、优惠券门槛、活动截止日期是否被AI“润色”篡改。
- 核对跳转链接及UTM追踪参数是否完整(AI改写文案时极其喜欢顺手截断长URL或者把参数里的下划线搞丢)。
- 口吻抽检:
- 读一遍开头三句话,确认没有那种虚头巴脑的翻译腔或客服机械腔,确保像是“一个活人在跟客户说话”。
高频关联问题拓展:避坑与实战疑难
Q1:我不会写Python代码,小团队也没研发支援,这套协同怎么落地?
完全不需要自己从零敲代码。现在低代码工具和表格插件已经很成熟了:
- 轻量场景:直接用飞书多维表格、钉钉多维表或者WPS AI的表格字段功能。把用户反馈粘贴到A列,在B列配置一个“AI字段”,把上面拆解好的提示词规则填进去,下拉填充就能实现批量打标,效果跟脚本差不多。
- 多步骤串联:如果涉及“抓取RSS资讯 -> AI改写摘要 -> 推送到群里人工审核 -> 确认后发草稿箱”,可以用 Coze、Dify 或者 n8n 这类可视化工作流工具。重点在于:工作流的倒数第二步永远设为“发送到人工审批群/草稿箱”,千万别图省事直接连“公开发布”节点。
Q2:为什么用AI批量写出来的文章和短视频脚本,发出去根本没流量、没转化?
这几乎是所有盲目上AI的运营踩的第一个大坑。原因就两个:
- 输入信息熵太低:你只给了AI一个主题(比如“帮我写一篇介绍SaaS软件的文章”),AI只能从预训练语料里抽平均值,写出来的东西跟全网几万篇水文毫无区别。平台算法不缺水文,用户更不爱看正确的废话。
- 缺少“反常识”和真实细节:高转化的内容往往靠具体的数字场景、真实的踩坑细节或者犀利的观点取胜。AI天生倾向于“讨好所有人、四平八稳、既要又要”。实操解法:AI只负责帮你搭骨架、顺逻辑、扩展案例表达;核心的观点冲突、真实项目里的奇葩故障截图、具体的报价对比,必须由人手动塞进去。
Q3:靠AI跑社媒矩阵、批量养号会自动触发平台风控吗?
会的,而且现在平台的风控模型比你想象中敏感。 如果你用同一个Prompt模板批产文案,哪怕换了几个同义词,句式结构(比如“第一……第二……第三……总而言之”)高度雷同,再配合固定的发布时间间隔和同一批设备IP,非常容易被判定为机器营销号直接限流甚至封号。
- 防封避坑做法:在批产流程里人为引入“结构随机性”。不要只用一个Prompt,至少准备几套完全不同文风的模板(如纯对话体、清单体、暴躁吐槽体、故事复盘体)随机轮换;发布前人工手动改写第一句话和最后一句互动引导语,并且自己留出时间去评论区跟真人正常对线回复。
总结:AI营销会替代人工运营吗?
回到开头那个问题:AI营销会替代人工运营吗?
答案已经很明晰了:它替代不了真正懂业务、懂人性、敢为投放结果负责的“操盘手”,但它正在以极快的速度干掉“人体复读机”和“表格复制粘贴专员”。
技术工具迭代得越快,底层的商业判断力、私有数据的沉淀厚度以及对异常情况的兜底能力就越值钱。作为一线从业者,与其焦虑被替代,不如今天就挑一个你每天最烦、最重复的动作——不管是洗评论表格、拆解竞品文案还是做常规周报——用上面给的Prompt或者脚本把它跑通自动化,把省下来的精力真正花在琢磨用户需求和转化链路优化上。工具永远只是杠杆,握住手柄的人才是核心。