
AI营销数据分析怎么做:数据清洗、脚本联动与提示词模板
AI营销数据分析怎么做,核心结论就一句话:千万别把几万行原始CSV直接拖进聊天框让AI“帮我分析一下”,正确的落地流程是“脚本算账 + AI看病”——先用Python或SQL把多渠道脏数据清洗聚合为高信噪比指标表,再通过API与结构化提示词让大模型完成异常归因、用户原声聚类与策略输出。
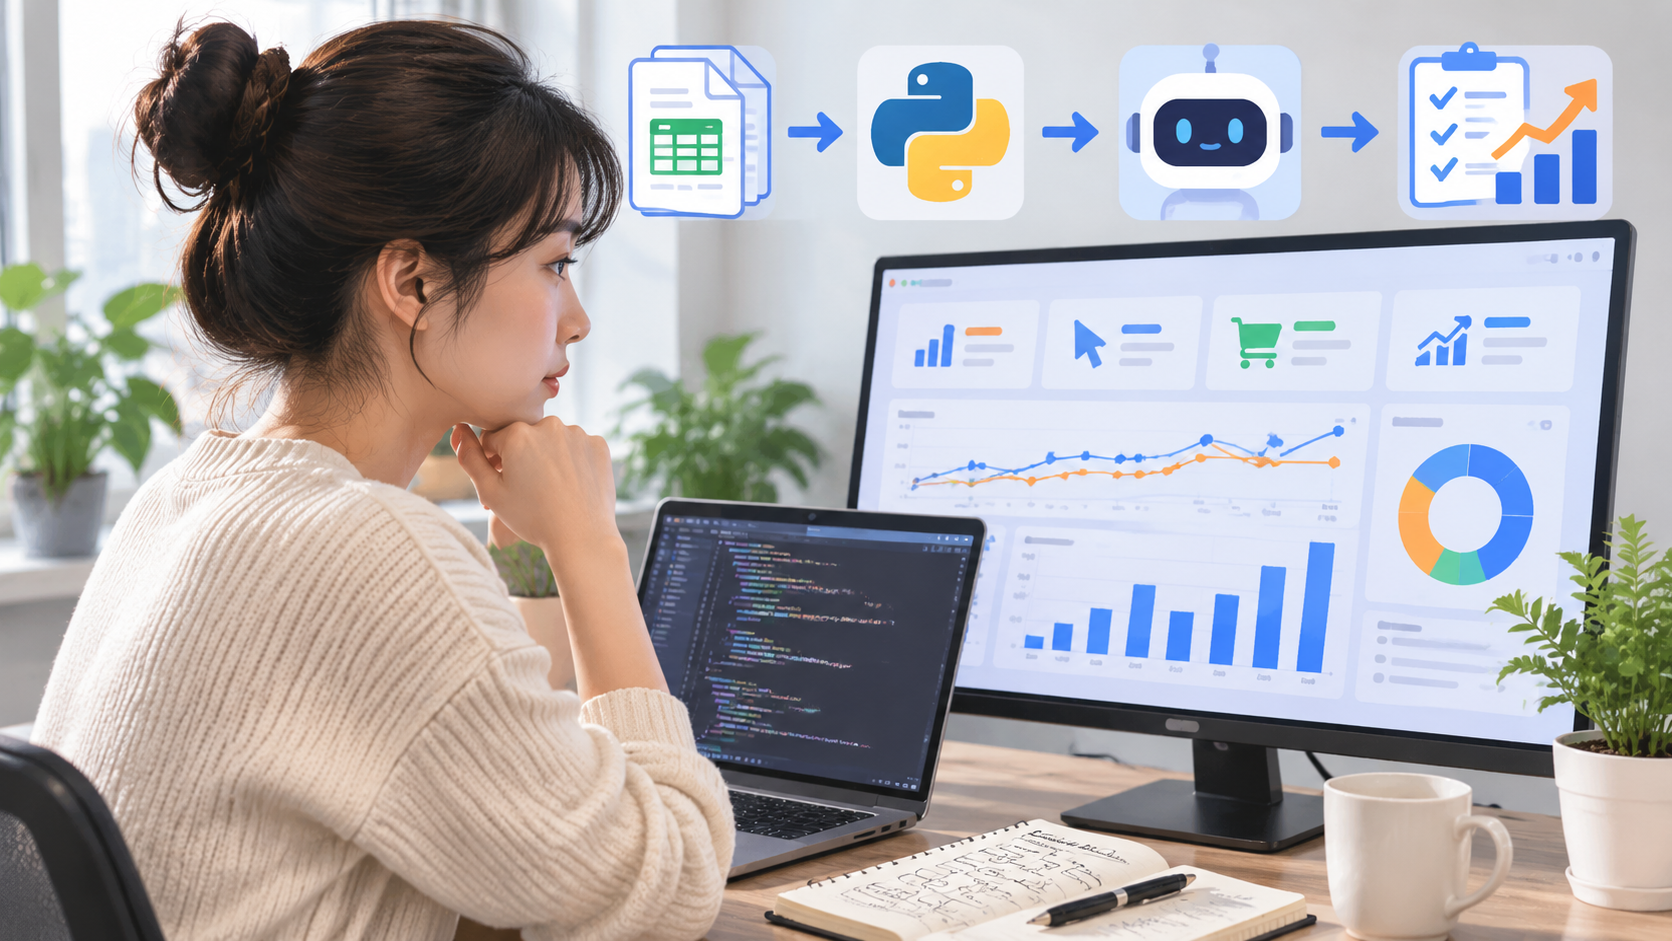
现在市面上很多所谓的“AI智能BI”都在吹一键洞察,实际用起来不是算错GMV就是满嘴“建议加强品牌精细化运营”的废话。大模型的本质是概率预测而不是计算器,让它直接做加减乘除和百万级明细透视,属于拿菜刀砍钢筋。下面直接按一线真实跑通的工作流,拆解怎么把AI真正嵌进营销数据分析里。
核心方案速览:跑通AI营销分析的四段式流水线
要把AI用出生产力,而不是当成高级玩具,整个链路必须拆成四个确定性步骤:
- 多源数据清洗与脱敏(Python/SQL):把巨量引擎、腾讯广告、抖音小店、官网GA或CRM订单表拉齐字段,剔除测试单与重复行,剔除手机号等敏感信息,统一归因口径。
- 硬指标聚合与切片(代码计算):由脚本算死曝光、点击率(CTR)、转化率(CVR)、客单价、ROI、复购率及环比变化,把几万行明细压缩成几十行的Markdown摘要表或JSON。
- API批量诊断与文本挖掘(大模型接入):把算好的聚合指标喂给模型做“维度下钻归因”;同时把客服聊天记录、商品差评、问卷反馈交给模型做批量打标与痛点提取。
- 结构化输出与自动化推送(Webhook联动):强制模型按固定JSON或Markdown模板输出异常清单与优化动作,通过定时任务推送到飞书、钉钉或企业微信群,由运营人工拍板执行。
实操细节深度拆解
一、 别让AI做数学题:用Python把脏数据洗成“标准喂料”
适用场景:每天从不同广告后台、电商后台或私域SCRM导出一堆格式不一的表格,准备做投流复盘或渠道ROI评估。
一线踩坑经验:直接传原始表格给大模型,一定会遇到三个死穴——Token直接爆掉、UTF-8/GBK编码错乱导致乱码、AI一本正经地把转化率算错。更危险的是,直接把带用户手机号、微信号的数据上传到公网大模型,极易引发合规事故。
直接套用的清洗与聚合脚本:
用Python的 pandas 把各渠道消耗与订单归因表合并,算出核心指标后再转成干净的文本摘要喂给AI。
import pandas as pd
import hashlib

# 1. 读取数据(注意国内后台导出常见GBK或带BOM的UTF-8)
ad_df = pd.read_csv("ad_cost_raw.csv", encoding="utf-8-sig")
order_df = pd.read_csv("orders_raw.csv", encoding="utf-8-sig")

# 2. 用户ID脱敏(如果后续需要分析用户维度复购)
def hash_id(val):
    return hashlib.sha256(str(val).encode("utf-8")).hexdigest()[:12]

if "phone" in order_df.columns:
    order_df["user_token"] = order_df["phone"].apply(hash_id)
    order_df.drop(columns=["phone"], inplace=True)

# 3. 过滤退款与测试订单,按渠道+计划聚合
valid_orders = order_df[order_df["status"] == "paid"]
rev_summary = valid_orders.groupby(["channel", "campaign_name"]).agg(
    orders=("order_id", "nunique"),
    gmv=("amount", "sum")
).reset_index()

ad_summary = ad_df.groupby(["channel", "campaign_name"]).agg(
    impressions=("impressions", "sum"),
    clicks=("clicks", "sum"),
    cost=("cost", "sum")
).reset_index()

# 4. 合并计算确定性指标(处理分母为0的常见报错)
merged = pd.merge(ad_summary, rev_summary, on=["channel", "campaign_name"], how="left").fillna(0)
merged["CTR(%)"] = (merged["clicks"] / merged["impressions"].replace(0, pd.NA) * 100).round(2).fillna(0)
merged["CVR(%)"] = (merged["orders"] / merged["clicks"].replace(0, pd.NA) * 100).round(2).fillna(0)
merged["ROI"] = (merged["gmv"] / merged["cost"].replace(0, pd.NA)).round(2).fillna(0)

# 5. 筛选出消耗大于0的核心计划,转为Markdown表格准备喂给AI
top_campaigns = merged[merged["cost"] > 0].sort_values(by="cost", ascending=False).head(30)
ai_input_table = top_campaigns.to_markdown(index=False)
print(ai_input_table)避坑要点:如果表格有上百个计划,不要全塞给AI。脚本里先按消耗降序取Top 30,或者按“高消耗低ROI”、“低消耗高CVR”先做一轮条件过滤,只把需要诊断的异常切片丢给模型,推理质量会高得多。
二、 高信噪比提示词与API联动:逼出真话而不是废话
适用场景:拿到清洗后的多维度指标表(包含昨天与前七天均值对比),需要快速定位“为什么昨天消耗涨了但ROI跌了”,或者给运营团队出具体调整清单。
一线踩坑经验:如果你问AI“请分析这份营销数据并给出建议”,它一定会给你写一篇八股文:“1. 优化落地页体验;2. 精准定位目标人群;3. 丰富素材创意”。这种建议等于没说。想要AI给出能落地的诊断,必须在Prompt里锁死角色、分析框架、归因边界和输出格式。
可直接套用的Prompt模板与Python调用代码(兼容OpenAI格式接口,DeepSeek、通义千问等主流模型均通用):
from openai import OpenAI

client = OpenAI(
    api_key="你的API_KEY",
    base_url="https://api.deepseek.com"  # 按实际使用的模型厂商替换
)

system_prompt = """
你是一名拥有多年实战经验的增长与投放数据专家。你的任务是基于用户提供的聚合营销数据,进行冷峻、客观的异常诊断与归因分析。

必须遵守以下规则:
1. 禁止输出“加强品牌建设”、“提升用户体验”、“进行精细化运营”等无法直接执行的空洞废话。
2. 任何结论必须直接引用输入表格中的具体渠道名、计划名和对应指标数值作为证据。
3. 严禁自行脑补未提供的数据。如果现有字段不足以判断根本原因(例如缺少落地页跳出率或素材完播率),必须明确指出“当前数据缺失XX维度,无法直接判定,建议补充检查XX”。
4. 严格按照以下Markdown结构输出:
   - 【核心异常预警】(仅列出ROI明显恶化或消耗异常放大的计划)
   - 【漏斗环节定位】(明确区分是前端曝光点击问题CTR,还是后端承接转化问题CVR)
   - 【明日可执行动作】(具体到关停哪条计划、测试什么方向、排查哪个页面)
"""

user_prompt = f"""
以下是昨日各渠道投放汇总数据(已脱敏聚合):
{ai_input_table}

补充业务背景:
- 本品保本ROI红线为 1.8。
- 近期大盘平均CTR基准为 2.5%,CVR基准为 3.0%。

请按规则输出诊断报告。
"""

response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {"role": "system", "content": system_prompt},
        {"role": "content" if False else "user", "content": user_prompt} # 标准role为user
    ],
    temperature=0.2  # 数据分析场景务必调低temperature,减少模型自由发挥和幻觉
)

print(response.choices[0].message.content)细节说明:代码里的 temperature=0.2 是实操关键。写营销文案可以把温度调高到0.8以上让它发散,但做数据分析必须压低温度,保证逻辑严谨、口径稳定。另外,user_prompt 里的“保本ROI红线”和“大盘基准线”一定要作为上下文喂进去,不然模型根本不知道多少算好、多少算差。
三、 文本矿场挖掘:AI在营销分析中真正不可替代的场景
适用场景:分析电商后台几千条差评、客服售后工单、私域企微聊天记录、问卷开放题,以及竞品爆款视频的口播文案拆解。
很多人纠结AI营销数据分析怎么做,其实老手心里都清楚:结构化数字用BI和SQL早就看透了,AI真正的降维打击在于把海量“非结构化文本”变成“可统计的结构化标签”。 以前运营要一条条翻几千条差评总结产品痛点,现在用API批量跑一遍标签分类,再交回Python做词频和占比统计,半小时就能出结论。
实操步骤与JSON强制约束示例:
- 把导出的用户评论按条读取,利用API的
response_format={"type": "json_object"}能力,强制模型把每条文本洗成固定字段。 - 提示词示例:
请对以下用户反馈进行结构化打标,严格返回JSON格式,不要包含任何多余解释。
字段要求:
- sentiment: 只能填 "正面"、"负面" 或 "中性"
- primary_issue: 若为负面或中性,从以下枚举值中选一个最匹配的:["价格太贵", "物流慢", "客服态度差", "功能与宣传不符", "操作复杂", "其他"];若为正面,填 "无"
- core_quote: 提取用户原话中最能体现痛点或爽点的一句短语(不超过15字)

用户反馈内容:"买回来发现跟主播说的一键生成完全两码事,参数要自己调半天,找客服半天回一句请看说明书,无语。"- 脚本循环跑完所有评论后,把生成的JSON列表转成
DataFrame,用df["primary_issue"].value_counts()统计出各类槽点的精确数量和占比。这样出来的结论既有定量统计的严谨性,又有定性原话的画面感,拿去跟产品部或客服部撕逼非常有说服力。
避坑要点:批量跑API时一定要加 try...except 异常捕获和 time.sleep 限流控制,并把每条处理完的结果实时写入本地CSV或SQLite。千万别跑到第3000条因为网络波动断了,前面全白跑、Token钱全打水漂。
四、 打通最后一公里:用定时任务实现无人值守日报
如果每天还要手动导出CSV、复制代码、粘贴结果,这套流程用不了两周就会被团队抛弃。轻量级落地的做法不需要买昂贵的商业软件:
- 数据源自动拉取:要么对接广告平台OpenAPI,要么利用内部数据库只读账号(Read-Only)用SQL定时取数。
- Linux Crontab 或 Windows任务计划:设定每天早上固定时间自动执行上述“清洗脚本 + AI诊断脚本”。
- 群机器人推送:拿到模型返回的Markdown诊断文本后,直接通过Python的
requests.post调用飞书或钉钉自定义机器人的Webhook地址,把预警直接推到投放组大群里。
这样每天早会前,团队群里已经躺着一份带具体异常计划编号、漏斗归因和待排查动作的简报,运营直接照单子去后台核查调整即可。
高频关联问题拓展
1. 公司严禁业务数据上传公网大模型,怎么破?
有两条路可走,看公司技术底座:
- 轻量脱敏方案(中小团队首选):只要传给AI的数据里不包含公司名、品牌名、真实商品名、用户手机号/地址,把计划名脱敏成
Plan_A、Plan_B,把金额按固定保密系数等比例缩放(例如所有消耗和GMV同乘一个只有内部知道的系数),ROI和转化率完全不变,公网大模型根本无法还原真实业务体量。 - 私有化部署方案(中大型团队):在内网GPU服务器上用
vLLM或Ollama部署开源模型(如通义千问Qwen系列开源权重),代码里把base_url改成本地内网地址,数据全程不出局域网。
2. 直接用ChatGPT的Data Analysis(代码解释器)上传CSV行不行?
临时做一次性的探索分析可以,但不适合放进日常固定工作流。实际用过就知道,国内各平台导出的表格经常存在合并单元格、表头多一行汇总行、日期格式一会儿斜杠一会儿横杠等奇葩问题。Code Interpreter经常在读取阶段就报编码或解析错误,光跟它来回对话改读表代码就够烦了。不如自己写一段死逻辑的Python脚本清洗标准表,稳定省心一万倍。
3. 怎么防止AI在归因报告里“一本正经地胡说八道”?
除了前面提到的调低 temperature 和在Prompt里禁止脑补之外,最有效的一招是建立“二次核验机制”。可以在报告生成后,加一道简单的正则校验或人工抽查红线:凡是AI输出里提到的数字,必须在原始聚合表里找得到对应项;更重要的是,永远把AI当成“初级数据分析助理”而不是“最终决策者”。AI负责把十万条信息压缩成三条重点线索,最后点下“关停计划”或“调整出价”按钮前,必须由运营去广告后台看一眼素材评论区和实时点击曲线做最终确认。
结尾总结
回过头来看AI营销数据分析怎么做这个问题,本质上根本不是去学什么花哨的提问话术,而是做好人机分工:把确定性的计算、表关联、数据脱敏全部交给Python和SQL去死磕;把模糊的归因推理、大量非结构化评论聚类、报告语言组织交给大模型去批量处理。
不要迷信任何“上传表格一键生成增长神话”的宣传,老老实实把底层数据清洗管道搭顺,配好带业务红线的结构化提示词和自动化推送脚本,这套东西才能真正在你的日常业务里稳稳跑起来,替你省下大把盯盘和扒表的时间。