
怎么优化服务器内核参数解决高并发卡顿与连接超时
搞定怎么优化服务器内核参数这件事,核心结论就一句话:别去网上随便复制粘帖所谓的“高并发万能参数模板”,直接先用 ss 和 nstat 定位当前卡在连接队列、端口耗尽还是内存回收,再按业务类型把配置拆写到 /etc/sysctl.d/99-custom.conf 中,最后用 sysctl --system 生效并同步调整应用层限制。
运维圈里最坑新人的乱象,就是拿十年前老掉牙博客里的 sysctl.conf 往现代 Linux 机器上硬套。很多参数在新版内核里早就被废弃了,盲目照搬不仅不提速,反而会导致 NAT 网络环境下用户大面积断连、或者突发流量时服务器直接触发 OOM 死机。优化内核参数的本质,是打破系统默认的“保守家用桌面配置”,让网络协议栈、文件句柄和内存调度贴合你的真实业务模型。
核心方案速览:四个必调维度与适用场景
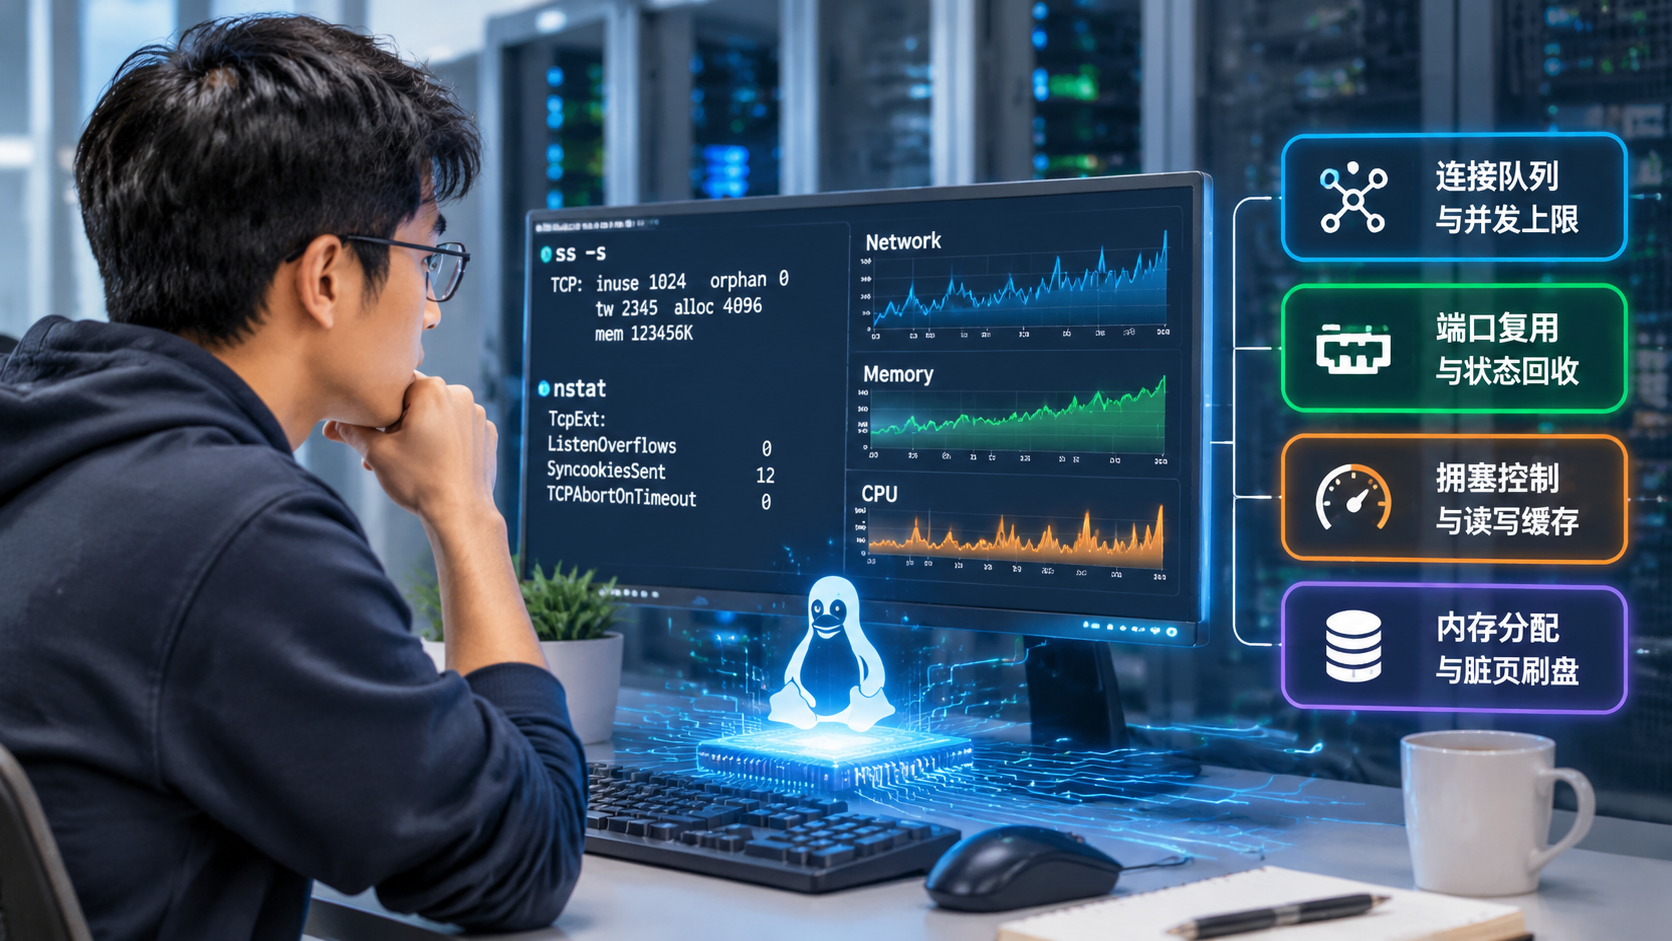
在动手改配置之前,先搞清楚服务器到底需要动哪几块。绝大多数 Web 服务、API 网关、数据库和代理节点,围绕以下四个方向做调整就够了:
- 连接队列与并发上限(Web/Nginx/网关必改):调大
somaxconn和半连接队列,防止流量波峰时直接丢弃用户握手包。 - 端口复用与状态回收(高频短连接/反代必改):放开本地可用端口范围,合理开启
tcp_tw_reuse,解决 Nginx 反向代理到后端服务时报端口耗尽的问题。 - 拥塞控制与读写缓存(大文件下载/视频/跨网传输必改):开启 BBR 算法并拉高 TCP 收发缓冲区上限,榨干带宽利用率。
- 内存分配与脏页刷盘(Redis/MySQL/宿主机必改):压低
swappiness防止频繁使用交换分区导致卡顿,调整脏页比例避免磁盘突发写入卡死整个系统。
实操细节深度拆解:可直接套用的配置与避坑指南
动手前先执行 uname -r 看一眼内核版本,同时用 sysctl -a > ~/sysctl_backup.txt 备份一份原始配置,方便翻车时对比还原。记住:不要直接把一堆参数塞进 /etc/sysctl.conf,规范的做法是在 /etc/sysctl.d/ 目录下新建独立的配置文件(比如 99-optimize.conf),数字越大优先级越高,出问题直接删文件重载就行。
1. 网络连接队列与防丢包配置(通用 Web 与 API 节点)
Linux 默认的监听队列极小,以前很多系统默认 somaxconn 只有 128,哪怕 Nginx 里配了再高的并发,内核层面照样给你把多余的请求拒之门外。
新建配置文件 /etc/sysctl.d/99-network.conf:
# 增大系统允许的最大全连接队列长度(需配合应用层 backlog 一同调大)
net.core.somaxconn = 32768

# 增大半连接(SYN)队列长度,抗轻微 SYN 洪泛并容纳突发握手
net.ipv4.tcp_max_syn_backlog = 16384

# 网卡接收数据包队列长度,万兆网卡或高并发小包场景必调
net.core.netdev_max_backlog = 16384

# 放大本地可用端口范围,默认 32768-60999 在高并发反代下极易耗尽
net.ipv4.ip_local_port_range = 10000 65535

# 允许将 TIME_WAIT 状态的连接重新用于新的出站连接(对反代/爬虫/调用第三方API有效)
net.ipv4.tcp_tw_reuse = 1

# 缩短 FIN_WAIT2 状态的超时时间,加速异常断开连接的资源回收(默认 60 秒)
net.ipv4.tcp_fin_timeout = 15

# 孤儿连接(无进程接管的 socket)最大数量与重试次数
net.ipv4.tcp_max_orphans = 65535
net.ipv4.tcp_orphan_retries = 2

# 缩短保活探测时间,更快踢掉死连接(单位:秒)
net.ipv4.tcp_keepalive_time = 600
net.ipv4.tcp_keepalive_intvl = 30
net.ipv4.tcp_keepalive_probes = 3
一线踩坑避坑点:
- 千万别加
net.ipv4.tcp_tw_recycle = 1:这是网上教程里遗毒最深的一个参数。它在较新的内核里已经被彻底移除,加了会直接报错;哪怕你在老系统上开了它,只要客户端在公司内网、手机基站这种 NAT 环境下访问你的服务器,就会因为时间戳校验失败被直接丢包,表现为“部分用户打不开网页,换个网络就好了”。 - 认清
tcp_tw_reuse的作用范围:它只针对主动发起连接的一方(比如你的 Nginx 反代连接后端 PHP/Java/Go,或者服务器主动请求外部接口)有效,并不能直接消灭服务端入站产生的TIME_WAIT。如果是入站TIME_WAIT多,只要数量没把内存吃爆或者没占满本地端口(入站连接用的是固定端口如 80/443,不消耗客户端临时端口),根本不用过度焦虑。
2. 开启 BBR 与 TCP 缓冲区调优(吞吐与跨网优化)
如果你的服务器跑着文件下载、图床、音视频分发,或者客户端与服务器之间存在跨运营商/跨境高延迟网络,默认的 Cubic 拥塞控制算法一旦遇到轻微丢包就会猛降发送速度。
追加或单独写入 /etc/sysctl.d/99-bbr.conf:
# 启用 fq 队列调度与 BBR 拥塞控制算法(需内核版本 >= 4.9)
net.core.default_qdisc = fq
net.ipv4.tcp_congestion_control = bbr

# 增大单个 socket 收发缓冲区的最大值(单位:字节,此处设为 16MB)
net.core.rmem_max = 16777216
net.core.wmem_max = 16777216

# TCP 读/写缓冲区自动调节范围:最小值 默认值 最大值
net.ipv4.tcp_rmem = 4096 87380 16777216
net.ipv4.tcp_wmem = 4096 65536 16777216

# 开启 TCP 窗口缩放(大带宽高延迟网络必须开启)
net.ipv4.tcp_window_scaling = 1

# 关闭空闲后的慢启动,避免长连接停顿一下再发数据时速度归零
net.ipv4.tcp_slow_start_after_idle = 0
一线踩坑避坑点:
- 低配小内存机器别盲目拉大
tcp_rmem上限:缓冲区最大值设到 16MB 或 32MB,前提是你的服务器内存充裕且带宽大。如果是一台 1G 或 2G 内存的小机器,遇到慢速连接攻击或大量挂起连接时,过大的内核缓冲区会迅速吃干内存触发 OOM。小内存机器把最大值压在4194304(4MB)更稳妥。 - 验证 BBR 是否真正生效,加载配置后跑一句
lsmod | grep bbr以及sysctl net.ipv4.tcp_congestion_control,确认输出里有tcp_bbr才算成功。
3. 内存调度与磁盘 IO 防卡死(数据库与重写入业务)
很多站长遇到过这种情况:服务器平时 CPU 不高,一到数据库备份或者大日志写入时,SSH 都卡住敲不动命令。这多半是脏页积压后一次性刷盘,加上系统把活跃进程内存扔进 Swap 导致的。
写入 /etc/sysctl.d/99-memory.conf:
# 尽量减少使用 Swap,保留物理内存给核心服务(不要轻易设为 0)
vm.swappiness = 1

# 后台异步刷盘阈值:脏页占可用内存比例超过 5% 时开始在后台写入磁盘
vm.dirty_background_ratio = 5

# 强制同步刷盘阈值:脏页达到 10% 时阻塞新写入进程,防止瞬间刷盘几十G导致系统假死
vm.dirty_ratio = 10

# 允许内存过量分配,专门防止 Redis 执行 bgsave/aof 重写 fork 子进程时报错失败
vm.overcommit_memory = 1

# 系统级最大文件句柄数
fs.file-max = 1048576
一线踩坑避坑点:
vm.swappiness设1还是设0? 建议设为1。在现代 Linux 内核中,0几乎等同于彻底禁止使用交换空间(哪怕快 OOM 了也不太愿意换出),容易在内存波动瞬间直接触发 OOM Killer 强杀 MySQL 或 Java 进程;设为1则代表“不到万不得已绝不用 Swap”,给系统留了一道缓冲垫。- 加载配置别用错命令:很多人习惯敲
sysctl -p,但要注意不带参数的sysctl -p只读取/etc/sysctl.conf,不会读取你写在/etc/sysctl.d/下的文件!正确的加载命令是:sysctl --system
高频关联问题拓展:改了参数为什么还是没效果?
实际运维中经常出现“配置都按教程改了,重启服务还是报错”的情况,下面这四个关联问题是排查高频区:
1. 改了 fs.file-max 和 somaxconn,为什么程序还是报 Too many open files 或丢连接?
内核参数只是画了一个系统总天花板,真正卡住你的往往是用户态限制(ulimit)和应用自身配置:
- Systemd 服务限制:现代发行版(CentOS 7+/Ubuntu 18+)的守护进程受 systemd 管控,
/etc/security/limits.conf很多时候管不住通过systemctl start启动的服务!必须去对应服务的 unit 文件里(如/etc/systemd/system/nginx.service.d/override.conf)加上:[Service] LimitNOFILE=655350改完执行
systemctl daemon-reload && systemctl restart nginx才算真正放开。 - 应用层
backlog参数:内核把somaxconn调到了 32768,但 Nginx 配置文件里listen 80;默认的 backlog 还是 511,最终生效的依然是两者中较小的值。务必在 Nginx 里显式写成listen 80 backlog=8192;,Redis 配置里同步调大tcp-backlog 8192。
2. 执行 sysctl --system 时报错 cannot stat /proc/sys/net/netfilter/nf_conntrack_max?
很多优化教程会让你顺手加上连接跟踪表上限参数:
net.netfilter.nf_conntrack_max = 1048576如果你机器上根本没开防火墙(iptables/nftables/firewalld)也没跑 Docker,内核就不会加载 nf_conntrack 模块,此时运行 sysctl 必然报错找不到文件。
- 排查与解决:先运行
lsmod | grep conntrack看看模块在不在。没开启防火墙的纯裸机直接删掉这条配置即可;如果确实需要防火墙或跑了 Docker,需要先把模块加进开机自动加载列表:echo "nf_conntrack" > /etc/modules-load.d/conntrack.conf modprobe nf_conntrack sysctl --system
3. 怎么用命令实锤是不是内核队列溢出了?
别靠猜,直接用内置工具看内核计数器。如果下面命令输出的数字一直在涨,说明全连接或半连接队列已经溢出了,必须立刻调大队列长度并排查应用响应慢的原因:
# 查看 TCP 监听队列溢出(ListenOverflows)与半连接丢包(ListenDrops)
nstat -az TcpExtListenOverflows TcpExtListenDrops

# 实时查看各个端口当前的全连接队列使用情况(Recv-Q 为当前排队数,Send-Q 为队列上限)
ss -lnt
在 ss -lnt 的输出里,如果看到某个端口的 Recv-Q 频繁接近甚至等于 Send-Q,不用怀疑,请求已经在内核门口排队排爆了。
4. Docker 容器里的服务需要改宿主机还是容器内参数?
Docker 默认共用宿主机内核,但网络命名空间(Network Namespace)是隔离的。像 vm.swappiness、fs.file-max 这种全局参数改宿主机就行;但很多 net.ipv4.* 参数(比如 somaxconn、ip_local_port_range)在容器内部依然保持默认值!需要在启动容器时通过 --sysctl 参数单独传入,或者在 docker-compose.yml 里通过 sysctls: 字段显式声明。
结尾总结
研究怎么优化服务器内核参数,最忌讳脱离监控指标盲目堆砌配置。正确的落地节奏永远是:先通过 ss -lnt、nstat 和系统日志抓出当前阻塞点,再针对性地选择网络队列、BBR 拥塞控制或内存刷盘参数写入 /etc/sysctl.d/ 独立文件中,同时打通 systemd 文件句柄限制与应用层的 backlog 配额。 每次调整完用 sysctl --system 热加载并盯一段时间的业务监控,确认没有报错和异常丢包再保留固化,这样才能既榨干硬件性能,又不埋下线上故障隐患。
相关文章
- 电脑越用越卡怎么优化?老运维教你用原生命令定位卡顿元凶
- Windows11系统怎么优化最流畅?干掉后台臃肿与卡顿的实操方案
- C盘满了怎么清理不删系统文件:靠自带工具与软链接安全腾空间
- 电脑开机慢怎么解决?排查启动项、系统服务与硬盘瓶颈的实操方法
- 系统内存占用过高怎么办:从进程定位到缓存释放的排查方案
- Windows10怎么优化提升性能?老运维总结的纯原生提速实操
- 虚拟内存怎么设置最好?Windows与Linux实操方案及避坑
- 怎么关闭Windows不必要的后台服务:按场景精简清单与避坑指南
- 系统垃圾怎么清理最干净?不装流氓软件的原生命令与脚本实操
- 电脑运行卡顿怎么排查原因?一线运维教你四步定位硬件与进程瓶颈