
Linux内核网络参数优化:手把手教你给服务器网络提速
很多运维和站长朋友在服务器上线后,往往只关注 Nginx 配置或者数据库索引,却忽略了底层操作系统的网络表现。在高并发、大流量或者跨境访问场景下,Linux内核网络参数优化是决定业务响应速度(TTFB)与系统抗压上限的关键一步。Linux 内核默认的网络参数通常诞生于很多年前,设计初衷是为了在几百兆内存的古董机器上保证基本兼容性,而不是为了跑满现在的万兆网卡或支撑数以万计的并发请求。如果不对底层参数进行调优,服务器往往会在极低负载下就出现大量丢包、TCP 连接超时甚至端口耗尽的问题。
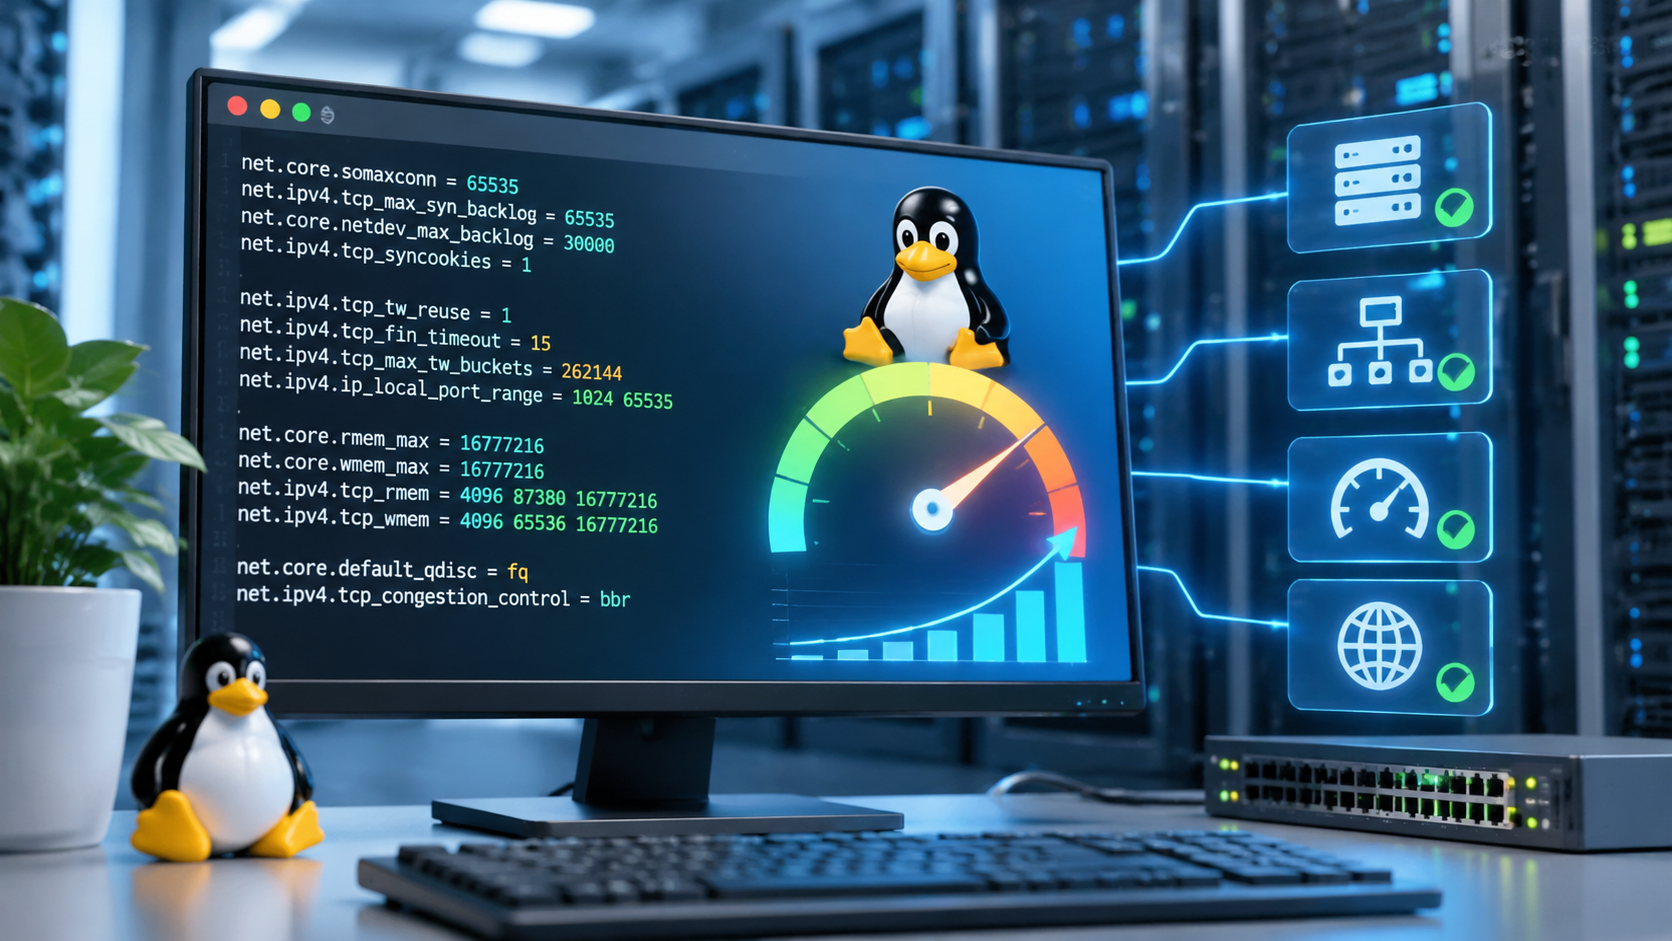
今天我们就抛开那些晦涩的学术理论,从实际生产环境出发,彻底讲透如何对 Linux 内核网络参数进行系统化调优。
一、 解决握手排队:应对突发连接与拒绝服务
当客户端向服务器发起请求时,TCP 握手会先后经过半连接队列(SYN Queue)和全连接队列(Accept Queue)。如果这两个队列太浅,流量稍微突增,客户端就会遭遇连接超时。
1. 撑大连接排队容量
net.core.somaxconn:全连接队列的最大长度。默认值通常是 128 或 4096。面对高并发 Web 服务(如 Nginx、Node.js),建议直接调高到65535。net.ipv4.tcp_max_syn_backlog:半连接队列的最大长度。记录还没完成三次握手的连接,建议同样调整为65535,防止突发流量直接把队列撑爆。net.core.netdev_max_backlog:当网卡接收数据包的速度大于内核处理速度时,允许送到队列的最大数据包数。推荐设为30000或更大。
2. 防御 SYN Flood 攻击
net.ipv4.tcp_syncookies = 1:必须开启。当 SYN 队列满了以后,内核会启用 SYN Cookies 机制,绕过队列直接生成特定 Cookie 响应客户端,能有效抵御小规模的恶意 SYN 洪水攻击,避免正常用户无法建连。
二、 解决连接堆积:拯救卡死的 TIME_WAIT 状态
作为服务端,高并发处理短连接(比如反向代理、大量 API 调用)最容易遇到的问题就是产生海量的 TIME_WAIT 状态连接。它们不仅占用内存,还会迅速吃光本地可用端口。
1. 端口复用与可用范围扩展
net.ipv4.ip_local_port_range = 1024 65535:扩大系统向外发起连接时的可用本地端口范围。默认通常只有 3 万多个,调到最大可以支撑更多的外部或下游连接。net.ipv4.tcp_tw_reuse = 1:允许将处于TIME_WAIT状态的套接字重新用于新的 TCP 连接。需要注意,这只对作为客户端发起的连接生效(例如 Nginx 反代后端)。
2. 缩短等待死亡时间
net.ipv4.tcp_fin_timeout = 15:保持在FIN-WAIT-2状态的时间。默认是 60 秒,改成 15 秒甚至 10 秒,能够让失去响应的连接尽快释放,回收集群资源。net.ipv4.tcp_max_tw_buckets = 262144:系统同时保持TIME_WAIT的最大数量。超过这个数值,系统会直接销毁过剩的连接并打印告警,防止机器被死连接活活拖垮。
三、 提升吞吐带宽:利用 BDP 调优收发缓存
TCP 传输速度的上限由“带宽时延积(BDP = 带宽 × 往返延迟)”决定。想要跑满千兆、万兆网卡,或者提升远距离跨国网络的传输速率,必须给 TCP 分配充足的缓冲区。
1. 读写缓冲区动态调整
Linux 内核具备 TCP 缓冲区自动调优机制,但上限受到系统参数制约。我们可以通过调整三个关键参数的值(最小值、默认值、最大值)来释放性能:
net.ipv4.tcp_rmem = 4096 87380 16777216:TCP 读缓冲区(字节),建议上限拉到 16MB。net.ipv4.tcp_wmem = 4096 65536 16777216:TCP 写缓冲区(字节),建议上限同样拉到 16MB。net.core.rmem_max = 16777216和net.core.wmem_max = 16777216:全局网卡套接字最大读写缓存,必须大于等于上述 TCP 缓冲区的最大值。
运维经验提示:千万不要盲目把单条连接缓存设成几百兆。如果有 10 万并发连接,每个人都吃满 16MB,内存会瞬间爆掉(OOM)。上面的 16MB 是上限,内核会根据实际网络质量动态伸缩。
四、 换上新一代“发动机”:开启 BBR 拥塞控制
老旧的 Linux 内核默认采用 Cubic 拥塞控制算法,这种算法一旦检测到丢包,就会误以为网络拥塞,直接将发包速率减半,在丢包率较高或跨境网络上表现极差。
Google 开发的 BBR 算法不以丢包作为网络拥塞的唯一衡量依据,而是通过实时计算当前链路的最大带宽和最小延迟,精准打满网络带宽。在 Linux 4.9+ 内核之后,可以直接启用:
# 开启fq队列管理机制和BBR拥塞控制算法
net.core.default_qdisc = fq
net.ipv4.tcp_congestion_control = bbr
开启 BBR 后,建连迟钝、高延迟地域访问卡顿的问题通常会立竿见影地得到改善。
五、 生产环境可以直接抄的配置模板
将以下内容直接追加到 /etc/sysctl.conf 文件底部,并执行 sysctl -p 即可立即生效:
# 全连接与半连接队列优化
net.core.somaxconn = 65535
net.ipv4.tcp_max_syn_backlog = 65535
net.core.netdev_max_backlog = 30000
net.ipv4.tcp_syncookies = 1

# 释放与复用 TIME_WAIT 连接
net.ipv4.tcp_tw_reuse = 1
net.ipv4.tcp_fin_timeout = 15
net.ipv4.tcp_max_tw_buckets = 262144
net.ipv4.ip_local_port_range = 1024 65535

# 优化连接保活机制
net.ipv4.tcp_keepalive_time = 600
net.ipv4.tcp_keepalive_intvl = 30
net.ipv4.tcp_keepalive_probes = 3

# TCP 缓冲区与网络窗口优化 (针对大带宽场景)
net.core.rmem_max = 16777216
net.core.wmem_max = 16777216
net.ipv4.tcp_rmem = 4096 87380 16777216
net.ipv4.tcp_wmem = 4096 65536 16777216

# 开启现代化拥塞控制 (需要内核 >= 4.9)
net.core.default_qdisc = fq
net.ipv4.tcp_congestion_control = bbr

# 禁用慢启动重启 (避免空闲连接突然限速)
net.ipv4.tcp_slow_start_after_idle = 0
总结
网络优化绝不是玄学,而是一场内存资源与并发效率的平衡博弈。在实际运维中,除了更新上述内核参数,还需要使用 netstat -s | grep -i listen 查看是否有全连接溢出,利用 ss -s 监控连接状态分布。把底层的 Linux 网络管道彻底疏通,不仅能让服务抗住更高的并发洪峰,更能显著压低页面载入时间,在用户体验和搜索引擎评估中占得先机。
相关文章
- Windows 11关闭后台遥测与自带广告:彻底干掉Win11偷跑流量与流氓广告
- C盘爆满深度清理与迁移技巧:C盘又红了?教你彻底清理与搬家
- 禁用无用Windows服务释放内存:砍掉这几个后台服务立省1G内存
- 开机自启项深度排查与彻底禁用:彻底干掉服务器里的自启动后门
- SSD固态硬盘4K对齐与TRIM优化:服务器SSD太卡?老站长教你调优
- 虚拟内存合理分页文件设置:网站老崩?手把手教你设虚拟内存
- 彻底卸载Windows预装全家桶软件:手把手教你干掉Win自带全家桶
- 注册表无效残留键值清理与修复:电脑老卡死?手把手教你清理注册表
- Chrome浏览器多标签内存占用优化:Chrome开多标签卡死?教你搞定
- 本地DNS缓存清理与网络延迟优化:网站解析老卡?清DNS降延迟实操