
企业内部敏感数据被AI抓取问题:别让AI把公司老底全扒光了
最近这两年,做运维和安全的朋友聚在一起,聊得最多的早不是传统的黑客扫端口,而是企业内部敏感数据被AI抓取问题。很多老板总觉得大模型离自己的业务还很远,或者仅仅是个帮员工写周报的工具,殊不知转头一查,研发写在内网Wiki里的核心算法、财务刚做出来的季度毛利表,甚至法务刚拟定的竞业协议,不知不觉中就被各种公开或半公开的AI爬虫当成了“训练饲料”。大门明明装了防盗锁,窗户却漏了个大窟窿,这才是目前最让人头疼的事。
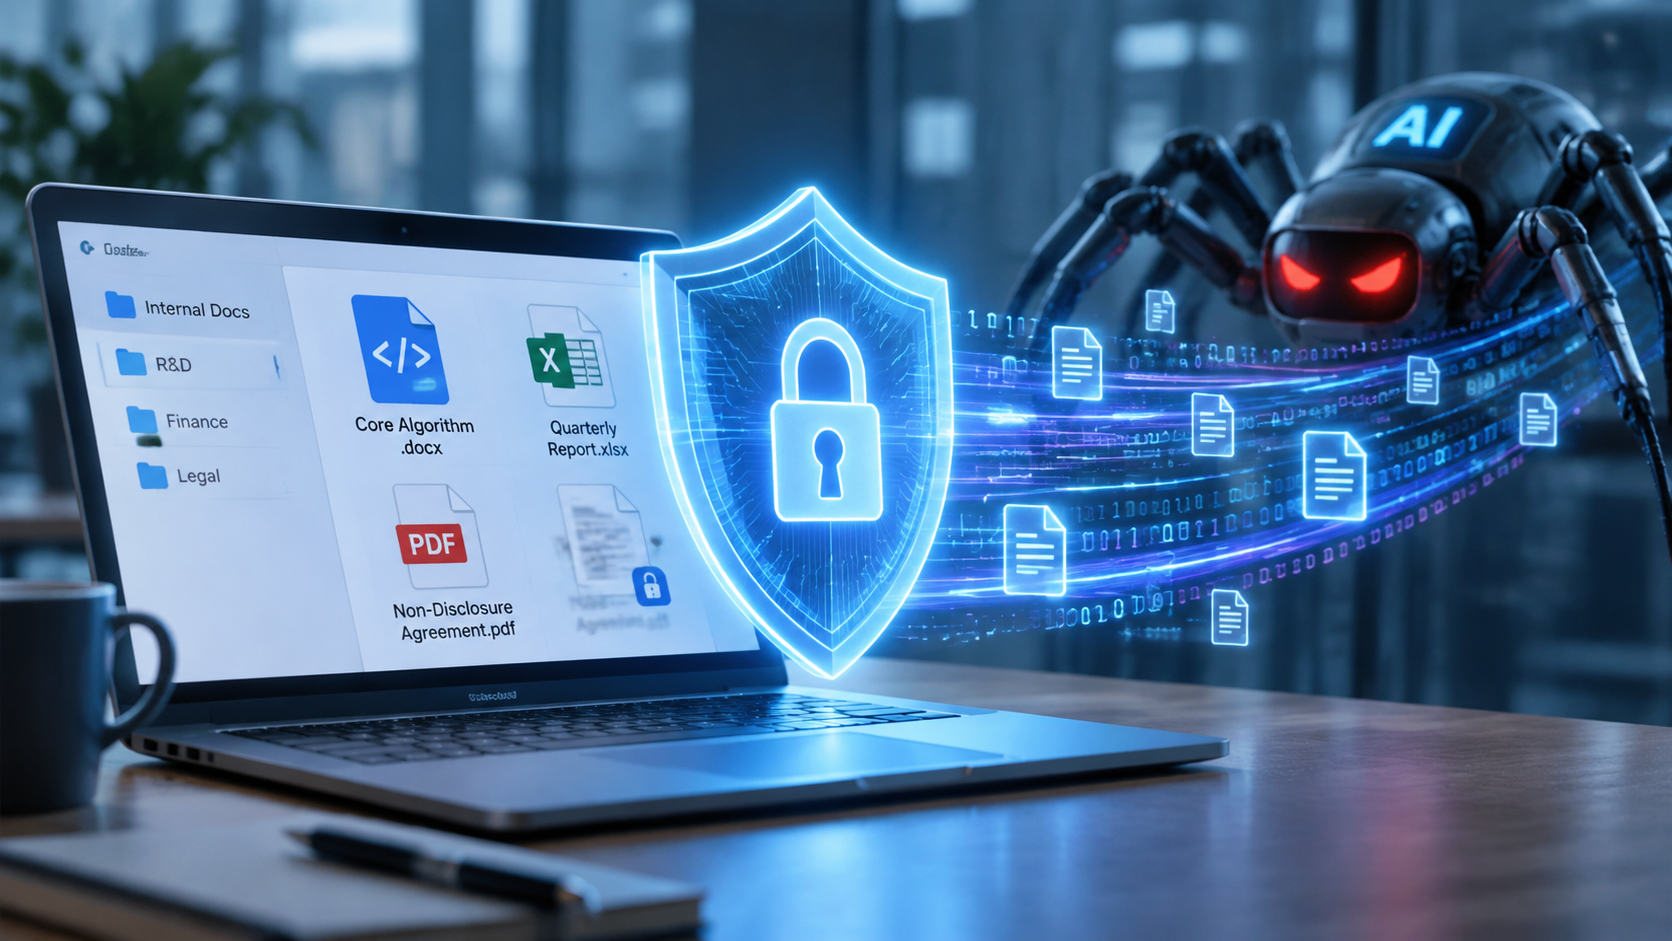
想要彻底解决甚至预防这个问题,光靠行政部门发两封通告是完全没用的。技术人和管理者必须明白数据到底是怎么“溜”出去的,并且得在网络层、应用层和行为层同时下重手。
一、 摸清底细:内网数据到底是怎么被AI盯上的?
别以为你的网站没公开,AI就绝对抓不到。根据我们在实际运维和排查中的经验,内部敏感数据流入大模型的途径通常有这三个“重灾区”:
1. 爬虫越界与开发环境的“灯下黑”
很多开发团队为了图省事,把测试环境、预发平台或者内部文档系统直接挂在公网IP上,甚至只做了一个极其简陋的前端登录拦截。AI爬虫(比如Common Crawl体系、各类商业大模型的爬虫机器人)会顺着历史DNS记录、证书透明度日志(CT Logs)甚至员工在公开网络留下的反向链接直接摸上门。爬虫可不管你是不是测试站,只要接口有泄漏,直接一锅端。
2. 员工的“影子IT”与无意识投喂
这是目前占比最高、也最难防的数据泄漏方式。员工为了提高工作效率,直接将包含客户真实姓名、订单金额的Excel表格,或者包含API Key的代码整段复制到公共的ChatGPT、Claude或者各类国产大模型对话框里。默认情况下,绝大多数消费级AI都会把用户输入的内容留存,并用于下一代模型的迭代训练。这就等同于主动把商业机密双手奉上。
3. 各种第三方的AI插件与扩展程序
浏览器里装的“AI总结网页插件”、IDE里装的“免费AI代码补全扩展”,底层很可能都在静默扫描当前页面的DOM结构或代码上下文。一旦员工在访问公司内网系统时开着这些插件,敏感数据就会随着插件的心跳包或日志直接同步到第三方的模型服务器上。
二、 筑墙堵漏:技术与运维层面的落地解法
既然知道口子开在哪,就必须拿出切实可行的工程手段。以下这几招,建议各位运维和架构师按优先级直接推进:
防护优先级矩阵:
[紧急] 封禁已知AI爬虫 UA/IP -> [核心] 部署出口流量DLP与域名审计 -> [长期] 搭建企业内部AI代理网关
1. 边缘防御:别把希望全寄托在 robots.txt 上
虽然主流合规的AI厂商(如OpenAI、Anthropic)声明会遵守 robots.txt,但合规爬虫只占一部分,更多的是打着通用爬虫旗号洗数据的机器人。
- 基础拦截(合规爬虫):
在全线公网资产的
robots.txt中明确拒绝AI爬虫,例如:User-agent: GPTBot User-agent: ChatGPT-User User-agent: ClaudeBot User-agent: CCBot User-agent: Bytespider Disallow: / - WAF与网关规则(强力拦截): 单纯靠文本协议是防君子不防小人。必须在Nginx、Cloudflare或硬件WAF上配置特征阻断。一旦捕获到包含以上UA特征、且行为模式呈现高频遍历特征的请求,直接丢弃连接(Drop)或返回403。对海外云厂商的无归属机房IP段(如部分针对内部接口穷举的公有云IP),直接实施动态限频或地理位置阻断。
2. 划定边界:彻底物理/逻辑隔离内网服务
排查所有内部系统的DNS解析记录。内网Wiki(如Confluence)、代码托管(如GitLab)、工单系统必须通过零信任访问(Zero Trust)或企业专用VPN接入,严禁通过公网端口映射直接暴露。如果外部供应商必须访问,强制使用双因素认证(2FA)并做源IP白名单限制,防止测试接口沦为公开数据源。
3. 出口管控:掐断内部向外的“投喂通道”
这是解决内部人员泄密的关键抓手:
- DNS与网关封堵: 在公司网关层,对主流消费级AI产品的API域名和网页端进行策略性阻断(如果业务不需要),或者对未经验证的第三方AI工具站点实行DNS拦截。
- 网络DLP(数据泄露防护): 配置出口DLP规则,针对HTTP/HTTPS请求中的POST内容进行实时深度检测(DPI)。重点扫描手机号、身份证号、银行卡号、代码关键字(如
BEGIN PRIVATE KEY、数据库连接串),一旦触发阈值,不仅要告警,还要直接掐断数据传输。
4. 堵不如疏:自建企业级AI中转网关(AI Gateway)
直接全盘封杀AI工具往往会招致业务部门的极度反弹,甚至逼得员工用自己的手机流量偷偷传数据。真正高明的做法是“给大禹治水开渠”:
搭建内部统一的LLM API中转代理服务。要求所有员工只能通过公司内嵌的大模型界面或者内部API使用AI能力。在这个中转网关上集成脱敏插件(Data Masking):
- 当员工把一段日志发给大模型分析时,网关在请求发出前自动利用正则和NLP模型,把其中的IP地址、邮箱、客户名替换成占位符(如
[USER_01]); - 等大模型返回结果后,网关再逆向还原成真实数据呈现给员工。
- 同时,企业与AI供应商必须签署企业级SLA协议,确保所有交互数据不进入公共训练集。
三、 SEO视角与技术常识答疑(FAQ)
在日常落地执行中,很多技术负责人和站长还会遇到以下模糊地带,这里以问答形式梳理清楚:
Q1:我们的公开业务页面如果彻底屏蔽AI抓取,会影响网站在Google或百度的自然搜索排名吗?
答: 这是典型的认知混淆。负责搜索引擎排名的爬虫(如 Googlebot、Baiduspider)与专门抓取数据用于AI训练的爬虫(如 GPTBot、CCBot)在User-Agent和IP段上通常是分开的。只要你精准拦截AI抓取UA,而不去屏蔽主流搜索引擎的SEO检索蜘蛛,对网站的传统搜索排名是没有任何负面影响的。相反,合理的爬虫拦截还能大幅节省服务器带宽和CPU资源,让真正的搜索蜘蛛抓取更顺畅。
Q2:小团队没有预算买昂贵的DLP设备,怎么低成本落地防御?
答: 抓住两个核心点:第一,在网络出口使用开源的网关系统(比如OpenWrt、pfSense)做DNS级别的拦截,把常见的野生AI网站直接解析到内网黑洞页面;第二,浏览器环境治理,在域控(AD域)或企业微信/飞书中统一下发Chrome/Edge策略,强制禁止安装未经IT审核的浏览器插件,这一招能封堵掉大半偷摸回传数据的流氓扩展。
四、 总结
对抗AI抓取企业数据,本质上不是一场“技术炫技”,而是一场对企业自身数字资产梳理深度的全面大考。AI不是洪水猛兽,但在给它开门之前,你必须确保门后的保险柜已经上了双重密码。把公网测试接口收拢、在网关处设卡、给员工一套既能用又安全的安全AI工具,企业才能在这波智能化浪潮里站稳脚跟,而不至于某天早上醒来,发现自家的商业底牌成了全世界大模型脱口而出的“标准答案”。
相关文章
- AI自动生成PPT工具实测:站长实测:AI做PPT别再踩坑了
- Coze接入飞书搭建业务Bot:Coze接飞书搭业务Bot实操
- AI批量提取扫描件PDF数据:AI提取扫描件PDF数据实操
- AI批量清洗去重客户名单:名单去重与站长文案实操指南
- Cursor辅助编写日常运维脚本:Cursor写运维脚本实操指南
- 开源AI录音转文字私有化部署:搞定本地语音转文字与站长写作
- AI一键生成业务流程思维导图:老站长教你用AI秒画业务流程图
- AI自动审查合同关键条款风险:老站长聊AI审合同的避坑实操
- Claude长文本快速提炼行业报告:老站长用Claude啃透行业报告
- AI办公数据泄露风险与防范:别乱用AI办公了,数据正在被看光