
AI自动生成Schema结构化数据与FAQ:搞定Schema与FAQ的懒人办法
折腾独立站这五六年,最让我恶心的脏活之一,就是写完几千字的英文评测或产品落地页后,还得对着Google官方那套语法手册一条条手搓JSON-LD代码。市面上不少搞出海培训的张嘴闭嘴就是装RankMath或者Yoast,但那些插件生成的标记千篇一律,想吃深度的长尾词红利根本没戏。现在稍微聪明点的站长,早就跑通了用AI自动生成Schema结构化数据与FAQ的自动化流,直接用脚本批量提取正文核心、生成FAQ并嵌套好精确的JSON-LD,把SERP(搜索结果页)的展示面积撑大一倍。但如果你只是把文章丢给网页版ChatGPT让它“帮我写个FAQ和代码”,我劝你赶紧停手,盲目乱贴格式搞不好第二天Google Search Console(GSC)就会给你发“检测到垃圾结构化数据”的警告信。
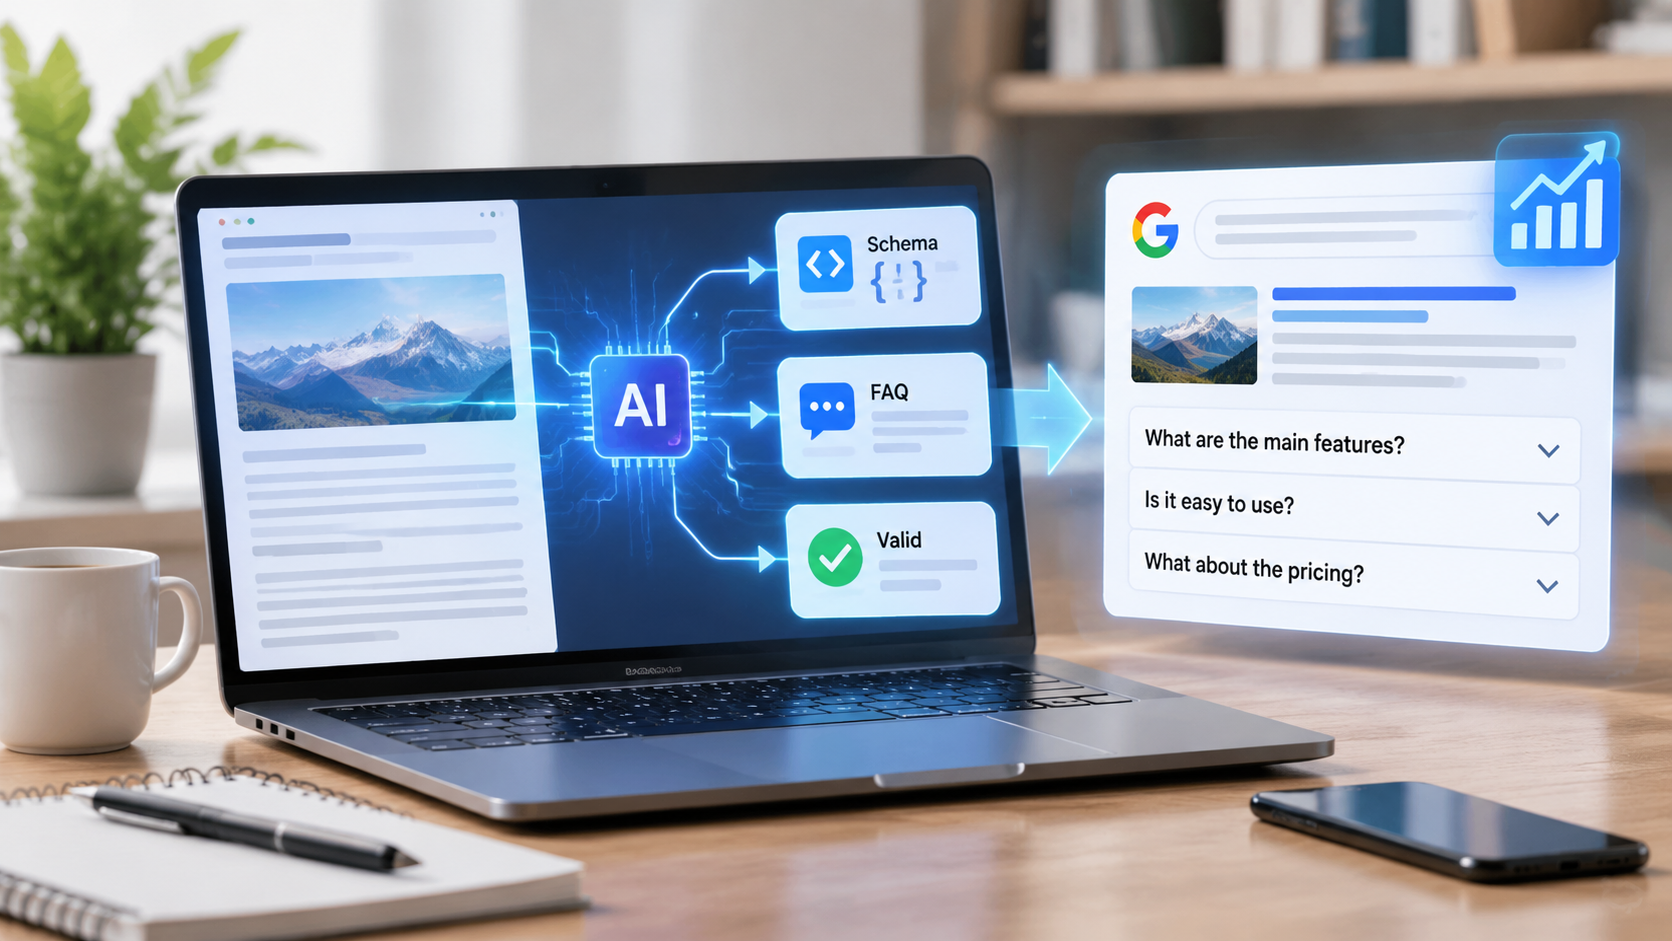
这套活儿到底该怎么干?我把平时跑自动化工作流的实操经验拆出来,不讲虚的概念,直接上落地逻辑。
先说个大实话:别在FAQ上死磕Rich Snippet
有些站长信息滞后,还在做着“贴上FAQPage代码就能在谷歌结果页霸屏四个下拉框”的美梦。醒醒,Google在2023年8月就调整了算法,除了政府和权威医疗类站点,普通商业站的FAQ Rich Snippets展示权重被砍了大半。
那我们为什么还要死磕这套东西?
两个核心目的:
- 抢占PAA(People Also Ask)和AI Overviews的喂料入口:谷歌现在的SGE(生成式搜索)极度依赖网页内部逻辑清晰的Q&A模块,AI抓取你的FAQ直接当作答案引用的概率非常高。
- 复合型Schema提权:我们不仅仅做FAQPage,而是将FAQ作为子属性,嵌套进
Product、Article、SoftwareApplication这类高权重的Schema里。
一、 怎么让AI提取“真正有搜索价值”的FAQ?
多数人让AI生成FAQ,出来的都是这种废话:
Q: What is [Product]? A: [Product] is a great tool for...
这种内容放上去纯粹是浪费爬虫配额,谷歌一眼假。真正能带来转化的FAQ,必须来自真实用户的负向疑虑和长尾搜索意图。
你在写Prompt的时候,必须给AI加强约束:禁止从宏观概念提问,必须从正文的“痛点”、“价格争议”、“兼容性”、“操作门槛”这四个维度挖问题。
建议直接套用的提取Prompt逻辑:
“仔细分析以上文章内容。假想你是一个准备购买/使用该方案但极其挑剔的用户,列出3到5个正文中明确解答过、但在同类文章中容易被含糊带过的实操疑虑(例如:隐性成本、版本兼容、失败排查、具体退款策略)。 提取为严格的Q&A格式,回答必须极度简短、客观,字数控制在40-60词以内,直接给出解决方案,禁止使用‘As mentioned above’等废话套话。”
这样跑出来的FAQ放进页面,用户读了能解惑,搜索引擎看了觉得是干货。
二、 机器直出的JSON-LD,必须解决“代码幻觉”
把FAQ塞进正文只是第一步,接下来是把内容映射成符合schema.org规范的代码。这里是翻车重灾区:AI经常会自己发明一些根本不存在的Schema字段,或者漏掉转义字符导致JSON解析直接报错(500或者前端空白)。
经过生产环境验证的标准化Prompt模版
你是一个精通Google高级SEO的技术专家。请根据上方提取的FAQ内容,以及我提供的文章元数据(Title, URL, Publish Date),生成一段合规的JSON-LD代码。

技术规范要求:
1. 采用Schema.org顶级类型:@type为 Article,并在其 "mainEntity" 属性下嵌套 FAQPage(或直接以复合图谱 @graph 方式呈现)。
2. 每一个Question和Answer的内容必须与正文完全一致,严禁出现正文中未提及的虚假信息。
3. 严格遵循JSON语法,双引号内的特殊符号必须转义,严禁输出任何多余的markdown标记(如 ```json),只输出纯净的代码块。
4. 确保包含 mainEntityOfPage, headline, datePublished, author 字段。拿到输出后,绝对不要跳过验证环节。在自动化流水线里,你必须用程序调取Google官方的Rich Results Test API,或者本地起一个Node.js进程用ajv等库跑一遍Schema校验,返回200且0 warning才准入库。
三、 运维视角:如何把这套流挂到你的独立站上?
很多站长搞自动化,是在WordPress后台装各种臃肿插件,装一个卡一下,数据库被慢查询搞崩。老站长绝对不这么干,性能就是排名,我们尽量在底层搞定。
1. 架构逻辑(解耦处理)
别在前端渲染时让PHP去实时调AI接口(会直接超时的)。把这套逻辑做成异步任务或者利用钩子挂在文章发布后:
- 流程:编辑点发布 -> 触发WebHook -> Python微服务读取正文 -> 调用大模型生成FAQ与Schema -> 回写文章自定义字段(Post Meta) -> 前端模板直出。
2. 代码注入方式(以WordPress或Headless CMS为例)
在主题的functions.php或者你的静态生成器模板里,只要一段轻量代码,把存好的JSON直接吐在</head>之前,或者</body>之前(Google爬虫早就能解析body底部的Schema了,不影响首屏加载速度):
// 极简注入逻辑,拒绝冗余插件
function inject_custom_ai_schema() {
    if (is_single()) {
        global $post;
        // 从自定义字段读取预先生成好的Schema JSON
        $schema_json = get_post_meta($post->ID, '_ai_schema_json_ld', true);
        if (!empty($schema_json)) {
            echo '<script type="application/ld+json">' . $schema_json . '</script>' . "\n";
        }
    }
}
add_action('wp_head', 'inject_custom_ai_schema', 99);
3. Linux定时扫盘与容错
如果你的站群有几万篇历史老文章要洗,直接写个Python脚本走WP-CLI或者REST API扫:
# 核心伪代码逻辑展示(历史数据清洗)
import requests
import json

def process_post(post_id, content):
    # 1. 调本地或云端LLM API生成FAQ及Schema
    faq_data = call_llm_api(content)

    # 2. 格式化并验证JSON
    clean_json = validate_and_format(faq_data)

    # 3. 走REST API更新回站点,不卡前端
    headers = {"Authorization": "Bearer YOUR_JWT_TOKEN"}
    payload = {
        "meta": {
            "_ai_schema_json_ld": clean_json
        }
    }
requests.post(f"https://yourdomain.com/wp-json/wp/v2/posts/{post_id}", json=payload, headers=headers)脚本挂在VPS后台用screen或者tmux跑,加上sleep(2)控频,千把篇文章一晚上就洗完了。
避坑提醒:哪些红线你绝对不能踩?
干外贸SEO久了,见过的死法千奇百怪。在利用AI搞结构化数据时,这两件事碰都不要碰:
-
不可见文本(Hidden Content)作弊: 你生成的Schema里包含了FAQ代码,但是页面前端HTML里根本没有给访客展示对应的FAQ文字模块(很多人为了偷懒,只插
<script>代码不渲染页面文本)。被人工审核(Manual Action)逮到就是100%吃红牌,整站死透。 铁律:Schema里有什么,前台可见区域就必须一字不差地显示什么。 -
滥用评分与评论结构化数据(Review Snippet Spam): AI很喜欢自作聪明在生成Schema时顺带伪造
aggregateRating(例如:评分4.9,基于120条评论)。如果你的页面根本没有用户评价系统,直接被标记为欺诈,连带着FAQ所有的权重一起归零。
把AI当成一个不知疲倦的代码排版工和摘要提炼员,而不是甩手掌柜。把好代码规范和真实性这两道关,你独立站的Rich Snippet点击率,足够甩开同行一条街。
相关文章
- 绕过谷歌AI内容检测实操方法:独立站绕过AI检测实战技巧
- AI内容提高Google EEAT评分实战:靠AI内容拉升EEAT实操经
- Python调用OpenAI批量发布WordPress文章:用Python自动化发WP踩坑实录
- Google核心算法更新打击AI内容应对方案:谷歌算法突袭:老站长AI自救指南
- 纯AI站点被Google降权恢复排查流程:纯AI站被谷歌K站翻盘实战手册
- AI辅助长尾关键词内容矩阵搭建:老站长聊AI长尾内容矩阵实操
- 批量AI重写竞争对手高排名文章技巧:批量重写竞品高排名文章实战指南
- AI生成外贸产品描述SEO优化指南:老站长教你用AI写外贸产品描述
- 结合Search Console用AI翻新老文章排名:老文章没流量?用GSC加AI重写
- AI内容批量清洗与事实错误核查方案:批量洗AI文章与查错实操