
AI角色三视图生成教程:AI角色三视图保姆级实操指南
做AI角色三视图最干脆的方案就是:Stable Diffusion 配合特定的三视图 LoRA 加上 ControlNet 的姿态控制,或者 Midjourney 的 --cref 参数配合多视角关键词。 别指望靠一句 "a character turnaround" 就能出完美模型稿,那纯属撞大运。真正能落地到 3D 建模或游戏原画标准的流程,必须人为干预角色的空间一致性和结构精准度。
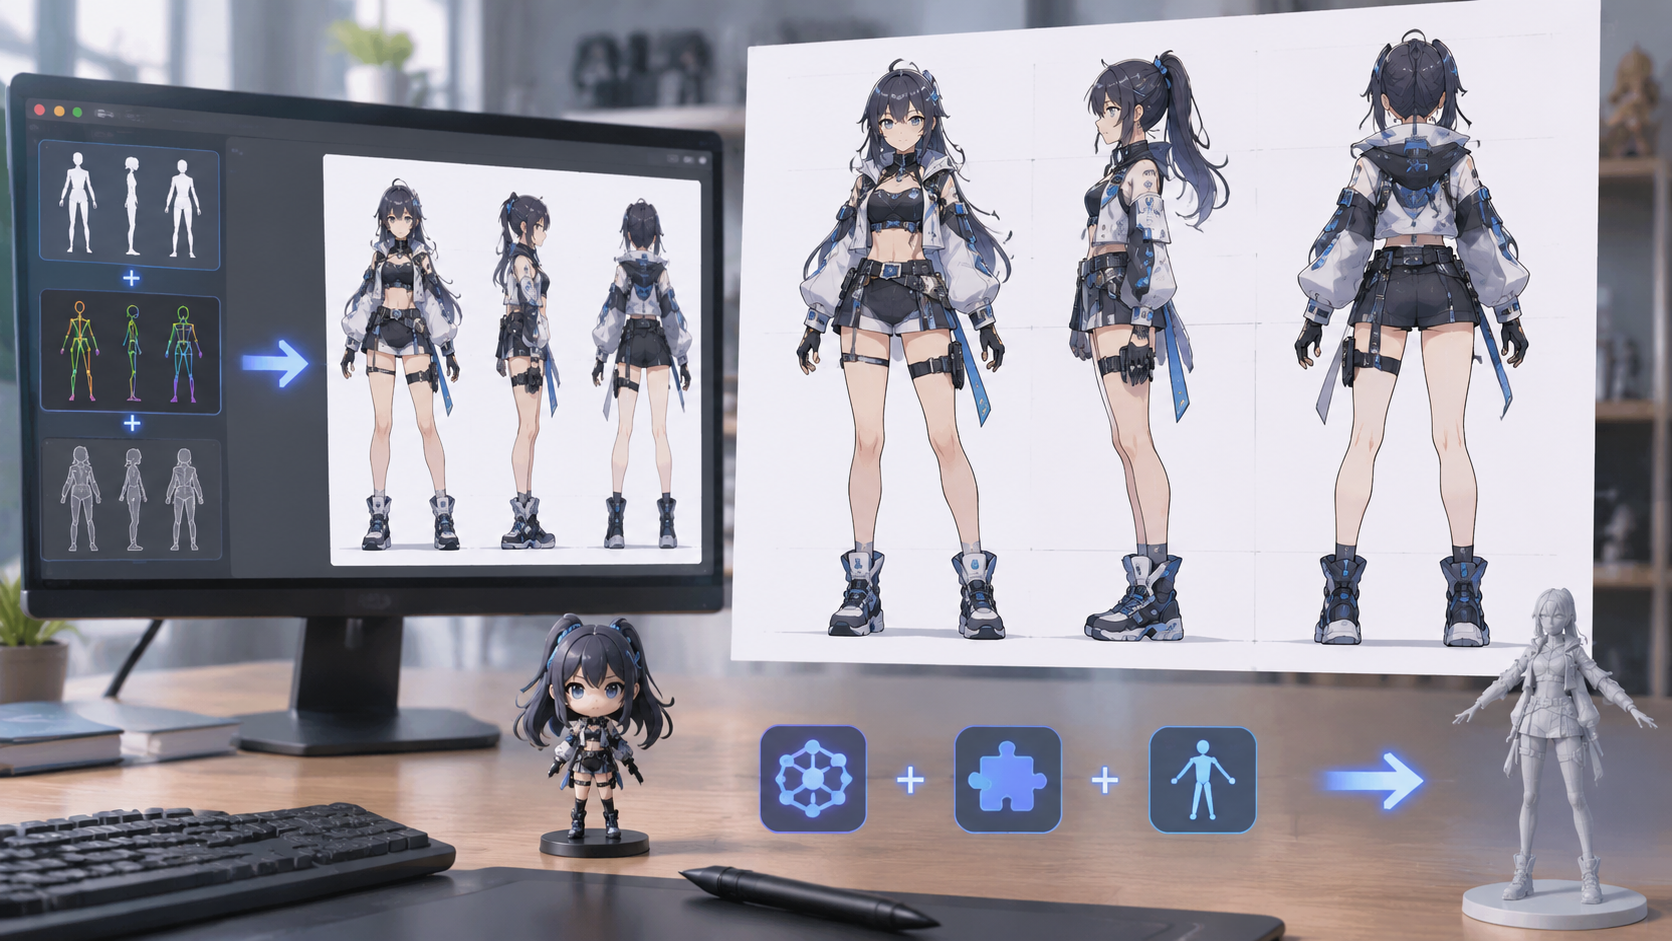
一、 核心方案速览:三条路子怎么选?
在实际干活时,根据你的需求精度,通常有三条路径,我直接把优劣摆在桌面上:
- 最强控制流(Stable Diffusion + LoRA + ControlNet): 适合需要精准还原角色细节、固定服装纹路的情况。优点是改到满意为止,缺点是上手有门槛,得调参数。
- 暴力出奇迹(Midjourney +
--cref+ 角色参考图): 适合前期快速推风格。优点是美感极佳,缺点是背面和侧面的服装细节经常“乱编”,不好控制。 - 插件辅助流(SD WebUI 插件 Charturner): 专门为三视图设计的插件,能强制让画面生成分镜。
二、 实操细节深度拆解:SD 端的全流程控制
作为老兵,我更推荐 SD 方案,因为搞商业落地,确定性高于一切。
1. 环境搭建与模型准备
你手里得有两样核心武器:
- 底模: 选个大模型,比如写实风用
ChilloutMix,二次元用Pony Diffusion V6 XL或Anything V5。 - LoRA: 去 Civitai 搜关键词 "CharTurner" 或 "Three-View"。这类 LoRA 的作用是把扩散分布强制往“站立、平视、多视角”上引。
2. 关键 Prompt(提示词)模版
别乱写,要把描述空间位置的词放最前面。
-
正向词模版:
(orthographic:1.3), (front view, side view, back view:1.2), character sheet, split view, full body, standing, T-pose, white background, masterpiece, [你的角色描述], simple background, highres.- 避坑点:
orthographic(正交投影)和split view(分屏)是灵魂。没有这俩,AI 会给你画个动感十足的姿势,完全没法给 3D 建模参考。
- 避坑点:
-
反向词(Negative Prompt):
lowres, bad anatomy, bad hands, text, error, missing fingers, extra digit, fewer digits, cropped, worst quality, low quality, normal quality, jpeg artifacts, signature, watermark, username, blurry, artist name, (depth of field:1.4), (bokeh:1.4).- 避坑点: 一定要屏蔽掉“景深(depth of field)”和“虚化(bokeh)”,我们要的是清晰的工程图,不是艺术写真。
3. ControlNet 的“物理降维打击”
如果你想让正面、侧面、背面的动作完全对齐,甚至手举起的高度都一致,ControlNet 是必须开的。
- 步骤:
- 找一张现成的三视图姿态图(那种黑色小人,网上到处是)。
- 开启两个 ControlNet 单元。
- Unit 0: 选
OpenPose,导入姿态图。这决定了角色是站着的,且三个视角位置平齐。 - Unit 1: 选
Canny(硬边缘)或Lineart,通过线条约束角色轮廓。
4. 分辨率的玄学
三视图通常是长条形的。
- 推荐尺寸: 1024x512 或者 1536x768。
- 千万别直接开超大: AI 在超长画幅下容易长出两个头。建议先用 1024x512 生成,看满意了再用
Tiles放大或Hires. fix(高分辨率修复)。
三、 Midjourney 端的快速出图策略
如果你觉得 SD 太麻烦,用 MJ 也能硬刚,但要用到去年底刚出的关键参数:--cref (Character Reference)。
- 先出一张满意的正面单人照: 比如
A futuristic female warrior, silver armor, blue glowing eyes, white background --v 6.0。 - 获取该图 URL: 右键复制这张图的链接。
- 生成三视图:
Prompt: A character sheet of a futuristic female warrior, multiple views, front view, side view, back view, standing, white background --cref [图片链接] --cw 100 --ar 3:2 --v 6.0--cw 100: 代表 100% 还原参考图的角色特征(包括衣服、头发)。如果设为 0,只还原脸。
四、 高频关联问题与“避坑”锦囊
1. 为什么正反面的衣服花纹对不上?
这是 AI 生成的通病。目前的底层原理是像素预测,它不理解“空间一致性”。
- 实操方案: 如果正反面差太多,在 SD 里用 Inpaint(局部重绘)。把背面的花纹涂掉,在提示词里加
back view, mechanical gear pattern重新刷。或者直接导进 Photoshop 手动对齐,毕竟咱们是搞技术的,工具不嫌多。
2. 手指和脚部糊成一团怎么办?
长条状的三视图中,角色占画面比例小,AI 对局部像素的渲染力不够。
- 解决方案: 勾选 ADetailer 插件。设置两个 ADetailer 单元,一个选
face_yolov8n.pt修复脸,一个选hand_yolov8n.pt修复手。它会自动检测画面里的小手并局部高分重建。
3. 生成的角色“飘了”,脚没踩在一条线上。
这种情况后期做 3D 骨骼绑定会想死。
- 避坑点: 检查提示词里有没有
floating(悬浮)或dynamic action(动态动作)。在 ControlNet 里强制使用Lineart并在底部画一条水平直线作为引导,强迫 AI 把脚画在直线上。
4. 推荐一个“懒人专用”Lora 配置(SD):
- LoRA:
charturnerbeta-v1-02(权重 0.6-0.8) - Trigger Word:
charturner, multiple views, character sheet - 采样器:
DPM++ 2M Karras或Euler a(步数建议 30 步以上,保证细节稳固)。
五、 总结与进阶思路
搞定 AI角色三视图 不是靠玄学抽卡,而是靠约束。
- 初阶: 靠
Split view关键词抽奖,运气成分占 80%。 - 中阶: 靠
LoRA+ControlNet约束,产出基本能看,改改能用。 - 高阶: 先生成高清单视角图,再利用
IP-Adapter结合姿态控制图,强制复刻角色基因到三视图模版中。
最后吐个槽: 别迷信那些所谓的“AI全自动化建模”。现在最稳妥的工业链路依然是:AI生成三视图 -> PS修正不对称细节 -> 丢进 Tripo AI 或 Rodin 生成粗模 -> 进 Blender 精修。 只有这种半自动化的流程,才能真正交差拿钱。
如果你在跑图中遇到角色“四肢错位”或者“正面穿甲、背面穿裙子”的灵异事件,九成是因为你没用 ControlNet 做空间锁定。去把那几个模型下好,别想着用纯 Prompt 解决一切。