
智谱GLM图片反推提示词:智谱GLM图片反推Prompt实战
使用智谱GLM图片反推提示词,核心就一句话:别直接丢图问“这是什么”,必须给模型套上强约束的结构化解析模板,直接把它榨成可供 Midjourney 或 Stable Diffusion 直出的中英文高质量 Prompt。很多同行跑去花钱买各种反推工具,或者用 CLIP 跑出一些稀碎且不通顺的单词碎片,其实直接用智谱的多模态大模型(GLM-4V 系列),无论在中文语义理解还是复杂画面构图解析上,成本和效果都远超那些封装套壳工具。
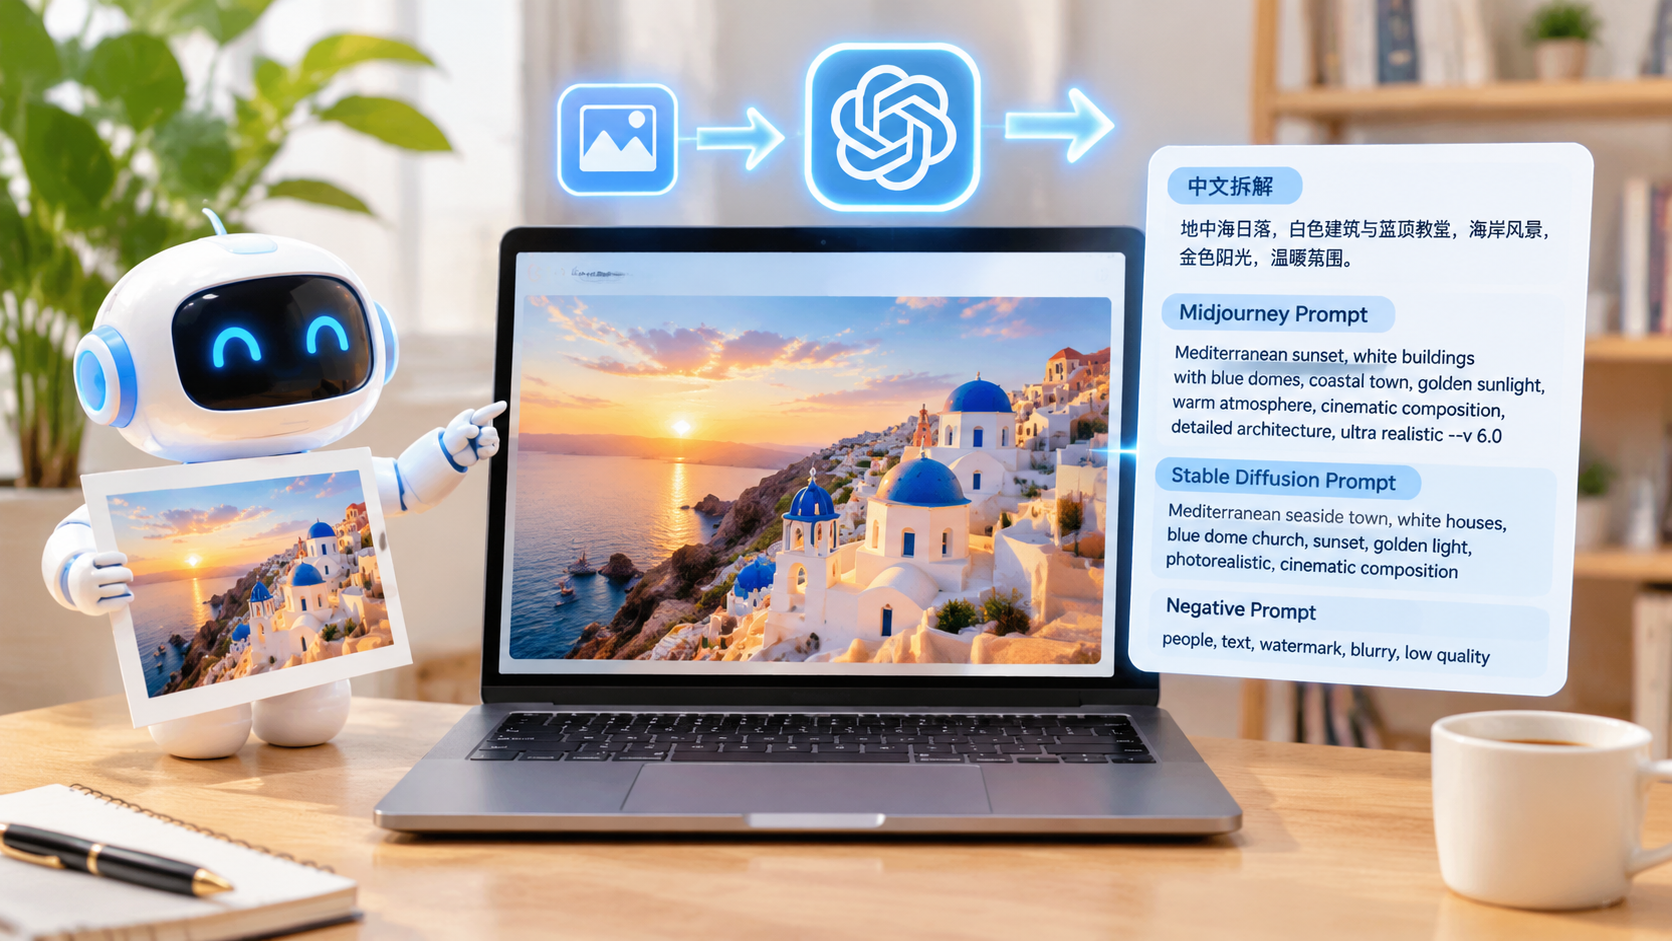
核心方案速览
智谱GLM的视觉能力(GLM-4V-Plus / GLM-4V)具备极强的空间细节捕捉与艺术风格识别能力。反推提示词的核心逻辑是:图片输入 -> 角色/主体拆解 -> 环境/光影拆解 -> 风格/媒介定义 -> 格式化输出为绘图专用格式。
- 适用场景:电商爆款主图复刻、二次元插画风格提取、老图高清重绘构图提取、影视级场景概念设计还原。
- 主流路径:
- 极客/开发者:调用官方开放平台 API,使用 Python 脚本批量自动反推并清洗,直接存入数据库或接入生图 WebUI。
- 设计师/运营人员:直接在智谱清言网页端/客户端,投喂结构化约束 Prompt 进行单图/多图提取。
实操细节深度拆解
1. 核心反推 Prompt 模板设计(防翻车关键)
如果直接问“帮我提取这幅图的Midjourney提示词”,GLM 会像个文科生一样给你写几百字充满修辞色彩的小作文,这种内容丢进 MJ 基本上直接报废。必须对其进行强格式限制。
直接套用的反推指令模版(通用增强版):
你现在是一个顶级的 AI 绘画提示词专家(精通 Midjourney 和 Stable Diffusion 原理)。请仔细观察我上传的图片,将其逆向解析为可直接用于绘图的高精度提示词。

请严格按照以下维度进行结构化拆解:
1. 主体(Subject):主体的种类、外观细节、姿态、表情、服饰特征。
2. 构图与视角(Composition & View):镜头景别(特写/全景)、拍摄视角(俯视/仰视/平视)、构图法则(对称/三分法/黄金分割)。
3. 环境与背景(Environment & Background):场景细节、空间层次、天气、氛围元素。
4. 光影与色彩(Lighting & Color):主光源方向、光质(柔光/硬光/体积光)、主色调、色彩饱和度与对比度。
5. 艺术风格与媒介(Style & Medium):渲染引擎(如 Unreal Engine 5)、艺术流派(如赛博朋克、吉卜力风、超现实主义)、画风材质(如油画、水彩、3D粘土、宝丽来胶片质感)。

输出要求:
- 先给出【中文拆解描述】,方便我核对细节。
- 接着给出【Midjourney 英文提示词】,将上述要素提取为高质量英文短语,用英文逗号分隔,末尾加上适宜的版本和比例参数(例如 --ar 16:9 --v 6.0)。
- 最后给出【Stable Diffusion 英文正向提示词】和建议的【通用负向提示词】。
- 严禁输出空洞无意义的废话和主观抒情,只保留视觉事实。
2. Python 自动化调用实操代码
对于需要批量处理图库、搞资产复刻的团队,走 API 是唯一靠谱的路子。目前推荐使用智谱官方的 zhipuai SDK。
环境准备:
pip install zhipuai完整落地脚本(支持本地图片 Base64 编码上传与反推):
import base64
import os
from zhipuai import ZhipuAI

# 填入你的智谱 API Key,或者配置在环境变量中
client = ZhipuAI(api_key=os.environ.get("ZHIPUAI_API_KEY", "your_api_key_here"))

def image_to_base64(image_path: str) -> str:
    """将本地图片转换为Base64编码"""
    with open(image_path, "rb") as image_file:
        return base64.b64encode(image_file.read()).decode('utf-8')

def reverse_image_prompt(image_path: str):
    """通过智谱GLM-4V反推图片提示词"""
    if not os.path.exists(image_path):
        raise FileNotFoundError(f"找不到图片: {image_path}")

    img_base = image_to_base64(image_path)

    # 构建结构化解析 Prompt
    system_instruction = (
        "你是一名资深AI绘画提示词工程师。你的任务是分析传入的图片,"
        "将其深度逆向工程为Midjourney专用的英文Prompt。输出格式要求如下:\n"
        "[画面拆解]:中文简述画面核心主体与风格\n"
        "[MJ_Prompt]:直接输出英文提示词,要素包括主体细节、场景、光影、艺术风格、摄影机参数,用逗号连接,末尾默认带上 --v 6.0"
    )

    try:
        response = client.chat.completions.create(
            model="glm-4v-plus",  # 如果追求高性价比可用 glm-4v
            messages=[
                {
                    "role": "user",
                    "content": [
                        {
                            "type": "text",
                            "text": system_instruction
                        },
                        {
                            "type": "image_url",
                            "image_url": {
                                "url": img_base
                            }
                        }
                    ]
                }
            ],
            top_p=0.7,
            temperature=0.3  # 降低温度,避免模型胡思乱想,保证描述精准性
        )
        return response.choices[0].message.content
    except Exception as e:
        print(f"调用报错: {str(e)}")
        return None

if __name__ == "__main__":
    test_img = "test_product.jpg"
    print("正在反推提示词,请稍候...")
    result = reverse_image_prompt(test_img)
    print("\n========== 反推结果 ==========\n")
print(result)避坑提示:
- 温度(temperature)别设太高:反推图片要的是“实事求是”,建议设定在
0.2 - 0.4之间。如果设到0.8以上,模型会开始过度脑补画面里根本不存在的细枝末节。 - 图片体积与分辨率控制:别直接把 20MB 的相机原图往接口送。不仅传得慢耗费网络 I/O,还容易触发客户端超时。输入前用 PIL 库等比压缩到长边不超过 2048 像素,体积控制在 2MB 内,对 GLM-4V 的解析精度没有任何负面影响。
高频关联问题拓展
1. 反推出来的 Prompt 生成新图时“货不对板”怎么办?
很多人以为反推出来的词直接丢给 Midjourney 就能一比一复刻,这是对扩散模型的机制有误解。
- 原因:GLM 解析的是“像素语义”,而生图工具看重的是“权重和语义触发词”。
- 解法:在拿到的 Prompt 基础上做减法。去掉次要的环境形容词,强化核心主体词。若要复刻特定风格,把 GLM 给出的普通形容词(如
japanese anime style)替换为该风格代表艺术家的名字或特定工作室标签(如Studio Ghibli style, Makoto Shinkai style)。
2. 识别文字和特定版式时出现幻觉
如果图片中含有海报设计、文字排版、特定 Logo:
- 现象:模型会尝试把英文字母逐个翻译或者拼凑成怪异句子。
- 解法:在指令中明确追加:
如果图片中包含排版文字或海报设计元素,请忽略具体文字内容,仅提取排版构图方式(如:minimalist typography, poster design layout, magazine cover style)。
3. 批量化反推时的并发与费用优化
- 如果只是个人搞十几张图,直接上
glm-4v-plus,解析能力顶格。 - 如果是建站需要批量清洗成千上万张商品图、壁纸图,全部用 Plus 成本吃不消。建议先用基础版
glm-4v跑一遍,或者本地跑一个轻量级的 CLIP 初筛打标,只有遇到画面元素丰富、构图复杂的重点图片,才用路由逻辑分流给智谱 GLM 进行精细反推。
总结
在现阶段的生图工作流中,利用智谱GLM图片反推提示词是最省心且兼顾本土语义理解的方案。它彻底解决了开源打标工具(如 DeepDanbooru、BLIP)语义破碎、缺少全局审美逻辑的硬伤,也免去了配置本地昂贵显卡算力的麻烦。只要拿捏好 Prompt 的结构化约束,把温度值压低,不管是做批量图像资产复刻,还是搭建全自动生图工作流,这套链路都可以无缝嵌入到实际业务中稳定产出。