
百度搜索资源平台教程:百度搜索资源平台实操避坑指南
搞网站做流量,使用百度搜索资源平台最核心的目的就三个:搞定站点验证、接入 API 自动化推送、排查蜘蛛抓取异常,别去花时间研究平台里那些早就废弃或者虚头八脑的边缘指标。只要你在网站上线当天把站点验证做好,拿到 API 推送接口,并在服务器侧配置好定时自动推送脚本,新产出的页面最快几分钟就能进入百度蜘蛛的待抓取队列。
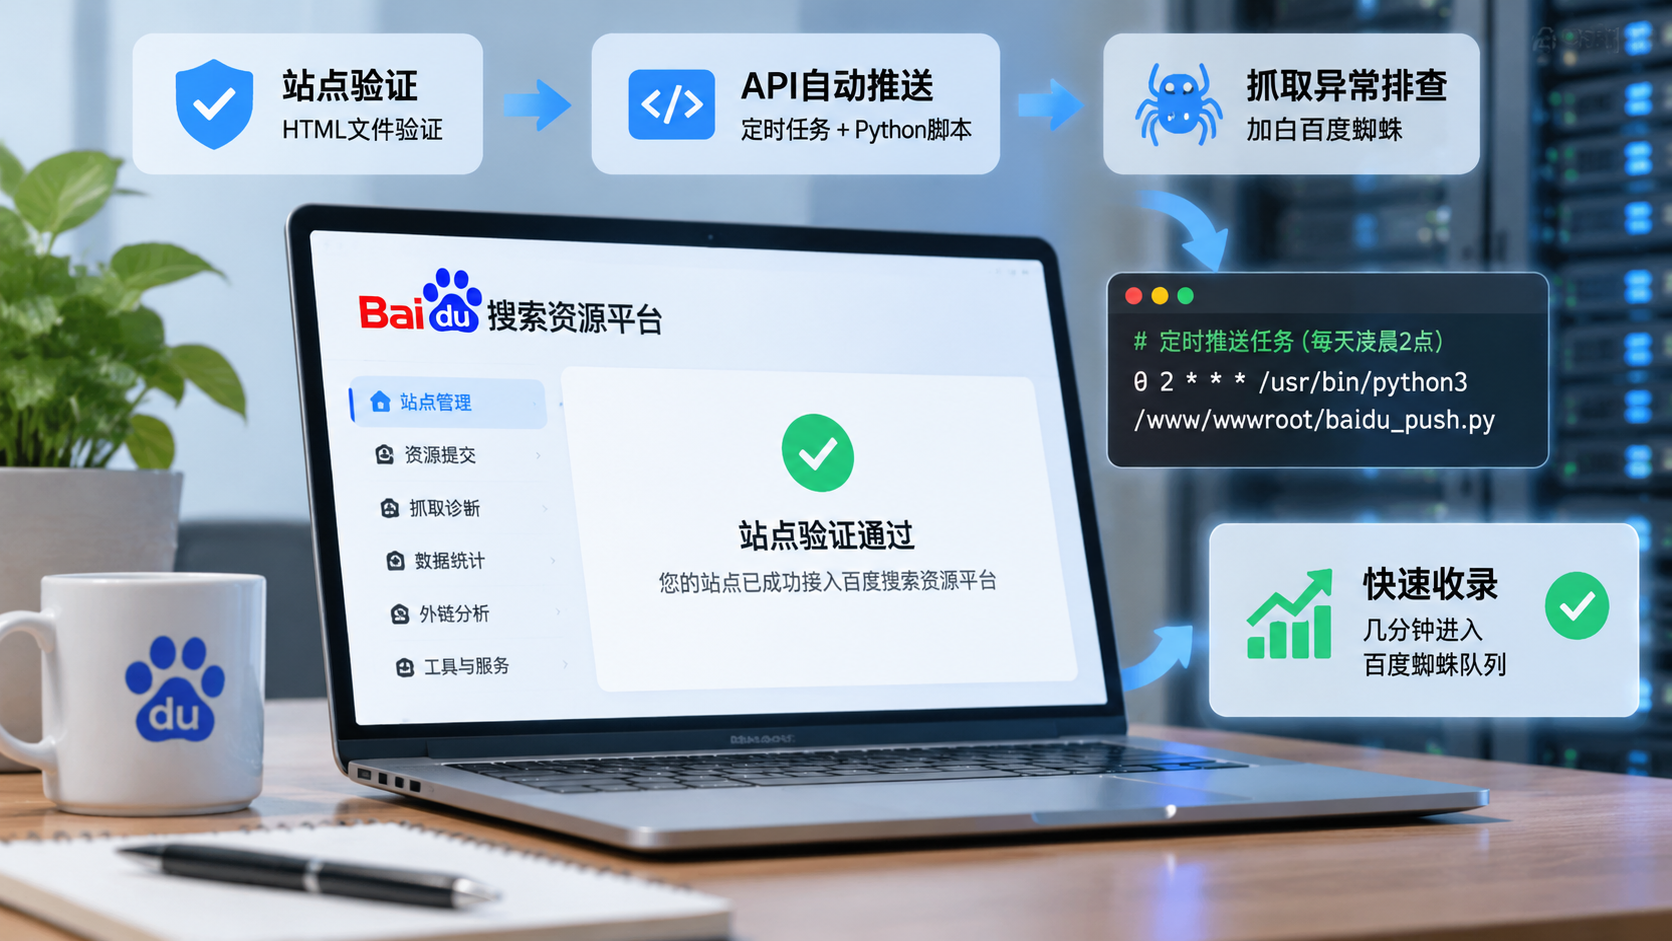
很多新手站长和运维经常踩坑:要么是天天手动去复制 URL 提交,要么是服务器设置了防火墙把百度蜘蛛当成恶意爬虫给封了,导致搞了半个月收录还是个零。这篇文章不讲任何生硬的理论,直接给你硬核的自动化代码、服务器 Nginx 配置以及抓取异常排查流程,照着搬就能用。
核心方案速览
想要彻底发挥百度搜索资源平台的价值,避开 90% 的低效盲目操作,你只需要按顺序完成以下 5 个关键动作:
- 站点快速验证:优先采用 HTML 文件验证 方式,直接丢到网站根目录,不动 DNS,不侵入源码。
- 打通自动推送:放弃平台页面上的手动单条提交,直接写 Python 或 Shell 脚本接入 API 推送接口,挂载到 Crontab 定时任务。
- 抓取环境清障:在服务器防火墙/WAF 中将 Baiduspider 加白,确保 Nginx 不会对百度蜘蛛返回 403 或 506 限制。
- 诊断定位问题:使用平台“抓取诊断”工具,如果显示“抓取失败”,优先排查 HTTPS 证书链完整性和 TLS 协议版本。
- 死链闭环处理:页面下架时必须返回 404 状态码,并生成 txt 死链清单提交给平台,避免全站权重被扣减。
实操细节深度拆解
1. 站点验证:最稳妥的挂载方式
进入百度搜索资源平台添加站点时,平台提供文件验证、HTML标签验证、CNAME验证三种方式。
- 避坑指南:千万别用 CNAME 验证。如果你接了 Cloudflare 等 CDN 或使用了双线解析,CNAME 极其容易失效导致平台取消你的站点权限。
- 最佳实践:选择 HTML文件验证。下载平台给定的
baidu_verify_xxx.html文件,直接扔进网站根目录。
Nginx 验证文件透传配置(防止被伪静定向或路由拦截): 如果你用的是 Laravel、Node.js、Vue SSR 等重路由框架,根目录放文件可能访问不到(直接报 404),需要在 Nginx 里加一行硬规则:
# 确保百度验证文件直接读取本地文件,不经过后端框架路由
location ~ ^/baidu_verify_.*\.html$ {
    root /www/wwwroot/your_site/; # 替换为你网站的绝对路径
    access_log off;
}
2. API 推送自动化:用脚本代替人工
手动在百度搜索资源平台的网页端提交 URL 既费时又有限制。利用平台提供的普通收录 API 接口,配合服务端自动化脚本,才是正道。
以下是一段可直接落地的 Python3 生产级推送脚本,它会自动解析你网站的 sitemap.xml,提取最新的 URL 并推送到百度:
import requests
import xml.etree.ElementTree as ET
import sys

# ===== 配置区域 =====
# 百度搜索资源平台给你的 API 推送地址(在:普通收录 -> 资源提交 -> API提交 中获取)
BAIDU_API_URL = "http://data.zz.baidu.com/urls?site=https://www.yourdomain.com&token=YourToken123456"
SITEMAP_URL = "https://www.yourdomain.com/sitemap.xml"

def get_urls_from_sitemap(sitemap_url):
    """解析 Sitemap 提取所有 URL"""
    try:
        response = requests.get(sitemap_url, timeout=10)
        if response.status_code != 200:
            print(f"[错误] 获取 Sitemap 失败,状态码: {response.status_code}")
            return []

        root = ET.fromstring(response.content)
        # 处理 xml 命名空间
        namespaces = {'ns': 'http://www.sitemap.org/schemas/sitemap/0.9'}
        urls = [elem.text for elem in root.findall('.//ns:loc', namespaces)]
        return urls
    except Exception as e:
        print(f"[异常] 解析 Sitemap 失败: {str(e)}")
        return []

def push_to_baidu(urls):
    """推送 URL 列表到百度 API"""
    if not urls:
        print("[提示] 没有待推送的 URL")
        return

    headers = {'Content-Type': 'text/plain'}
    data = "\n".join(urls)

    try:
        res = requests.post(BAIDU_API_URL, data=data, headers=headers, timeout=15)
        result = res.json()

        # 解析百度返回结果
        if "success" in result:
            print(f"[成功] 成功推送 {result['success']} 条 URL")
            print(f"[信息] 今日剩余可推送额度: {result.get('remain', '未知')}")
        else:
            print(f"[失败] 百度 API 返回错误: {result}")
    except Exception as e:
        print(f"[异常] 请求百度 API 失败: {str(e)}")

if __name__ == "__main__":
    url_list = get_urls_from_sitemap(SITEMAP_URL)
    # 取最新的 100 条推送(根据你的百度每日额度调整)
push_to_baidu(url_list[:100])部署方案:
将脚本保存为 baidu_push.py,在 Linux 服务器终端里设置 Crontab 定时任务,每天凌晨 2 点自动运行:
0 2 * * * /usr/bin/python3 /www/scripts/baidu_push.py >> /www/scripts/baidu_push.log 2>&13. 抓取诊断与蜘蛛放行
在百度搜索资源平台提交完 URL 之后,很多人的页面依然不收录,去“抓取诊断”工具里测一下,往往会提示 抓取失败 或 HTTP 状态码异常。
典型排查思路:
- User-Agent 拦截:很多服务器防 CC 攻击脚本或 CDN 默认封禁了不带标准 Header 的请求,或者误封了
Baiduspider。 - HTTPS 握手失败:服务器禁用了 TLS 1.2 以下协议,或者 SSL 证书链缺失中继证书,导致百度的老旧蜘蛛无法建立安全连接。
Nginx 侧放行 Baiduspider 的配置示例:
# 识别百度蜘蛛 UA
map $http_user_agent $is_baidu_spider {
    default 0;
    ~*Baiduspider 1;
}

server {
    listen 443 ssl http2;
    server_name www.yourdomain.com;

    # SSL 协议配置:必须包含 TLSv1.2 和 TLSv1.3,否则百度蜘蛛极易抓取失败
    ssl_protocols TLSv1.2 TLSv1.3;
    ssl_ciphers ECDHE-RSA-AES128-GCM-SHA256:HIGH:!aNULL:!MD5:!RC4;

    location / {
        # 如果是百度蜘蛛,绕过速率限制(假设你配置了 limit_req)
        if ($is_baidu_spider = 1) {
            # 允许继续执行,不走防刷逻辑
        }

        # 正常的网页处理...
        proxy_pass http://127.0.0.1:3000;
    }
}
4. 死链提交:防止全站扣分
当网站改版或删除了大量失效页面时,直接删页面留着 404 不管是非常危险的。百度搜索资源平台的死链提交机制要求极其严格:提交的 URL 必须在访问时真实返回 404 状态码,平台再去验证时才会从索引库清理。
标准处理流程:
- 收集网站所有已下架的 URL,写入一个静态文件
deadlinks.txt。 - 确保在浏览器访问
deadlinks.txt里的 URL 时,HTTP 响应状态码为 404 Not Found,而不是 200(比如跳转到了首页或提示“页面不存在”但状态码是 200 的软 404)。 - 在百度搜索资源平台 -> 死链提交 模块,将
deadlinks.txt的访问路径提交上去(如:https://www.yourdomain.com/deadlinks.txt)。
高频关联问题拓展
Q1:为什么我的百度 API 推送额度只有 10 条/天?
这是百度搜索资源平台对新站或低权重站点的风控机制。平台会根据站点的历史抓取表现、内容原创度、用户体验评分动态调整额度。
- 解决方案:不要试图刷接口。保持天天有优质原创更新,且脚本每日稳健推送,通常 1-3 个月内额度会从 10 增至 2000 甚至上万。
Q2:抓取诊断成功,但网页就是不上索引也不给收录?
“抓取成功”仅代表百度的网络爬虫成功把你的 HTML 源码拉到了百度的服务器,不代表页面能通过内容质量审核。
- 排查思路:
- 检查网页的渲染模式。如果是纯前端渲染(React/Vue 且未做 SSR/预渲染),百度蜘蛛拿到的是一个空的
<div id="app"></div>,会被认定为空白页。 - 检查文本重复度。如果页面内容大部分是从其他网站搬运的,内容过滤系统会自动丢弃。
- 检查网页的渲染模式。如果是纯前端渲染(React/Vue 且未做 SSR/预渲染),百度蜘蛛拿到的是一个空的
Q3:平台提示“DNS解析失败”或“连接超时”?
如果抓取诊断偶尔报这个错,通常是国内 CDN 节点波动或 DNS 服务商(如 DNSPod、阿里云解析)拦截了百度的查询请求。
- 解决方案:在服务器终端使用
dig或nslookup检查解析情况。在 CDN 管理后台检查是否启用了“区域封禁”或“IP黑名单”,切忌封禁百度蜘蛛经常调用的 DNS 节点。
总结
使用百度搜索资源平台的核心逻辑其实非常纯粹:别去折腾所谓的“快速收录黑科技”,把基础的技术通路打通即可。
验证站点选 HTML 静态文件,推送交给 Python 脚本结合 Sitemap 实现每日全自动Post,服务器侧做好 Nginx 对 Baiduspider 的放行与 HTTPS 协议兼容,页面下架做好标准 404 状态码响应与死链清单提交。搞定这一套工业化的标准运维流程,剩下的事情只需要交给时间,安心做好网站的内容与产品体验即可。